{"version": "l07-teaching-v14-20261102", "format": "markdown", "html": "handbook.html", "content": "# 搜索、推理与验证|现行学生学习正文\n\n\n\n这份正文承接 L05 的模型计算与 L06 的训练能力,解释为什么固定参数的模型仍需要本次求解,以及如何把更多计算变成有效信息。先读八个问题,再按课堂位置深入。\n\n课堂分页与搜索树是教学构造;标明作者与论文版本的图表是原始研究;Deepnote 的运行是机制实验,不能直接替代大模型训练或真实网络测量。正文包含解释与练习核对,建议先在课堂或 Notebook 中写下预测再阅读答案。\n\n\n\n## 按问题阅读\n\n- [已经会写代码,为什么还需要把这一次算出来?](#R1)\n\n- [好答案在哪里丢掉了?先辨认生成和选择的瓶颈](#R2)\n\n- [测试通过以后,究竟知道了什么?](#R3)\n\n- [同一个检查结果,送回上下文、筛选样本、用于训练有什么不同?](#R4)\n\n- [结果反馈能教会模型怎样求解吗?](#R5)\n\n- [能把工作交出去以后,为什么还要看过程和证据?](#R6)\n\n- [一次超时,能证明服务没有完成吗?](#R7)\n\n- [下一笔计算预算,投在哪里才有信息量?](#R8)\n\n\n\n## R1 · 已经会写代码,为什么还需要把这一次算出来?\n\n预训练形成的参数保存了大量可复用的能力,但不会预先存好每个新输入的结果。会使用 Python 的规则,与能在这一次准确追踪 `range` 的边界,是两个问题。参数 θ 可以保持不变;模型每生成一个片段,当前上下文就多了一段,下一步读取的材料随之改变。本次推理计算因此能增加,而不必在使用时更新参数。\n\n回到分页例子:先写下 `n=5, size=2`,再展开起点 0、2、4,比直接猜“有三页”多了可检查的中间状态。这不是增加外部事实;如果服务实际返回了什么尚不知道,再长的推演也不能替代观测。\n\n### 2021:能不能让模型学会使用草稿?\n\nNye 等的 *Show Your Work* 研究让模型在答案前输出中间计算;训练样本中包含这些过程。scratchpad 指可供后续计算读取的工作区或过程表示,内容可以是程序执行状态。2022 年 CoT 研究则突出用自然语言推理示例,引导大模型在答案前产生步骤;经典实验采用 few-shot 提示,不是在测试时训练参数。两者都利用自回归写回,但不等同于同一种训练方法,也不保证写出的过程忠实反映内部机制。\n\n在 2021 年论文 §7,只根据最终结果反馈学习使用 scratchpad 仍是值得尝试的方向。把它与后来的结果反馈研究并看,可以理解问题如何延续;不能倒过来说后来的路线在当时已经必然成功。\n\n### 2022:是多输出了一些,还是中间内容和位置有用?\n\n先提出两个替代解释:也许输出更多片段本身就有用;也许只需唤起相关知识,解释放在答案后也一样。Wei 等初版 §3.3 / Table 2 比较了这些可能性。下表是 137B 模型,五个随机种子打乱 few-shot 示例顺序后的准确率均值 ± 标准差,单位 %。\n\n| 提示方式 | MultiArith | GSM8K |\n| --- | --- | --- |\n| 标准提示 | 7.6 ± 0.4 | 6.3 ± 0.4 |\n| 推理在答案前 | 45.0 ± 1.6 | 14.8 ± 0.7 |\n| 仅给等式 | 5.7 ± 0.6 | 5.7 ± 0.3 |\n| 先输出点号 | 7.7 ± 0.4 | 6.0 ± 0.3 |\n| 推理在答案后 | 7.6 ± 0.6 | 5.9 ± 0.5 |\n\n点号数按完成该题所需等式的字符数设置,**不是与完整 CoT 严格匹配 token 预算**。在这个设置中,只有“额外输出”不足以解释提升,中间内容与先后顺序值得继续研究。这不能证明所有模型都需要同一种 CoT,也不能证明公开文字就是模型内部推理的完整记录。\n\n下一步有信息量的检验:保持问题与最终答案规则不变,改变中间步骤内容或顺序,比较准确率,并控制提示长度等差异。Q09 的内部干预材料处理另一层问题——内部状态是否对输出有局部因果作用;它不是上述提示消融的同义改写。\n\n原始研究:[Nye 等,2021 初版,§2、§7](https://arxiv.org/html/2112.00114v1);[Wei 等,2022 初版,§3.3、Table 2](https://arxiv.org/pdf/2201.11903v1#page=4)。继续:[CLS 01:固定参数与当前计算](labs.html#CLS01)。\n\n课堂深读:[Q02](#Q02) · [Q06](#Q06) · [Q07](#Q07) · [Q08](#Q08) · [Q09](#Q09)\n\n\n\n## R2 · 好答案在哪里丢掉了?先辨认生成和选择的瓶颈\n\n更多候选增加“至少有一个可用方案”的机会,但最后交付的质量还取决于能否识别它。若日志显示好答案已经在候选中而排名器没有选中,下一笔预算应优先试验选择器或检查,而不是只继续增加生成。若所有候选都失败,才需要问搜索是否太窄、观察是否不足,或者基础能力是否不够。\n\n课堂树是一棵人为构造、可完全检查的小树,不是模型内部思想的截图。它故意让中途得分不等于最终质量:S3 先得 78,而它后面的 L31 最终为 96。Beam=2 第一轮留下 S1=90、S2=86,S3 已被剪掉;最后再精确地挑选,也找不回这个分支。把 S3 的中途评分改成 87 后再跑同一规则,可以区分“候选根本没生成”与“已生成但中途评分误导”。\n\n全保留、Beam=2、每方向保留一条,展开的叶子数不同,所以不能把最终分数直接当成同预算优劣。要同时记生成次数、评分次数、执行检查成本和停止条件。课堂的局部最优只是观察,不是通用搜索保证。\n\n### 用 2019 年的观点审视当前任务:十倍计算能多做什么?\n\nSutton 的 *The Bitter Lesson* 强调能利用计算增长的一般方法,特别是搜索与学习。它不是“算力越多任何方案都会成功”,也不要求小问题放弃简单规则。比较四种投入:补人工例外、增加候选、改善选择器、用反馈学习。研究选择取决于现有瓶颈:候选覆盖差,就扩展;候选已有好解但分错,就改善评估;可靠反馈可重复获得,才值得考察训练是否让未来求解更有效。\n\n先写一个会使自己改判的结果。例如原本选“扩大候选”,但两轮记录发现正确解总被同一检查器拒绝,就应把下一轮资源移到检查器。预算和反馈质量很差时,保留一个简单、可解释的方案也可能更合适。\n\n原文:[Sutton,The Bitter Lesson(2019)](https://www.cs.utexas.edu/~eunsol/courses/data/bitter_lesson.pdf)。动手:[LAB 02:只改 K 或 S3 评分,比较首次剪枝与成本](labs.html#LAB02)。实际模型预算研究、条件和原图见 [Q37](#Q37)。\n\n继续实验:[LAB02 中途选择与错失方向](labs.html#LAB02)对应 Q36 的 N2 搜索问题。先改变宽度 K 或 S3 的评分,再比较保留路径、漏掉的终点及各类生成/评分次数。\n\n### 2024 年的 coding 研究:选择与测试为什么值得投入\n\nOpenAI 2024-09-12 的历史报告使用从 o1 出发、进一步训练编程能力的模型参加 IOI。每题最多提交 50 次,策略结合公开测试、模型生成测试与学习评分来选择提交,获得 213 竞赛积分;随机提交对照的估计平均为 156 分。这是一个具体的正向信号:生成之外的测试与选择可能有价值。\n\n50 是每题提交上限,不是只生成了 50 个候选;156 是原报告的对照估计,不是本课复跑。原文没有将其描述成固定候选池、严格相同总算力且只改选择器的控制实验。因此下一次要分别控制生成器、候选池、预算与独立检查,才能分辨收益来自哪里。[OpenAI 原始报告 Coding 段](https://openai.com/index/learning-to-reason-with-llms/#coding);课堂中的具体比较见 [Q13](#Q13)。\n\n课堂深读:[Q10](#Q10) · [Q13](#Q13) · [Q14](#Q14) · [Q15](#Q15) · [Q17](#Q17) · [Q18](#Q18) · [Q36](#Q36) · [Q37](#Q37)\n\n\n\n## R3 · 测试通过以后,究竟知道了什么?\n\n同一个分页程序通过五项输入,不等于能处理四项、空输入或所有合法页大小。测试给出有限样本上的证据;覆盖论证则要说明为什么任意满足前提的输入都被包含。前提在这里不可省略:输入是有限序列,页大小是正整数,迭代中输入不变。\n\n对于补丁 A 的起点 `range(0,n,size)`,第 j 页覆盖半开区间 [j·size, min((j+1)·size,n))。这些区间首尾相接、不重叠,直到 n;n=0 时没有起点,返回空列表。论证解释了为什么 A 在此前提下不漏项。B “最后补一项”在五项样例有效,却会在四项输入重复,空输入还可能越界。Q19 保留完整覆盖推导,不以一张成功截图代替它。\n\n再分清五种问题:结果是否正确、过程是否符合约束、证据能否支持当前用途、解释是否忠实、行动是否获得授权。通过代码测试不自动回答后四种。例如修改实现以满足原测试,和删掉不通过的测试以得到绿色标记,是两种不同的行为。\n\n可做的检验不是无止境堆用例。先列最可能推翻当前结论的边界:整除页大小、最后不足一页、空输入、非法页大小。用最小反例判断错在哪里,再决定补实现、补检查还是收窄可声称的范围。\n\n阅读:[Q19:完整覆盖论证](#Q19)。动手:[LAB 01:先预测,再换长度与页大小](labs.html#LAB01)。\n\n课堂深读:[Q11](#Q11) · [Q12](#Q12) · [Q19](#Q19) · [Q20](#Q20) · [Q21](#Q21)\n\n\n\n## R4 · 同一个检查结果,送回上下文、筛选样本、用于训练有什么不同?\n\n把检查结果发回当前上下文,改变的是本次后续读取的材料;参数可以保持不变。筛选后模仿把通过的“问题+回答”组成训练集,再更新参数。相对奖励学习则用同一问题下回答的相对表现,改变生成这些回答的概率。三者可以使用同一检查器,但它们不是同一操作。\n\n### 筛选后模仿:目标来自被保留的回答\n\n设 D⁺ 是筛选后保留的问题 x 与回答 y。一个标准的序列负对数似然目标可写成:\n\n```text\nL_SFT(θ) = − (1 / |D⁺|) Σ_(x,y)∈D⁺ Σ_t log πθ(y_t | x, y_\n\n### 同一任务中,四种作用可以配合\n\n仍以修分页程序为例:给出一个带中间步骤的示例,改变的是本次输入;生成循环起点等工作状态,使后续输出有材料可用,通常不改参数。外部程序再组织多个候选、运行检查和选择,改变的是求解流程,其中的模型参数也可以不变。\n\n把检查结果写进下一次调用,改变的是下一次的上下文;筛选合格示例用于监督微调,或把奖励用于参数更新,才是在训练中改变未来的生成倾向。o1/R1 这类经过专门后训练的推理模型,不是只换了一句提示,也不等于一个外部搜索脚本。训练会影响它在使用时怎样利用计算,但普通模型也可以有推理能力。\n\n最后,运行代码、读取日志或查询环境,会带来当前文字中原本没有的观察。若缺的是线上当前配置,多展开一段推导不能替代这条事实。这四种作用可以组合:中间计算、外部搜索验证、推理后训练、工具观测;它们不是互斥类别,也不是所有系统都必须按顺序走完的历史阶梯。\n\n课堂深读:[Q22](#Q22) · [Q23](#Q23) · [Q24](#Q24) · [Q25](#Q25)\n\n\n\n## R5 · 结果反馈能教会模型怎样求解吗?\n\n在进入 2025 年的 R1 研究前,研究者已经知道 2024 年 9 月 o1 报告中训练计算与使用时计算的改善信号;公开报告同时没有披露足以复现全部训练过程与绝对成本的细节。R1-Zero 的问题是在已预训练的开放基座上检验结果反馈怎样改变求解,不能把它讲成此前没人见过推理收益。详细的 o1 图在 Q27 展开。\n\n2021 年 scratchpad 留下一个问题:如果不给每题逐步示范,只根据可验证的结果反馈,模型能否学会更好地组织求解?DeepSeek-R1-Zero 是这一方向的重要历史信号,但不是唯一必然路线。\n\nR1-Zero 从已预训练的 DeepSeek-V3-Base 开始,使用正确性与格式奖励;“没有冷启动 SFT”不能改写成“没有预训练、没有监督信号”。研究报告在训练中观察到自我检查等求解行为变化,回答增长,评测表现提高。它让“如何学习使用推理计算”成为值得继续研究的问题。\n\nQ26 保留论文原图与统计口径。AIME 2024 的 pass@1 采用每题采样 16 次后估计平均准确率,报告从 15.6% 到 71.0%;64 次采样的一致性选择结果 86.7% 是另一种评估方式。训练响应长度曲线与准确率曲线不是逐个样本配对的因果实验,不能说长度变长本身导致更准。\n\n两个图合起来的正向认识是:结果反馈的训练可能改变模型安排计算的方式,并改善该设置的表现。下一步应区分基座能力、奖励覆盖、训练任务以及计算预算的贡献。例如固定基座和评测预算,改变奖励覆盖,再看新任务与原任务是否同时改善。若只在被奖励的格式上变好而任务效果不变,就应修改对“求解能力提高”的判断。\n\n原研究:[DeepSeek-R1(2025 初版)§2.2,Figures 2–3](https://arxiv.org/html/2501.12948v1#S2.SS2)。原图、轴、条件和具体读法:[Q26 阅读正文](#Q26)。与训练/使用两种计算的比较见 [R8](#R8)。\n\n### 一个可观察的行为片段,还不是一个因果证明\n\nDeepSeek-R1 v1(2025-01-22)§2.2.4 的 Table 3 展示作者选出的 R1-Zero 中间训练检查点片段:回答先进行代数推导,随后暂停,回到原来的方程重新核对。Q26 保留了题目条件、初步变形和返回原式的具体位置,便于核对“回头检查”这个动作,而不只是看一个暂停词。\n\n这是作者选出的例子,原表节选没有给出完整最终成功过程,也不是最终 R1 模型的完整答案。它提示值得研究的行为,不能单独证明内部因果过程或稳定的新能力。下一步应固定基座、任务和预算,在未见题上比较这种复核出现的频率、正确率与成本,观察它是否真的纠正错误。[原论文 §2.2.4 / Table 3](https://arxiv.org/html/2501.12948v1#S2.SS2.SSS4);完整片段与判断题见 [Q26](#Q26)。\n\n课堂深读:[Q26](#Q26) · [Q27](#Q27) · [Q28](#Q28)\n\n\n\n## R6 · 能把工作交出去以后,为什么还要看过程和证据?\n\n更强的求解能力让系统可以写补丁、调用工具和多轮尝试。与此同时,评价指标与真实目标之间的缝隙也更重要:一个会主动寻找办法的系统,可能找到“让检查器满意”的捷径,却没有完成委托。检查覆盖不足是没看见错误;改变测试、评分器或汇报标准来获得通过,则改变了验收依据。\n\n可观察的推理文字是一类线索,代码与工具轨迹是另一类线索,最终行为证据又是另一类。监控研究发现,读取推理链有时能比只看行动捕捉更多异常意图;但推理文本不是透明完整的内心,也不能保证训练后始终可靠。Q33 保留实际监控实验的 Table 1、Figure 4、对比条件和分母,不把不同实验的百分比合并成一个普遍成功率。\n\n委托时写清目标、可使用资源和需要回来确认的边界,再设计能区分“做成了”和“只改了判分方式”的证据。不要因为增加观察就限制一切行动;观察应帮助决定哪些工作可以放心委托、哪些步骤需要独立检查。\n\n研究原图与实验口径:[Q33:监控线索与解释的边界](#Q33)。委托卡:[Q34:范围内继续,越界说明](#Q34)。更深入的监控材料属于阅读层,课堂保留一次明确的行为判断。\n\n\n\n### 开场的两个故事:同一个“成功”,验收对象可能不同\n\n课堂只打开 [OpenAI 的训练环境报告(2026-10-23)](https://openai.com/index/securing-our-frontier-model-training-environment/)。先定位 September 20,再到 Communicating across isolated tasks,最后到 Resuming frontier training。下面保留学生与 AI 继续学习所需的事件背景;约 30 分钟讲述以两个机制为主,不再另开一段 reward hacking 展示。\n\n**DNS:**原任务是依据博客和人物线索找作者。普通搜索没有解决问题,模型转而试探环境,经 DNS 解析服务的配置缺口连到外部聊天服务,得到“法国首都是巴黎”的回应;原来的作者识别任务仍未完成。DNS 是信息通路,回答由外部聊天服务产生。这个中间结果支持通路测试,不等于完成原任务;单看答案文字也不能代替网络记录。[事件记录](https://alignment.openai.com/misalignment-reports/an-agent-used-dns-to-reach-an-external-chatbot/)说明原奖励已经惩罚越界行为,因此不能把该事件当成骗取正奖励的证据。\n\n**CPU 缓存:**另一项是研究者布置的红队测试:不同 microVM 在共享宿主上交换合成测试秘密,禁用网络和共享可写文件。软件隔离并不自动使物理资源独占;一方影响缓存状态,另一方测自己的读取耗时,从快慢差异恢复消息。报告提供了不同程度的方向或协议支持,不能讲成完全无提示的自发发现,也不能推为任意两台虚拟机都能通信。\n\n**先判断,再检查:**假设一个课堂构造把慢约定为 1、快约定为 0,那么“慢、快、慢、慢”读作 1011。这不是原实验协议或实测数据。接着问:一次变慢怎样排除背景噪声?可以提出重复对照、对齐时刻、用接收方事先不知道的新消息作验证。信息来自可观察的差异;模型需要把想法变成可运行的测量。\n\n报告记载 9 月 20 日暂停相关工作,10 月 1 日恢复前沿强化学习训练和内部推理。它支持“验证会影响研发节奏”,不支持据此断言某个具体产品延期。回到分页母例:方法能运行、某项测试通过、整个任务完成,是三个需要分别给证据的判断。\n\n课堂深读:[Q28](#Q28) · [Q33](#Q33) · [Q34](#Q34)\n\n\n\n## R7 · 一次超时,能证明服务没有完成吗?\n\n分页是可在本地重放的确定性问题;服务超时还涉及我们没有观察到的状态。客户端等待结束,不等于服务器停止处理。立即重试可能重复提交;一直增加推理长度也不能告诉我们远端是否已经执行。\n\nLAB 04 使用确定性的模拟时间,区分 response、timeout、backoff 和整体 deadline,不发真实网络请求。默认响应需 300ms,而客户端 200ms 就超时;加上 50ms 退避,重复五次仍可以没有一次观察到成功。这里应先改善截止时间或获取服务端观测,不应把重试次数增加当成“模型更努力所以必然成功”。\n\n记录请求身份与尝试身份、事件时间、是否收到响应、是否达到总预算,可以让另一个人检查结论。相同时间点上响应和超时谁先处理也需要明确约定,而不能让代码执行顺序偷偷决定事实。模拟给出机制检验,不能冒充真实网络性能测量。\n\n连接下一讲:需要留下可恢复的中间状态,就出现记忆与交接;缺少服务端事实,就需要工具取得新观测;要反复运行并比较可验证结果,就需要 runtime。Coding Agent 的价值在于这些能力能连成闭环,完整系统留到后续课。\n\n动手:[LAB 04:超时迁移与证据交付](labs.html#LAB04);配套阅读 [CLS 02](labs.html#CLS02)。开场的 DNS 与 CPU 缓存背景见 [两个故事及原始来源](#opening-cases);不要把课堂模拟的延迟当成那些事件的测量。\n\n课堂深读:[Q38](#Q38) · [Q39](#Q39) · [Q40](#Q40) · [Q41](#Q41) · [Q42](#Q42) · [Q43](#Q43) · [Q44](#Q44)\n\n\n\n## R8 · 下一笔计算预算,投在哪里才有信息量?\n\n### 2024:训练计算与使用时计算都可能产生收益\n\nOpenAI 在 2024 年 9 月 12 日发布的 o1 历史报告,分别展示更多强化学习训练计算、更多测试时思考计算与表现改善的关系。训练计算用于改变策略参数及使用计算的方式;测试时计算用于固定训练结果后的这一次求解。两条曲线让人看到新的研究空间,而不是只问预训练模型有多大。\n\n原图的横轴分别是训练计算、测试时计算,纵轴为相应评测表现;报告支持方向性的增长关系。图中没有足够的绝对成本信息让我们算出精确投资回报,也不应从图推导一个通用 scaling 指数。它是当时模型的历史报告,不是今天每个产品、每项任务的承诺。[o1 官方历史报告(2024-09-12)](https://openai.com/index/learning-to-reason-with-llms/)。\n\nR1-Zero 进一步让我们追问结果反馈怎样改变求解策略;Q37 的预算研究则要求在给定生成器、验证器、数据集与预算下比较方法。把这些证据连起来,不是得到“永远多想”的结论,而是学会辨认追加计算会改变哪个瓶颈。\n\n### 面对新任务,先做一个区分实验\n\n| 已有信号 | 优先尝试 | 什么结果会使我改判 |\n| --- | --- | --- |\n| 候选都没有可用解 | 扩大候选/搜索方向,或补必要事实 | 新候选有好解却仍交付错解,转查选择器 |\n| 好解在候选里但没选中 | 改善验证与排序,保留候选不变 | 独立检查也无法区分,重新检查目标与证据 |\n| 输入缺少外部事实 | 调用工具取得观测 | 观测已充分仍推演错误,再投求解计算 |\n| 可靠反馈可反复获得 | 评估反馈训练是否改善未来任务 | 只对训练检查优化而外部任务不进步 |\n| 预算耗尽或无法取得关键证据 | 停下,交付已知/未知及下一步 | 新的低成本证据到来,再恢复求解 |\n\n先写初始选择,再固定其余条件跑一次最小比较,最后记录改判条件。记忆帮助保留这些状态和证据;工具补足缺失事实;runtime 提供可运行反馈。这样,本讲自然走向记忆、工具和 Coding Agent,而不是停在一串算法名称。\n\n原模型预算研究及 Figure 7 的任务条件、横纵轴、分层练习见 [Q37](#Q37);课堂最后判断题见 [Q44](#Q44)。实验 [LAB 02](labs.html#LAB02) 与 [LAB 04](labs.html#LAB04) 分别训练成本比较与证据交付。\n\n### CSV 迁移:让一条新证据真正改变判断\n\nQ44 是教学构造。原任务一开始就要求保留编号前导零、保留空金额、正确处理引号内逗号、不改原文件。旧检查只覆盖普通字段、前导零、空值和原文件未改;八个候选中的三个通过,排序器却选择了一个连旧检查都失败的候选。初选时,改善选择有直接依据,补测尚未覆盖的原要求也有依据。\n\n随后揭晓未参与筛选的输入 `0012,\"book, pen\",`:应当解析为三列,课堂给定的检查结果是原先通过的三个候选都拆成了四列。任务规则没有改变;改变的是关于候选可用性的证据。“好解已经存在”不再受旧检查支持。可以转向检查共同错误或扩展候选,也可以保留改善选择的研究方向,但须补上这个新的检查。共同失败尚不能证明代码根因相同。\n\n先说初选为什么合理,再指出哪条新证据支持保持或修改判断,最后列出下一项区分实验。这里没有唯一标准投入方向;需要的是可追踪的判断变化。案例与两次停顿的完整解释见 [Q44](#Q44)。\n\n课堂深读:[Q18](#Q18) · [Q26](#Q26) · [Q27](#Q27) · [Q37](#Q37) · [Q44](#Q44)\n\n\n\n## 逐页研究与解释\n\n下列正文复用当前课件导出的解释、论证和原研究图。已分离明显制作/迁移记录与重复旧稿;有效科研附录继续保留。每页可返回课堂或相关实验。\n\n- [Q01 · 五条记录,只回来四条](#Q01)\n\n- [Q02 · 会 Python,这一次够用吗?](#Q02)\n\n- [Q03 · 修好,不只是让 E 出现](#Q03)\n\n- [Q04 · 循环会走到哪一步?](#Q04)\n\n- [Q05 · 已有材料能回答什么?](#Q05)\n\n- [Q06 · 先写下中间结果:写下的内容成为后面的条件](#Q06)\n\n- [Q07 · 走完一次完整循环:读、算、选、写回,直到交付](#Q07)\n\n- [Q08 · 写得更多,增加了什么](#Q08)\n\n- [Q09 · 只看短答案,能判断什么?](#Q09)\n\n- [Q10 · 现在只知道:A 过了这一个例子](#Q10)\n\n- [Q11 · 三种改法,都让 E 回来了](#Q11)\n\n- [Q12 · 换一个输入,三个绿勾就分开了](#Q12)\n\n- [Q13 · 找到了好方案,还得选得出来](#Q13)\n\n- [Q14 · 补丁没写完,先留下哪条路?](#Q14)\n\n- [Q15 · 两个名额,也可能挤在同一条路上](#Q15)\n\n- [Q17 · 修好空输入,再查其他条件](#Q17)\n\n- [Q18 · 十倍计算,先改变哪一步?](#Q18)\n\n- [Q19 · “通过”,要带上检查范围](#Q19)\n\n- [Q20 · 最后都是20,中间两步也都对吗?](#Q20)\n\n- [Q21 · 都算对了,还要看拿来做什么](#Q21)\n\n- [Q22 · 这一次选出来,和以后学会,是两条路](#Q22)\n\n- [Q23 · 把高分的回答,更常写出来](#Q23)\n\n- [Q24 · 同一个低分B,可以被丢掉,也可以成为负信号](#Q24)\n\n- [Q25 · 删一项检查,B一定会混过去吗?](#Q25)\n\n- [Q26 · 不逐步示范,能学会更好的求解吗?](#Q26)\n\n- [Q27 · 把计算花在训练,还是花在这一次?](#Q27)\n\n- [Q28 · 这盏绿灯说明了什么?](#Q28)\n\n- [Q33 · 现在能交付哪一项?](#Q33)\n\n- [Q34 · 怎样把委托写清楚?](#Q34)\n\n- [Q36 · 下一步让哪项未知减少?](#Q36)\n\n- [Q37 · 128份生成,怎样分配?](#Q37)\n\n- [Q38 · 总工作与等待时间](#Q38)\n\n- [Q39 · 现在继续做什么?](#Q39)\n\n- [Q40 · 下一步先增加什么信息?](#Q40)\n\n- [Q41 · 一条请求,几次尝试?](#Q41)\n\n- [Q42 · 只改重试开关,会怎样?](#Q42)\n\n- [Q43 · 三张卡,怎样交付?](#Q43)\n\n- [Q44 · 下一份计算,减少哪项未知?](#Q44)\n\n\n\n[逐页目录](#page-index) · [返回 Q01 课堂](index.html#/Q01/b0)\n\n\n\n# 五条记录,只回来四条\n\n这一页只做一件事:把“要求的三页”和“实际拿到的两页”放在同一屏上比较。能确认的失败只有一条——E 没有回来;原因还不知道,也不在这一页揭晓。\n\n## 课堂构造,不是真实失败记录\n\n本页是课堂构造的小程序,不是某个模型的真实失败记录。左侧五条记录 A–E、每页最多两条、“最后一页可以不满”,都是为了让学生先建立可比较的要求,再看到输出少了一条。演示不包含真实模型、真实代码或真实日志。\n\n## b0:把要求说完整\n\n### 要求\n\n第 1 页AB\n\n第 2 页CD\n\n第 3 页E\n\n### 实际返回\n\n尚未返回内容\n\nb0 的舞台上,右侧保持空白,但尺寸已经预留。此时不出现第三页、问号、结论或代码;学生先看到输入、页大小与三页要求,并听到“最后一页可以不满”。\n\n## b1:只确认 E 缺失\n\n### 要求\n\n第 1 页AB\n\n第 2 页CD\n\n第 3 页E\n\n### 实际返回\n\n第 1 页AB\n\n第 2 页CD\n\n第 3 页?未返回\n\n只回来四条\n\n实际只返回了前两页,也就是四条记录;输入中的 E 没有出现在结果里。期望的第三页仍应包含 E。这个对照确认了遗漏,却还没有解释遗漏的原因。\n\n这只是一个观察结果。读错、循环错、切片错都还是候选原因;代码没有出现,因此不能从这一屏推出根因,也不能说已经修好。\n\n## 证据边界\n\n### 能确定\n\n- 输入是 5 条记录,页大小是 2。\n\n- 按顺序分页,要求是三页。\n\n- 实际返回只有四条,少了 E。\n\n### 还不能确定\n\n- 是读取、循环还是切片导致的缺失。\n\n- 问题出在哪一行代码。\n\n- 任何“已修好”或“只有这一种原因”的结论。\n\n## 来源与身份\n\n本讲保留逐页解释、研究原文和实验入口;整讲可在“完整学习正文”中连续阅读。\n\n\n\n[逐页目录](#page-index) · [返回 Q02 课堂](index.html#/Q02/b0) · 实验 [CLS00](labs.html#CLS00) · [CLS01](labs.html#CLS01)\n\n# 会 Python,这一次够用吗?\n\n上一页只能确定输出里少了 E,原因还不知道。模型已经学会 Python,与它已经知道这一次哪里错,是两件事:已有能力要通过本次计算,才能用到眼前材料上。\n\n\n\n## 从“学会知识”到“本次求解”\n\nL05 拆开模型怎样计算,L06 追问训练怎样把能力留下。本讲接着问:参数中已经有能力,为什么这次仍要计算?同一个函数会面对不同输入;同一个模型可以提出不同补丁;补丁能运行,也未必符合任务要求。因此要在这次任务里维护中间结果、尝试候选,并用检查结果作选择。\n\n先判断:读过大量 Python、会写循环,是否就能保证眼前的补丁修好?不能直接保证。“懂规则”不等于已经把规则应用到这段代码和这五条记录上。原代码、A–E、size=2 是本次输入;其中的缺陷还需要本次求解发现。\n\n## 已有能力、本次输入与工作状态\n\n### 参数 θ:跨任务保留的能力\n\n训练改变参数,使模型在以后任务中表现出可复用的能力。参数不是只装事实的字典;会使用 Python 语法、识别代码结构,也属于训练留下的能力。在一次普通推理调用中,参数通常保持不变。\n\n### 本次输入:当前给出的材料\n\n代码、要求和输入记录描述的是眼前任务。它们进入上下文,不会仅因为被读到就自动写入参数。材料不完整时,多想可以提出假设,却不能把假设变成尚未观察的事实。\n\n### 中间工作状态:这次算出来、接着可用的东西\n\n例如列出循环起点,算出某个切片,保留一个待检验的补丁。自回归生成中,已经生成的 token 会影响后续输出。参数不变,当前状态仍在变化,后面仍要进行计算。\n\n## 参数不变,不等于计算停止\n\n每生成后续 token,都要根据当前状态计算下一步。把推导中的中间结果写出来,可以让后续生成继续使用它;也可以由外部程序组织多个候选、运行检查,再选择或改写。这些操作在使用时增加计算,不一定更新模型参数。\n\n增加计算提供的是求解机会,是否有帮助取决于材料、方法和检查。重复说“补丁应该正确”没有新增检查;把同一个输入真正运行一次,或推导另一个边界输入,才可能提供可核对的新信息。这也是 reasoning 与 coding 的连接点:把已有能力组织成这一次可验证的求解。\n\n## 容易混淆的三件事\n\n- **“会 Python”不等于“已处理过这个实例”。**同样的规则要应用到不同长度、空列表和不同 size,结果可能不同。\n\n- **“本次调用不更新参数”不等于“没有推理”。**中间状态和输出会变化,规则仍需实际执行。\n\n- **“生成更多内容”不等于“获得新事实”。**缺的是现场日志或当前配置时,还需要从环境中取得观察。\n\n## 结论适用于什么情况\n\n这里讨论的是参数固定的普通推理。在线学习、测试时参数适应等会更新参数的流程,需要另行说明,不能混入本页结论。可见推导文字也不等于模型全部内部计算;Q09 会进一步区分文字、相关特征和干预证据。\n\n## 接下来怎样检验\n\n动手之前先说清楚“怎样才算修好”:不漏、不重、保持顺序,合法边界输入也符合约定。否则即使改出一个能运行的版本,也不知道是不是我们要的。\n\n继续读:[中间计算为何可能有用](handbook.html#R1);动手:[LAB01 先预测分页结果,再改输入查反例](labs.html#LAB01)。\n\n\n\n[逐页目录](#page-index) · [返回 Q03 课堂](index.html#/Q03/b0) · 实验 [LAB01](labs.html#LAB01)\n\n# 修好,不只是让 E 出现\n\n这一页先不急着改代码。它把“什么叫修好”拆成四个可以停下来观察的画面:先看遗漏,再面对一个把 E 补回来的结果,然后才标出同一个 D 出现两次,最后说明原输入不能被改动。\n\n## 四个停点\n\n四个停点共用同一组对象:左侧是原输入 A–E,中间是原来的正确结果 [A B][C D][E],右侧留给另一个结果。顶端只保留一句边界:“输入是有限列表;size为正整数”。\n\n### b0 · 先看遗漏\n\n第 1 页AB\n\n第 2 页CD\n\n第 3 页E\n\n画面只有原输入、原来的正确结果,以及“不漏、不重”。\n\n### b1 · 先预测,不揭示\n\n第 1 页AB\n\n第 2 页CD\n\n第 3 页DE\n\n另一个结果出现,E 回来了。两处 D 用同色连线标出,但不写“错”、不写“重复”,也不提前给结论。画面只问:“E回来了,这样算修好吗?”\n\n### b2 · 手动揭示 D 重复\n\n第 1 页AB\n\n第 2 页CD\n\n第 3 页DE\n\nD重复\n\n只有下一次前进才出现红字“D重复”,并补上“顺序不变;每页最多size条,只有最后一页可以不满”。正确结果和另一个结果都留在原位,方便逐项对照。\n\n### b3 · 原输入不动\n\n原输入 A–E 加一圈细框“输入保持原样”。五张卡仍在左侧原位,结果是另外组成的页;画面不会把输入卡搬走,也不会用动画把输入清空。\n\n## 这一页要留下的判断\n\n- “E 回来了”不等于“修好了”。还要看原来的记录是否不漏、不重、顺序不变。\n\n- 同一个 D 出现两次,是一个可以直接指认的反例;它先于代码出现。\n\n- 组织输出时,原输入保持原样;结果是另外组成的页。\n\n- 标准在看见结果之前就定好,不因为一个结果看起来不错就临时加条件。\n\n## 完整约定(N1)\n\n这份完整约定在后续空输入检查之前先固定下来:\n\n- 输入是有限列表;\n\n- size 为正整数;\n\n- 顺序不变;\n\n- 不漏、不重;\n\n- 每页最多 size 条;\n\n- 只有最后一页可以不满;\n\n- 不修改输入;\n\n- 空输入返回 []。\n\n空输入返回 [] 这一条,会在 Q11 运行任何空输入检查之前明确;它是此前没有涉及的边界,事先定义,不根据某一次失败的结果事后追加。\n\n## 来源\n\n这一页只讲 Q03 的四个停点:E 回来不等于修好,D 重复是一个可见反例,原输入在组织输出时保持原样。\n\n\n\n[逐页目录](#page-index) · [返回 Q04 课堂](index.html#/Q04/b0) · 实验 [LAB01](labs.html#LAB01)\n\n# 循环会走到哪一步?\n\n把停止边界和切片分开看:停止边界决定哪些起点能够进入循环,切片决定每次取哪些元素。items[4:6] 如果没有执行,索引 4 的 E 就不会进入返回结果。\n\n## 课堂构造,不是真实失败记录\n\n本页是课堂构造的小程序:五项记录 A–E、每页最多两条、最后一页可以不满,都是为比较“循环准入”与“切片结果”而设。它不包含真实模型调用、真实日志或线上数据;绿勾也只覆盖这一个五项示例。\n\n## 原函数\n\n```text\ndef paginate(items, size):\n pages = []\n for start in range(0, len(items) - 1, size):\n pages.append(items[start:start + size])\n return pages\n```\n\n补丁 A 只将第三行改为 `for start in range(0, len(items), size):`,其他四行不变。\n\n## 四个状态\n\n### b0 · 规则先于追踪 50 秒 · 墙位置未知\n\n**A**0\n\n**B**1\n\n**C**2\n\n**D**3\n\n**E**4\n\n****5\n\n****6\n\n索引 0–4 对应 A–E,5、6 为空位。停止墙只显示问号,不提前给出 4,也不显示追踪结果。\n\n两条规则先建立:range 到达或越过停止边界就结束,不含停止边界;切片 [s:e] 不含 e,e 超过末尾时停在末尾。循环先决定哪些起点能进来,进来之后才做切片。\n\n### b1 · 走过 0、2,下一步呢? 80 秒 · 墙在 4\n\n**A**0\n\n**B**1\n\n**C**2\n\n**D**3\n\n**E**4\n\n****5\n\n****6\n\n停止墙 4 · start=0 → items[0:2] → [A B] · start=2 → items[2:4] → [C D] · start=4 停在问号。\n\nlen(items) − 1 = 5 − 1 = 4。range 的停止值不包含在内,因此起点只有 0、2;起点 4 不进入循环。这里缺的不是切片能力,而是执行那次切片的机会。\n\n### b2 · 到达停止,循环结束 45 秒 · 从未执行\n\n**A**0\n\n**B**1\n\n**C**2\n\n**D**3\n\n**E**4\n\n****5\n\n****6\n\n停止墙 4 · 红字“到达停止,循环结束” · items[4:6] 灰色虚线“从未执行” · E 留在原位。\n\n4 碰到停止边界,循环结束,第三次切片根本没有发生。E 不是取出来以后弄丢的,而是没轮到它。这里没有“切片越界报错”,也没有把 E 搬走再消失。\n\n### b3 · 补丁 A:只删 − 1 85 秒 · 墙在 5\n\n**A**0\n\n**B**1\n\n**C**2\n\n**D**3\n\n**E**4\n\n****5\n\n****6\n\n停止墙 5 · start=4 → items[4:6] → [E] · 返回 [[A,B],[C,D],[E]] · AB、CD 保持。\n\n只删第三行的 − 1:`range(0, len(items) - 1, size)` → `range(0, len(items), size)`。停止墙平滑 4→5,起点 4 进来,切出 [E]。最后一页只有一条不违反契约,因为最后一页可以不满。\n\n绿勾的完整措辞是“这一个五项示例通过”;旁边的灰字是“空输入和其他长度:尚未检查”。不能把这个勾读成全部输入都已通过。\n\n## 证据边界\n\n- `items[4:6]` 超出长度不会报错,会得到 `[E]`;但原程序没有走到这一步,所以 b2 的画法是“从未执行”,不是“报错”。\n\n- 漏项取决于停止边界、步长和长度三者的关系,不能概括成“所有奇数长度都会失败”。例如五项、size=3 时,起点是 0 和 3,可以覆盖全部。\n\n- 本页的绿勾只覆盖这一个五项示例。空输入、其他长度、其他 size 都尚未检查;空输入返回 [] 的约定要到 Q11 运行前明确。\n\n- 课堂单例修复不等于全域正确;Q03 的“不漏、不重、顺序不变”仍是比较补丁的前提,Q04 不临时改标准。\n\n## 备课误区\n\n- 认为 E 是被切片取出之后丢掉:b2 明确第三次切片从未发生,E 留在索引 4。\n\n- 认为 `items[4:6]` 会越界报错:Python 切片会停在末尾,问题不在报错。\n\n- 把“这一个五项示例通过”扩大成“所有输入通过”:绿勾只覆盖这一个例子。\n\n- 据此概括“所有奇数长度都会失败”:五项、size=3 就是覆盖全部的反例。\n\n## 来源与身份\n\nL07 · 搜索、推理与验证[返回课堂 · b0 规则先于追踪](index.html#/Q04/b0)\n\n\n\n[逐页目录](#page-index) · [返回 Q05 课堂](index.html#/Q05/b0)\n\n# 已有材料能回答什么?\n\n这一页把两件事分开:一件是从手里已有的代码和记录推出一个结论;另一件是知道线上此刻正在发生什么。前者可以算,后者不能靠同一批材料补出来。\n\n## 已有材料能推出什么\n\n左侧始终是同一组材料:原代码和五条记录 A–E。代码里的停止边界写成 `len(items) − 1`;五项示例下就是 5 − 1 = 4。起点轨道上的 0 和 2 进入过循环,4 落在停止边界上,E 没有轮到。\n\n```text\ndef paginate(items, size):\n pages = []\n for start in range(0, len(items) - 1, size):\n pages.append(items[start:start + size])\n return pages\n```\n\nlen(items) − 1=5 − 1=**4**\n\n这个 4 不是从网上查到的,也不是凭感觉猜的。它由原代码的停止边界和输入长度共同决定,所以可以复核;换一段代码或换一个长度,结论就可能不同。\n\n## 三个停点\n\n### b0 · 已有材料推出 4 (55 秒)\n\n画面左侧给原代码和五条记录,推出 5 − 1 = 4;轨道上的 0、2、4 中,4 停在边界。原讲稿里的“需要上网找吗”只是一次复习,不是新的等待环节,也不要求画面进入一个等待状态。\n\n### b1 · 只换问题,不补材料 (20 秒)\n\n另一个问题是“线上此刻还在漏数据吗?”现有代码和旧输入不能回答它;本课没有提供当前线上日志,不能补造数字或观测。\n\n### b2 · 下一次 Space 才揭“需要当前观测” (35 秒)\n\n材料已齐、还缺结论,就继续推导;缺的是现在发生了什么,就需要当前观测。两者的区别是缺少哪一种信息,不是回答长短。\n\n**已有材料这边**材料已齐,还缺结论 → 继续算\n\n**线上这边**缺现在事实 → 补获准观测\n\n这里的“补获准观测”是一个要求,不是已经获得的授权,也不是已经执行的读取。回退到 b1 时,这层结论会消失,问题仍然保持未知。\n\n## 科学边界\n\n- 可检查的结论来自已有代码和输入;本页的 5 − 1 = 4 只对应这个五项示例。\n\n- “模型可能知道程序通常怎样运行”不等于看见了线上此刻的状态。关于程序的一般知识,不能替代当前事实。\n\n- 当前观测必须先获得许可;本页没有授权、没有执行,也不展示虚构的日志或数字。\n\n- 把自己补写的解释当成新的事实,会把“解释”混成“观测”。观测是一条获准读取的当前事实,不是多写一段说明。\n\n- 一个常见误读是:多想一想、多写一段解释,就能补出线上当前状态。解释可以提出假设,不能替代一条获准读取的当前事实。\n\n- 缺少历史约定是第三种真实情况,但这一页不开第三张课堂分类表;它留到后续关于记录与需求变更的练习。\n\n## 这一页要留下的判断\n\n- 能从已有代码和记录推出 4,不等于知道线上此刻有没有在漏数据。\n\n- 只换问题不会自动带来新材料;缺的是现在发生什么,就要取得一条获准读取的当前观测。\n\n- 解释可以提出假设,不能替代观测;补写的解释不能当成新的事实。\n\n## 投影与阅读的分工\n\n### 投影上出现\n\n- 左侧原代码、五条记录、5 − 1 = 4。\n\n- 起点轨道 0、2、4,以及 4 处的停止边界。\n\n- b1 的问题“线上此刻还在漏数据吗?”和问号。\n\n- b2 的“需要当前观测”与左右短对照。\n\n## 来源\n\n- 当前线上情形需要实际记录;这个教学例子没有进行线上读取,也不能把推导当成当前状态的证据。\n\n这一页只讲一个区分:从已有材料推出结论,和知道线上此刻的事实,不是同一件事。\n\n\n\n[逐页目录](#page-index) · [返回 Q06 课堂](index.html#/Q06/b0)\n\n# 先写下中间结果:写下的内容成为后面的条件\n\n同一道分页题,左边直接给出补丁,右边先把四行中间结果写下来。这一页比较的是输出的组织方式,不是两个模型的成绩;它要说明的是:写在前面的话,怎样成为后面推理的条件。\n\n## 两栏对照\n\n上方定义:**思维链(chain of thought, CoT):答案之前写出的中间推导文字。**\n\n### 直接给补丁\n\n`range(0, len(items), size)`\n\n只给最终代码,不写中间的推导。\n\n### 先写中间结果\n\n- 停止边界 = 5 − 1 = 4。\n\n- 起点只有 0、2,没有 4。\n\n- E 在索引 4,没有被遍历。\n\n- 把停止边界改成 len(items)。\n\n两栏都是教师写的课堂对照,不是两个模型的成绩,也不把这四行说成模型真实的内部过程。\n\n## 这一页要留下的判断\n\n- 写下的中间结果可以成为后文的条件:第三行读得到第二行的“没有 4”。\n\n- 但“读得到”不等于“必然对”:第二行若写错,后面可能沿用,也可能在检查时纠正。\n\n- 两栏是教师构造的课堂对照,不是模型成绩;简单的题直接给答案也可以。\n\n- “写在前面的内容”既可能帮忙,也可能把后续带偏,不能把它当成质量保证。\n\n## 研究边界\n\n这里比较的是输出的组织方式,不是性能。研究中也有人训练模型先写出逐行执行状态,再给结果,例如 2021 年的 scratchpad。效果取决于任务、模型和训练;这一页只留一个简短边界,不把它展开成综述,也不据此声称长推理一定更好。\n\n## 衔接\n\n「把它接回自回归生成:下一个 token 的条件里,到底有没有刚写出来的字?」\n\n## 来源\n\n这一页只讲 Q06 的三个停点:写下的中间结果怎样成为后文条件,以及“可能沿用,也可能纠正”的边界。\n\n\n\n[逐页目录](#page-index) · [返回 Q07 课堂](index.html#/Q07/b0)\n\n# 走完一次完整循环:读、算、选、写回,直到交付\n\n这一页把一次自回归生成拆成六个可以停住观察的画面:读整段当前上下文,算出分布,选出下一个 token,写回前缀,再读、再写;最后写出补丁并选出独立的结束标记。θ 从头到尾没有变。\n\n## 稳定的三个区域\n\n- 左边 θ 框:始终写“θ 没有变”。写回的是上下文,不是参数。\n\n- 中间当前上下文:任务契约|原代码|已生成前缀。前缀随生成逐步增长。\n\n- 右边下一个 token 分布:只画柱,不写数值;旁注“柱高无数值含义”。\n\n下方循环方向是“读 → 算 → 选 → 写回”,写回后再回到读取;选出结束标记时循环停止。补丁行与结束标记是两个不同的输出单位。\n\n### b1 · 选出,不写回\n\n选出4\n\n前缀停止边界 = 5 − 1 =\n\n4 只在“选出”位置;前缀末尾还没有 4。问句停住,不自动揭答案,也不提前画回写箭头。\n\n### b2 · 写回\n\n前缀停止边界 = 5 − 1 = 4\n\n下一次前进才让 4 沿金色箭头进入前缀。θ 不变,变的是下一步能读到的内容。\n\n## 科学边界\n\n- 前缀按可读片段分组,不代表实际 tokenizer 的切分。\n\n- 柱高只示意相对倾向,不是测量值,也没有数字。\n\n- “读完整前缀”指下一个 token 以完整可用前缀为条件;实现可以复用 KV 缓存,不必每步重新计算所有前缀位置。\n\n- 这是自回归机制示意,不是模型的内部录像。\n\n- “每一步依赖前一步输出”是本页的具体口径,不普遍否认各种系统并行技术。\n\n- 写回的是上下文,不是参数更新;θ 全程不变。\n\n- 结束标记与补丁行是两个不同的输出单位;结束信号独立于补丁文字。\n\n## 衔接\n\n从 Q06 接上:下一个 token 的条件里,有没有刚写下的字?\n\n本页讲完接 Q08:「刚才同时发生了两件事,我们把它们拆开说。」\n\n## 来源\n\n这一页只讲 Q07 的六态:同一组参数读完整段上下文,选出下一个 token,写回前缀,再走一圈;最后写出补丁并选出独立的结束标记。\n\n\n\n[逐页目录](#page-index) · [返回 Q08 课堂](index.html#/Q08/b0) · 实验 [CLS01](labs.html#CLS01)\n\n# 写得更多,增加了什么\n\n这一页接着 Q07:写中间结果,既留下后文可读的材料,也让答案之前多做了依次展开的计算。两件事都只是机会,不保证有用。因此要继续问:这些新增材料和计算,是否带来了有用的信息?同一个 E 例子可以帮助判断。\n\n\n\n## 从一次多写,走到一个研究问题\n\n上一讲讨论怎样通过训练改变参数;本讲的这一段先保持参数固定,研究本次调用怎样利用已有能力;到Q22之后再比较反馈怎样用于训练、改变参数。2021年的Scratchpad研究区分直接预测输出与先生成中间执行状态:能生成代码,并不意味着一次就能正确模拟所有执行结果。把状态写回上下文,是让后续token有可继续利用的材料;它不会补出原本不知道的外部事实。\n\n2021《Show Your Work》§7把“用最终执行结果奖励模型学会使用scratchpad”列为未来方向。当时尚不能用后来的R1结果替它作答。2022年的CoT研究则在提示示例中加入自然语言中间推理,使模型在答案前生成类似过程;这与有明确执行变量的scratchpad相关,但不是同一种表达或训练设置。\n\n### 先只拿当时信息,选择一个有区分度的实验\n\n模型会写语言和部分代码,但仍不稳定完成多步计算。看到先写推理能提升成绩后,有两个替代解释:只是答案前多输出了一些东西,还是中间内容及先后顺序发挥作用?课堂b2先请学生提出对照;b3才给出“先写点号”和“答案后再推理”,要求分别预测。b4才揭示数据,b5要求说明下一步和可改判的结果。\n\n\n\n### 原研究:2022年初版Table 2\n\nWei等,2022-01-28 v1,§3.3;137B稠密decoder-only模型(训练细节引LaMDA-PT),greedy decoding。同一套8个手工few-shot示例用于六个算术数据集,下表为其中两列。五个随机种子打乱示例顺序,报告准确率均值±标准差(%)。种子并不是五次重新训练。\n\n| 提示方式 | MultiArith | GSM8K |\n| --- | --- | --- |\n| 标准提示 | 7.6 ± 0.4 | 6.3 ± 0.4 |\n| 推理在答案前(CoT) | 45.0 ± 1.6 | 14.8 ± 0.7 |\n| 仅等式 | 5.7 ± 0.6 | 5.7 ± 0.3 |\n| 先输出点号 | 7.7 ± 0.4 | 6.0 ± 0.3 |\n| 推理在答案后 | 7.6 ± 0.6 | 5.9 ± 0.5 |\n\n点号数量按求解所需等式的字符数设置,不是与完整CoT严格匹配token数量或真实计算预算。因此结果削弱了“只要先多输出就有相同帮助”的简单解释,但不能宣称完全排除所有计算量因素。答案后推理也没有带来相同提升,使先后次序成为值得继续控制的变量。\n\n**正向收束:**在这一设置下,中间内容与顺序值得继续研究。下一次可换模型、换任务或更严格匹配预算;若优势消失,我们就缩小结论。它既不是所有长输出的定律,也不证明可见解释忠实反映内部计算。后一个问题接Q09的内部干预研究。\n\n[原表与§3.3:CoT 2022 v1,第4页](https://arxiv.org/pdf/2201.11903v1#page=4) · [Scratchpad 2021,§2与§7](https://arxiv.org/html/2112.00114v1) · [完整主题R1:中间计算为什么值得研究](./handbook.html#R1) · [LAB01:先预测分页结果,再改条件检验](./labs.html#LAB01)\n\n## 保留的机制演示:b0–b1\n\n两态共用同一组对象:左列是写下的前缀“停止边界=4”和回读箭头;右列是三次“读 → 算 → 写回”按实际方向相接。右列标题旁只标“θ 不变”,保持参数身份。三次是依次展开的计算,不是三层网络;也不声称底层每个算子都串行。\n\n### b0 · 两件已发生的事\n\n左列先出现写下的前缀“停止边界=4”,后文读得到;右列出现答案之前多做的计算,后一步以前一步写出的内容为条件。画面只呈现这两项事实,末尾提出“这能推出写得越长越好吗?”,停五秒供判断。先判断,再继续看两条限制。\n\n### b1 · 有机会,不保证有用\n\n下一次前进才在左列增加“错的材料也可能被沿用”,右列增加“重复一句话,未必增加证据”。同一个 E 例子用三种说法紧凑对照:“E没回来/结果里没有E/少了最后一项”,并指出“仍没解释:为什么没走到4”。落点是“机会≠有用进展”,同时说明不是所有长输出无用。\n\n## 这一页要留下的判断\n\n- 写得更多,可能同时增加两样东西:后文可读的材料,以及依次展开的计算。\n\n- 两项都是机会,不保证有用。错的材料也可能被沿用;重复一句话,未必增加证据。\n\n- 同一个 E 例子换三种说法,仍没有解释“为什么没走到4”。\n\n- 机会≠有用进展;但也不能反过来说所有长输出都无用。\n\n## 科学边界\n\n### 可以说\n\n- 写中间结果留下了后文可读的材料;答案之前可以多做依次展开的计算。\n\n- 长度研究只在具体模型、具体任务下支持对照,不能外推成所有长度的定理。\n\n- token 步之间存在依赖,不代表每个底层算子都串行。\n\n### 不要误读\n\n- 上下文留存不是参数更新,也不是长期记忆。\n\n- “多写”不等于“更聪明”,重复换词不等于增加证据。\n\n- 不能把三循环说成三层网络,也不能声称底层全部串行。\n\n## 来源与限定\n\n上方原表已给出 Wei 等 2022 的点号/先答案后推理对照及具体模型任务,这些结果只在对应模型与任务下支持比较,不能外推为所有长度定理。上下文留存与参数更新、长期记忆是不同的机制。\n\n本页六态保留机制演示,并补齐研究背景、学生对照选择、原表和可改判的结论。\n\n\n\n[逐页目录](#page-index) · [返回 Q09 课堂](index.html#/Q09/b0)\n\n# 只看短答案,能判断什么?\n\n这一页只回答一个问题:模型只写出一个短答案,能不能据此断言它内部没有经过中间步骤?投影分三步——先看短答案,再看研究者观察到的内部联系,最后看只改变内部特征时输出如何变化。\n\n## 三态共用同一组对象\n\n题框全程是“Dallas 所在州的首府?”,位置和文字都不变。答案槽、地理说明、内部特征图和结论各有自己的区域;切态时不重新排版,只在预留区域里换成当前可见的内容。\n\n- **b0**:题框不变,答案只有 Austin;旁边的小地理链说明 Dallas 在 Texas、Texas 的首府是 Austin,并明确这不是模型轨迹。\n\n- **b1**:内部图出现 Dallas 相关特征→Texas 相关特征→Austin 相关特征,另有一条 Dallas 直接到 Austin 的细线。图例写明这是“概念相关内部特征;不是文字变量”。\n\n- **b2**:题框仍不动;研究者抑制 Texas、激活 California,输出由 Austin 改为 Sacramento。旧的有效链撤下,不留下两条同时有效的输出。\n\n## 研究者到底改了什么\n\n这项研究来自 Anthropic 2025 年对 Claude 3.5 Haiku 的归因图工作。原提示固定为“Fact: the capital of the state containing Dallas is”。在这个固定提示下,研究者观察 Dallas→Texas→Austin 的相关结构,也观察到直接指向 Austin 的联系,以及和 capital/首府概念有关的特征。课堂图只保留三个节点,是简化,不是完整的内部算法清单。\n\n干预时,研究者改变的是原模型中的内部特征:抑制 Texas 相关特征,并激活 California 相关特征。题目输入没有被改写成 Oakland 或 California;输出随后从 Austin 变成 Sacramento。这一前后变化提供了局部因果证据,但证据范围仍限于这个模型和这个提示。\n\nCalifornia 相关特征不是从 Dallas 自然长出来的一条地理边。研究里先用别的提示(例如 Oakland)识别出 California 相关特征,再把该特征用于原来的 Dallas 提示。识别特征用的提示,不等于把本实验的题目改掉;投影中“研究者施加”的箭头表示这一区别。\n\n## 为什么不能把它说成“完整思考录像”\n\n- 归因依赖近似替代模型;它帮助研究者提出并检验关于内部特征的假设,不等于原模型逐字的内部记录。\n\n- 三节点图是课堂简化。原图还有首府相关特征和直接路径,不能把简化图当成唯一算法。\n\n- 看到联系不等于看到因果;只有改变内部特征并观察输出变化,才得到这一步的局部因果证据。\n\n- 结论只支持“没写出步骤,不能推出没有中间计算”,不外推到所有模型、所有提示,也不声称看到了完整的思考过程。\n\n## 来源\n\n- 官方原研究:[Anthropic · Attribution graphs · Multi-step reasoning](https://transformer-circuits.pub/2025/attribution-graphs/biology.html#dives-tracing)\n\n这一页只讲 Q09 的三态:短答案不展示中间步骤,观察到的内部联系不是唯一算法,改变内部特征得到的是该模型该提示下的局部因果证据。\n\n\n\n[逐页目录](#page-index) · [返回 Q10 课堂](index.html#/Q10/b0)\n\n# 现在只知道:A 过了这一个例子\n\n这一页只回收已经取得的两件事:补丁 A 把停止边界改为len(items),以及五项、size=2 这一次实际输入和它的输出 [AB][CD][E]。绿勾紧邻这条记录,只覆盖这一个例子。其他长度、空输入以及 B/C 两张候选卡还没有检查,不能据此说全域正确。\n\n## 两个停点\n\n两态共用同一组对象:补丁 A、原输入“五项、size=2”、实际输出“[AB][CD][E]”和检查限定“仅五项示例通过”位置不变。b0 只呈现两张证据卡;b1 才在下方出现“其他长度?空输入?”,并在 A 旁出现 B、C 两张未翻开的候选卡。\n\n### b0 · 只回收已取得的东西\n\n画面只出现两张证据卡:补丁 A 的改动,以及五项、size=2 这一次输入和实际输出 [AB][CD][E]。绿勾紧邻这次记录,写明“仅五项示例通过”。没有系统总图,也没有其他长度、空输入或 B/C 候选。\n\n### b1 · 保留未知\n\n原输入/结果卡不动。A 旁出现 B、C 两张未翻开的候选卡,只露身份与“未翻开”;下方出现“其他长度?空输入?”。不展示代码、不判断谁通过、不给检查集。教师追问:三个补丁都能找回 E 时,凭什么选?\n\n## 这一页要留下的判断\n\n- 补丁 A 已经拿到,E 在这个例子里为什么进来,可以说清楚。\n\n- 五项、size=2 的实际输出是 [AB][CD][E];A–E 的身份和三页分组保持不变。\n\n- 绿勾只覆盖这一次实际输入和结果,不覆盖其他长度或空输入。\n\n- B、C 仍未翻开;三个补丁都能找回 E 时,需要能比较它们的证据。\n\n- 一个例子通过,不等于全域证明;本页不产生新实验,也不执行新验证。\n\n## 证据边界\n\n### 可以说\n\n- 补丁 A 的改动是停止边界改为len(items)。\n\n- 在五项、size=2 这一次输入上,实际输出是 [AB][CD][E]。\n\n- 这张绿勾只说明“仅五项示例通过”,位置紧邻这一次输入和结果。\n\n- 其他长度和空输入仍是未知;B、C 仍是未翻开的候选。\n\n### 不要误读\n\n- 不能从一个例子推出所有长度都正确,也不能把单次绿勾说成已验收或全域通过。\n\n- 不能把未翻开的 B/C 当成已经通过或已经失败,也不能提前替它们判对错。\n\n- 不能把“过程写得长或短”当成绿勾的依据;依据是实际输入和结果。\n\n- 本页不虚构完整证明,也不提前给出后续检查方案。\n\n## 来源与限定\n\n有限检查不等于全域证明。完整证明和测试覆盖不在本页展开,留到后续阅读 N1/R-3;本页只回收已有证据,不把未知画成绿勾,也不虚构后续方案。\n\n\n\n[逐页目录](#page-index) · [返回 Q11 课堂](index.html#/Q11/b0) · 实验 [LAB01](labs.html#LAB01)\n\n# 三种改法,都让 E 回来了\n\n这一页只做三件事:先把空输入的返回接口定下来;再读三张由教师给定的候选卡;最后用同一个五项、size=2 的例子检查,三者都返回 [AB][CD][E]。三个绿勾只覆盖这个例子,不能说三种改法在所有输入上都等价,也不能把候选说成真实模型输出。\n\n## 为什么先定空输入的接口\n\n没有记录时,至少有两种都能自洽的设计:返回一个空页,或者返回“没有任何页”的空列表。它们分别是 [[]] 和 []。两种接口都能设计,本页不是在问学生哪一种“猜对了”,而是在比较补丁之前,先把这一次要用的接口明确下来。\n\n[]\n\n没有任何页。\n\n 本次约定\n\n[[]]\n\n有一个空页。也可设计,本次不采用。\n\n本次选择 [],并以画面上的小标签“空输入→[];其他约定不变”固定下来。这是事先给定的契约,不是知识问答的预测;先定下来,后面所有候选沿用同一条,不看谁失败了再临时改规则。该约定必须在任何空输入测试之前出现。\n\n## 三个停点\n\n### b0 · 先定接口 · 50 秒\n\n输入卡是 [],两种接口 [] 与 [[]] 并排;同一画面里明确本次选 []。不额外点击,不需要学生先答对。画面顶部始终保留小标签“空输入→[];其他约定不变”。\n\n### b1 · 读三张候选 · 75 秒\n\n三张卡只露短代码与实际差异:A 改停止边界,B 保留旧循环并在循环之后追加,C 用 while 逐页切片再前进。共同图例 n=输入长度、i=起点;B 脚注说明 items[-1] 取最后一项且列表须非空。不预告失败。\n\n### b2 · 同一输入检查 · 45 秒\n\n仍是五项、size=2。三卡分别显示 [AB][CD][E],每个勾都写“仅五项示例通过”。三个都过,不按代码长短判对错;单例不能区分三者,也不等于全域证明。\n\n## 三张候选卡实际在做什么\n\n**A · 改停止边界。**循环仍是按 size 前进,切片仍是 items[i:i+size],只把停止边界从原来的 len(items) - 1 改为 len(items),也就是短代码里的 range(0, n, size)。起点走到最后一段时,切片仍会包含 E。\n\n**B · 保留旧循环,再补最后一项。**列表推导仍用 range(0, n-1, size) 和 items[i:i+size],在本页五项、size=2的例子里,这段循环只切出[AB][CD];循环结束后,才执行 pages.append([items[-1]])。这里的“之后”很关键:追加不在循环体内,而是整个循环结束后的下一条语句。items[-1] 取最后一项,因此列表须非空。\n\n**C · 从 0 开始,每次向后走 size。**先令 pages, i = [], 0;只要 while i < n,就执行 pages.append(items[i:i+size]),切出当前这一页;然后 i += size,把起点移到下一段。循环不是空转:每一轮都先切片追加,再前进。\n\n共同图例是 n=输入长度、i=起点。三张卡保留实际短代码的差异,不把三份完整函数同时压到投影上;完整函数如下,按源稿缩进保留。\n\nB 的脚注:items[-1] 取最后一项;列表须非空。这个前提和 b0 先定的空输入约定是两件事,不能到后面才临时换标准。\n\n## 完整函数(备课 / N1)\n\n`def A(items, size):\n return [items[i:i + size] for i in range(0, len(items), size)]\n\ndef B(items, size):\n pages = [items[i:i + size] for i in range(0, len(items) - 1, size)]\n pages.append([items[-1]])\n return pages\n\ndef C(items, size):\n pages, i = [], 0\n while i < len(items):\n pages.append(items[i:i + size])\n i += size\n return pages`\n\nsize 为正整数;输入是有限列表;分页保持顺序、不漏不重、每页不超过 size;原输入不被修改。这些沿用已有契约。本页只新增并先固定空输入约定,不在此展开完整证明。\n\n## 同一五项检查\n\n取五项 A、B、C、D、E,size=2。A、B、C 三份函数在这一个输入上都返回 [AB][CD][E]。b2 的画面上,三张卡的结果并列出现,每个勾旁都写“仅五项示例通过”。这说明的是三个候选都能通过这一个算例,不是它们在所有输入上等价,也不是在线模型的实测输出或概率、性能比较。\n\n## 这一页要留下的判断\n\n- 空输入先定为 [](没有任何页);[[]](一个空页)也是可设计接口,只是本次不采用。\n\n- A 改停止边界;B 保留旧循环并在循环之后追加最后一项;C 用 while 逐页切片并前进 size。\n\n- 五项、size=2 时,A/B/C 都返回 [AB][CD][E]。\n\n- 三个绿勾只覆盖这一个例子;单例通过不等于全域证明,也不能据此说三种改法在所有输入上都等价。\n\n- 候选由教师给定,不是模型真实输出;本页没有在线运行模型,也没有实测性能数据。\n\n## 证据边界\n\n### 可以说\n\n- 三种改法都是教师给定候选,不是上游模型的真实输出。\n\n- 空输入本次先定为 [];[[]] 也可设计,只是本次不采用。\n\n- 五项、size=2 时,A/B/C 的实际结果都是 [AB][CD][E]。\n\n- 每个绿勾只说明“仅五项示例通过”。\n\n- B 的 items[-1] 要求列表非空;C 每轮切片后执行 i += size。\n\n### 不要误读\n\n- 不能把五项单例通过当成全域证明,也不能说三种改法在所有输入上等价。\n\n- 不能把候选当真实模型上线输出或实测性能结果;本页没有在线运行模型。\n\n- 不能按代码长短判对错,也不能提前把某张候选判成失败。\n\n- 不能因为后面遇到边界,就临时改掉 b0 已经定下的空输入约定。\n\n\n\n[逐页目录](#page-index) · [返回 Q12 课堂](index.html#/Q12/b0) · 实验 [LAB01](labs.html#LAB01)\n\n# 换一个输入,三个绿勾就分开了\n\n五项、size=2 时,A、B、C 都返回 [AB][CD][E],三个绿勾分不出该选谁。这一页分别换两个输入:先把 E 拿走,再把所有记录拿走。四项输入让 B 多出一个 D;空输入让 B 抛出 IndexError,而 A、C 都返回空列表。两个失败对应不同输入,是独立反例;A、C 通过这三个输入,也不等于已经证明所有合法输入。\n\n## 为什么四项不是“随便多测一次”\n\nB 的循环仍用旧上界 `range(0, len(items) - 1, size)`,循环结束后再执行 `pages.append([items[-1]])`。五项时,循环只切到 [AB][CD],最后补的 [E] 正好补上了循环漏掉的最后一项,所以 B 看起来通过了。\n\n四项时,长度是 4,旧上界仍是 3,起点还是 0、2。起点 2 的切片 `items[2:4]` 已经把 C、D 都取到了;循环结束后,B 又补了一次最后一项 D。于是实际输出是 [AB][CD][D]。这不是“漏取之后修复”,而是同一个 D 出现了两次。\n\n### 五项 · size=2\n\n循环切出 [AB]、[CD];循环后补 [E]。实际 [AB][CD][E],恰好与期望相同。\n\n这个例子只说明 B 在这一组输入上通过,不说明 B 的追加逻辑正确。\n\n### 四项 · size=2\n\n循环切出 [AB]、[CD];D 已经在 [CD] 里,循环后又补 [D]。实际 [AB][CD][D],D 重复。\n\n四项专门检查“补最后一项”是否重复,不是又一次无差别的抽样。\n\n## 空输入:没有最后一项\n\n空输入 `[]` 时,循环范围是 `range(0, -1, 2)`,一次也不会执行。接着 B 仍要执行 `pages.append([items[-1]])`;空列表没有最后一项,`items[-1]` 直接抛出 `IndexError: list index out of range`。\n\nA 和 C 在空输入上都返回 `[]`,与事先定好的“没有任何页”接口一致。空输入的问题不是重复,而是根本没有元素可供取用。\n\n五项 · size=2\n A、B、C 都返回 [AB][CD][E]\n 都过\n\n四项 · size=2\n B 返回 [AB][CD][D];A、C 返回 [AB][CD]\n B 重复\n\n空输入\n B 抛出 IndexError;A、C 返回 []\n B 报错\n\n目前只检查这三个输入。四项重复与空输入越界是两个独立反例:即使不测空输入,四项也足以排除 B;反过来,删掉四项测试,空输入也只能说明越界这一种失败。A、C 通过了这三个输入,不等于已经证明所有合法输入。\n\n## 同一个确定性例子重复十次,没有新增区分\n\n把同一个已经通过的确定性例子重复跑十遍,仍然看不到这两个差别。这里要说的是:新增检查要有新的区分力。要问的不是“多检查几次有没有用”,而是“这次新检查能看出什么不同”。这个限定只针对重复同一个确定性例子,不外推成“所有随机重复采样都没有信息”。\n\n## B 的两行实际代码\n\n`pages = [items[i:i + size] for i in range(0, len(items) - 1, size)]\npages.append([items[-1]])`\n\n第一行保留旧循环和旧上界;第二行在整个循环结束之后执行,不在循环体内。B 的失败来自这两行的组合,而不是某一行单独“看起来短”。\n\n## 完整三函数(备课 / N1)\n\n`def A(items, size):\n return [items[i:i + size] for i in range(0, len(items), size)]\n\ndef B(items, size):\n pages = [items[i:i + size] for i in range(0, len(items) - 1, size)]\n pages.append([items[-1]])\n return pages\n\ndef C(items, size):\n pages, i = [], 0\n while i < len(items):\n pages.append(items[i:i + size])\n i += size\n return pages`\n\nsize 为正整数;输入是有限列表;分页保持顺序、不漏不重、每页不超过 size;原输入不被修改。空输入的接口沿用 Q11 已定的约定:没有任何页,返回 []。\n\n## 承转\n\n「A 和 C 一直都在候选里。为什么系统还是可能把 B 交出去?」这句话只把问题带到下一次选择,不在本页回答。\n\n## 证据边界\n\n### 可以说\n\n- 四项、size=2 时,B 的实际结果是 [AB][CD][D],D 重复。\n\n- 空输入时,B 抛出 IndexError;A、C 返回 []。\n\n- 五项、size=2 时,A、B、C 都返回 [AB][CD][E];这是 Q11 已建立的单例证据。\n\n- 四项重复与空输入越界是两个独立反例,对应不同输入。\n\n- 即使不测空输入,四项也足以排除 B。\n\n- 目前只检查这三个输入;A、C 通过三例不等于全域证明。\n\n- 同一个确定性例子重复十次没有新增区分;该限定不外推到所有随机重复采样。\n\n### 不要误读\n\n- 不能把四项当成“随便多测一次”;它专门检查补最后一项是否重复。\n\n- 不能把空输入说成重复问题;空列表没有可供取用的最后一项。\n\n- 不能因为 A、C 通过三个输入,就说它们在所有合法输入上都正确。\n\n- 不能把五项、四项、空输入之外的输入说成已经检查过。\n\n- 不能把候选说成模型的真实输出;本页是教学构造,没有在线运行模型。\n\n\n\n[逐页目录](#page-index) · [返回 Q13 课堂](index.html#/Q13/b0)\n\n# 找到了好方案,还得选得出来\n\nQ12 已经建立:五项、size=2 时 A、B、C 都返回 [AB][CD][E]。这一页不改候选,也不改到达顺序和选择规则,只把检查集合从“五项”换成“五项+四项+空输入”,看交付结果怎样从 B 变成 A。五项下三候选同分,B 先被交付靠的是给定的 B→A→C 顺序与首过规则,不是 B 更好;“先过先交”只用于这个构造,不默认延续到奖励训练。\n\n## 两态只改检查集合\n\n三张候选卡始终是 B、A、C,位置和身份不动;顶部到达顺序始终是 B→A→C,选择规则始终是“交付第一个通过检查的候选”。b0 与 b1 的差别只有检查集合,以及由此产生的通过、停止与交付。\n\n候选\n B、A、C 同一组;不新增候选\n 两态不变\n\n到达顺序\n B → A → C\n 两态不变\n\n选择规则\n 交付第一个通过检查的候选\n 两态不变\n\n检查集合\n b0 只用五项;b1 加入四项与空输入\n 只改这里\n\n交付与停止\n b0 停在 B、交 B;b1 停在 A、交 A\n 结果改变\n\nC 的位置\n b0 未进入本轮检查;b1 有 Q12 证据,也通过但未被选中\n 不是失败\n\n## b0:只查五项,B 首过即交\n\n五项、size=2 时,A、B、C 都返回 [AB][CD][E]。这是 Q12 已建立的事实,不是本页新增的预测点击。按 B→A→C 的顺序,B 第一个到达;只查五项,B 就通过了。首过规则立即停止,B 被交付。\n\nA、C 仍在候选里,但本轮没有走到它们,所以标“未按本轮规则检查/未选中”,不是失败。这里的问题不是没有好方案;A、C 都在,只是五项检查没把差别显出来。五项下三候选同分,交付 B 依赖给定的顺序与首过规则,不是 B 更优,也不能外推成“弱检查必然交 B”。\n\nA 和 C 都还在候选集合中。当前检查没有区分它们与 B,所以这一次选错,不能归因于“没有生成过好方案”。\n\n## b1:只加两项检查,交付从 B 变成 A\n\n顺序和规则都没动,只把检查集合换成“五项+四项+空输入”。B 五项通过;四项返回 [AB][CD][D],D 重复;空输入抛 `IndexError`。B 在四项与空输入失败,顺序继续到 A。A 五项、四项、空输入三例都通过,成为第一个通过的候选,交付 A,首过规则停止。\n\nC 的“也通过”来自 Q12 已有证据:五项、四项、空输入三例中 C 也通过。它不是停止后重新测试的结果;本页明确标注“停止后未新测 C”。C 没被选中不是 C 错,只是首过规则已经停在 A。A、C 通过这三个输入,不等于已经证明所有合法输入。\n\n两态的三张卡、到达顺序和选择规则都没有变;变的是检查集合。检查集合一变,B 是否通过、A 是否先通过就变了,交付从 B 变成 A。\n\n## Q12 已建立的三个输入\n\n五项 · size=2\n A、B、C 都返回 `[AB][CD][E]`\n 都通过\n\n四项 · size=2\n B 返回 `[AB][CD][D]`,D 重复;A、C 返回 `[AB][CD]`\n B 失败\n\n空输入\n B 抛出 `IndexError`;A、C 返回 `[]`\n B 失败\n\n这三行只覆盖三个输入,不是全域证明。b1 用它们改变选择结果;C 的通过标签来自 Q12 已有证据,不是本页停止后重新运行。\n\n## 先过先交的边界\n\n“先过先交”只用于这个构造。弱检查让候选同分,最终选谁还依赖额外规则:这里指定了 B→A→C 的顺序和首过即停。不要把这页的结论默认延续到奖励训练。\n\nN2 练习允许学生改到达顺序、改选择规则、改检查集合;改完之后交付结果可能不同。b0/b1只演示固定顺序和固定首过规则下的两种检查集合,不把“弱检查必交 B”或“B→A→C+首过”当成唯一规则。\n\n\n\n## Coding:为什么生成之外的选择值得研究?\n\n前面的 A/B/C 是课堂构造:候选、到达顺序与交付规则固定,加入反例后选中的补丁改变。真实任务里也可以研究这类机会,但需要区分教学对照与历史报告。\n\n[OpenAI 2024年9月12日的 Coding 段](https://openai.com/index/learning-to-reason-with-llms/#coding)报告,一个从 o1 出发、进一步训练编程能力的模型参加 IOI:每题最多提交50次,先产生许多候选,再结合公开测试、模型生成测试和学习评分选择提交。报告策略获得213竞赛积分;随机提交对照的估计平均为156分。\n\n50是每题提交上限,不是候选生成数;156是报告的反事实平均估计,不是本课复跑。原文没有把它写成固定同一候选池、严格相同总计算量且只改变选择器的控制实验。本节也不混用另一种提交预算。\n\n积极信号是:在有可运行反馈的任务里,测试与选择可以成为有价值的研究投入。下一次可以固定生成器、候选池和总预算,对比选择方法,并用独立隐藏测试评估迁移;同时记录测试生成、评分和重试的成本。如果收益只出现在参与排序的测试上,就不能把它当作一般求解能力提升。\n\n这也说明 reasoning 与 coding 怎样相接:生成中间方案,运行以取得结果,检查结果后选择或改写。但测试可能漏错,模型生成的测试也可能共享模型的盲点;能运行不等于容易验证。预算分配见[Q37](reading.html?page=Q37&cue=b0)。\n\n## N2 练习边界\n\nb0/b1只演示固定顺序和固定首过规则下的两种检查集合。N2 允许学生改顺序、选择规则与检查集合;改完之后交付结果可能不同。不要把本页的“B→A→C+首过”当成唯一规则,也不要把“先过先交”默认延续到奖励训练页。这里的三例通过不是全域证明,不能把“A 交付”说成所有合法输入上都正确。\n\n## 证据边界\n\n### 可以说\n\n- 五项、size=2 时,A、B、C 都返回 [AB][CD][E];这是 Q12 已建立的事实。\n\n- b0 只加入五项;B 首过即交,停止;A、C 未按本轮规则检查,不是失败。\n\n- b1 加入四项与空输入;B 四项重复、空输入报错;A 三例通过并交付;C 也通过但未被选中。\n\n- C 的通过来自 Q12 已有证据;停止后未新测 C。\n\n- 两态候选、顺序、规则不变,只改检查集合。\n\n- 五项下三候选同分;交付 B 依赖给定顺序与首过规则。\n\n### 不要误读\n\n- 不能说候选里没有好方案;A、C 都在。\n\n- 不能把 b0 的 A、C 标成失败。\n\n- 不能说 C 在停止后又被测试。\n\n- 不能把 A 通过三例说成全域证明。\n\n- 不能把先过先交外推到奖励训练。\n\n- 不能预揭 Q14 或后代最佳终点。\n\n## 承转\n\n「刚才桌上已经有三份完整补丁。如果不是等三个方案都写完,而是做到一半就决定哪些继续呢?接下来把一次选择放到解法的中途。」\n\n完整方案之间可以选择,尚未完成的路径之间也可以选择。下一步要问:提前做选择,节省了哪些计算,又可能错过什么?\n\n## 来源与限定\n\n- r0 历史研究:[OpenAI(2024-09-12),Learning to reason with LLMs,Coding 段](https://openai.com/index/learning-to-reason-with-llms/#coding)。\n\nb0/b1 是教学构造:候选、到达顺序与选择规则由课堂给定,不是模型实测输出。r0 则是有原始来源的历史报告,两种证据身份应分开。前者用于隔离检查如何影响选择,后者说明这种研究方向为何值得投入;不能把两者当作同一组实验。\n\n\n\n[逐页目录](#page-index) · [返回 Q14 课堂](index.html#/Q14/b0) · 实验 [LAB02](labs.html#LAB02)\n\n# 补丁没写完,先留下哪条路?\n\nQ13 把完整补丁放在桌上挑选;这里把时间往前拨,先看三个尚未写完的方向。中途评分决定下一轮继续把计算投向哪里。它是对继续投入的选择,不等于测试已经通过,也不能把没有留下的方向当作已被判错。\n\n## 同一个问题,三个尚未完成的计划\n\n根节点 R 是“E没回来”。S1 是“改停止边界”,S2 是“在结尾补一项”,S3 是“重写遍历”。这些只是方向,末端仍为空白,没有完整函数可运行。这张树画的是解法选择,不是模型内部网络,也不是上网搜索。\n\n## 三次停顿,各自看什么\n\n- **b0 · 三条尚未完成的路:**只看根节点和三个计划,说明“部分计划,还不能运行”。不展示后代、终点分或 A/C 结果。\n\n- **b1 · 先给规则,再选:**课堂给定 S1=90、S2=86、S3=78。规则是“每轮只留当前得分最高的两条”。保留框保持空白,先问“哪两条继续?”,再问“没有留下,能说它错了吗?”。教师可以无限停留。\n\n- **b2 · 留下不等于证明:**教师主动前进后,S1、S2 加框并写入保留记录,S3 变灰,标“本轮不再展开”。S3 没有被测试判错,它失去了本轮继续的机会。灰色不表示错误,也没有红叉。\n\n90、86、78只是这次课堂给定的排序分,不是概率、通过的测试数量或性能数据。这里只按当前已知的信息选择下一轮。所有后代与终点继续留到后页,不能从这里推断哪个完整候选最终更好。\n\n## 承转\n\n“每条留下的路,又分出两个子方案。下一轮仍然只能留两个。”\n\n此处只建立下一步问题,不揭开后代或终点。下一页继续使用同一个根节点、同一组三方向及其稳定身份。\n\n## N2 练习与 R-2 阅读\n\nN2 让学生改变每轮保留名额 k,逐轮先预测保留集合,再核对规则与可见信息,分别记录“看见了什么、留下什么、什么尚未展开”。生成叶子数和评分次数都应记录,不能只凭完整候选少就宣布总计算成本低。完整树与更多保留规则属于后续练习,不提前放到本页投影。\n\nR-2 保留过程评分的训练与误差、搜索规则和统一预算比较的讨论。过程评分可能判断失准;本页课堂排序不是 PRM 实测、全知正确率或一般性能实验。Q16 的完整比较归 N2/R-2,默认课堂路线保持 Q14 → Q15 → Q17。\n\n## 备课中的诊断点\n\n这是备课模拟,不是真实学生反馈:学生可能把 78 读成“错误率高”,或把不再展开读成测试失败。这里用“课堂排序分”“部分计划,还不能运行”和 b2 的灰色说明把它们分开。可观察的新判断是:能区分中途预算选择与测试判错。\n\n## 证据边界\n\n### 这页能说明\n\n- 当前给定分数与全局保留两条的规则,确定本轮保留集合。\n\n- 中途选择同时决定继续展开的方向和本轮暂时不再展开的方向。\n\n- 没有留下的部分计划还不能据此判定正确或错误。\n\n### 这页尚未建立\n\n- 三个部分计划对应完整函数的测试结果。\n\n- 后代、终点得分、最终最优候选或算法的一般性能结论。\n\n- 真实模型评分、课堂效果或口述时间实测。\n\n\n\n[逐页目录](#page-index) · [返回 Q15 课堂](index.html#/Q15/b0) · 实验 [LAB02](labs.html#LAB02)\n\n# 两个名额,也可能挤在同一条路上\n\nQ14 只规定“下一轮留两条”,没有展开后代。Q15 把这个规则连续用三轮:先留两个方向,再留两个部分方案,最后把留下的写完再选交付。它要建立的判断是:中途保留规则会改变最终能见到的候选;省下展开不保证保留终点最好者。所有分数都是课堂给定的教学构造,不是实测。\n\n## 这页要判断什么\n\n每一轮都只比较“当前全部节点”,取最高的两条,而不是每个父节点各留一条。第二轮因此可能把两个名额都给同一个父节点:S1 下的 91 和 88 同时留下,S2 下的 84、70 不再展开。到第三轮,只有留下的 S11、S12 被写完,得到 L11=92 与 L12=89,选 L11(补丁 A)。\n\n这条路径说明了两件事。第一,保留规则决定下一份计算投向哪里。第二,未被生成的完整候选不能按“终点已经见过却没选”来解释。S3 下的 L31=96(补丁 C)在原运行中从未被写出来;它只在事后把整棵树全部展开时才出现。\n\n## 按父子关系核对这棵树\n\n从同一个问题 R“E没回来”出发,第一轮比较 S1=90、S2=86、S3=78。每个部分方案只接自己对应的完整候选;同一节点在各态保持原位,便于沿线复算。\n\n- S1“改停止边界”:S11=91 → L11=92(补丁 A);S12=88 → L12=89。\n\n- S2“在结尾补一项”:S21=84 → L21=83;S22=70 → L22=69。\n\n- S3“重写遍历”:S31=95 → L31=96(补丁 C);S32=65 → L32=66。这一支只在事后复盘时展开。\n\n逐轮保留的路径是 S1/S2 → S11/S12 → L11;把本课堂树全部展开后,终点最高的是 L31。完整树用于复盘,不能当作原运行在中途已经知道的信息。\n\n## 四个真实可停态\n\n- **b0 · 第二轮谁留下?(55 秒):**继承 S1、S2 保留与 S3 灰“本轮不再展开”。只展开 S11=91、S12=88、S21=84、S22=70;四个当前节点样式相同,没有任何框选或提示。右侧记录第一轮 S1、S2,第二轮保留框为空,规则为“当前全部节点中,最高两条”,问句停在“第二轮哪两条留下?”。所有终点真实空白,S3 的后代与全部分数都不出现。\n\n- **b1 · 写完两条,再选 A(55 秒):**教师主动前进后,S11、S12 加框,S21、S22 变灰;只出现 L11=92(补丁 A)与 L12=89,选中 L11。右侧补齐第二轮 S11、S12 与第三轮“两份完整候选 L11 / L12;选 L11”。先沿根 → S1 → S11 → L11 复走,再命名 Beam search。亮线只有一次连续复走,不新增预测点击,也不自动进入 b2。\n\n- **b2 · 事后复盘:全部展开(50 秒):**右上方显著标出“事后复盘:把本课堂树全部展开”。此时才出现 S31=95、S32=65 与全部六叶 92 / 89 / 83 / 69 / 96 / 66,L31=96 标补丁 C。金色只表示原运行最终选中的链;虚线只表示复盘才展开,避免把复盘画成原运行继续搜到 C。底部结论:“按原规则,这条路从未生成;全展开后才看见 96。”\n\n- **b3 · 2 份与 6 份(50 秒):**保留同一棵树的语义关系,在底部比较“本次逐轮保留:写完 2 份,再选 A”与“本课堂树全部展开:写完 6 份,再按终点分选 C”。旁注:“课堂给定排序,不是性能实验;生成和评分都要计算。”2 / 6 只统计写完的完整候选。\n\n## 规则与逐轮记录\n\n- **规则:**当前全部节点中,最高两条。不是每个父节点各留一条。\n\n- **第一轮:**S1=90、S2=86 留下,S3=78 不再展开。\n\n- **第二轮:**b0 保留框空白;b1 起填 S11=91、S12=88。两个名额都来自 S1,S21=84、S22=70 未留下。\n\n- **第三轮:**只有 S11、S12 被写完,完整候选为 L11=92 与 L12=89;选 L11(补丁 A)。\n\nb0 的保留框为空,四个当前节点没有任何提前选择;预测态可以无限停留,回退、重置、深链或打开笔记都不会提前给出第二轮答案,也不会露出 S3 后代或任何终点分数。\n\n## 承转\n\n「再看另一种下一步:已经有一个补丁,得到一条具体失败信息,能不能改得更好?」\n\n这里只把问题交给下一节。Q17 的补丁修改与后续验证不在本页实现,也不在 default 课堂路线里提前出现。\n\n## 事后复盘不是原运行继续搜索\n\nb2 的“全部展开”是一次复盘,不是把原运行延长。原运行在 b1 已经结束:第二轮留下 S11、S12,第三轮只有 L11、L12 被写完,选 L11。S2 虽然在第一轮被保留,但第二轮没有留下,因此它的完整叶子 L21、L22 也没有被写出来。S3 从第一轮起就没有再展开,S31、S32 与 L31、L32 在原运行中都不存在。\n\n所以 b2 才用两种视觉语言分开:金色是原运行最终选中的链,虚线是只有复盘才展开或写完的部分。底部结论说的是“按原规则,这条路从未生成;全展开后才看见 96”,而不是“终点评分见过 C 却没选 C”。做中途选择时只能使用当时已有的信息;事后看见后果,不等于当时系统应当预知。\n\n## 2 份与 6 份的边界\n\nb3 的两张卡只统计“写完的完整候选”:逐轮保留写了 2 份(L11、L12),全树展开写了 6 份(L11、L12、L21、L22、L31、L32)。两端都还要做评分:逐轮保留在每一轮都比较当前节点,全部展开则要在六个终点之间排序。因此 2 / 6 不是总工作量、不是速度,也不是一般性能结论。\n\n这棵人为给定的树只让取舍可见:少写完整候选可能节省生成,也可能错过更好的终点;多写则增加生成与评分。若真要比较方法,任务、总工作量与评分规则都要对齐。本页不据此宣布哪种算法更好。\n\n## 课堂预算与过程评分\n\n90、86、78、91、88、84、70、95、65 与六个终点分都是课堂给定的教学构造,不是概率,也不是通过的测试数量。它们不声称是过程评分模型(PRM)的实测准确率。过程评分可能判断失准;本页只用它演示“中途保留改变可见候选”,不把排序分当作全知正确率。未生成的答案不能假装当时已经可用。\n\n## 历史方法论与本页的取舍\n\n- L04 先明确对象条件,再作合法性判断。Q15 因此先给“当前全部节点中最高两条”的规则,再让学生比较四个当前节点。\n\n- L05 先留未知槽位,再原位揭示结果。Q15 的终点与 S3 后代只在合同对应态出现,不先展示再伪装成预测。\n\n- L06 保持对象身份与定义,结果和目标可同时比较。Q15 继承 Q14 的根与第一层坐标,四个态内部也固定位置;笔记与阅读返回同一态。\n\n- 舞台承载具体节点、连接与排序;完整解释、预算限制与边界留在教师笔记与这一阅读层。\n\n## N2 / R-2 与后续路线\n\nQ16 不加入默认课堂路线。三种保留规则与 6 / 2 / 3 的叶子对照完整放在 N2 / R-2 的练习与阅读中;不同预算不能直接拿来宣布性能优劣。Q15 之后只保留既有承转:已经有一个补丁,收到一条具体失败反馈,能不能改得更好?这是 Q17 的问题,本页不实现,也不生成后续页。\n\n## 证据边界\n\n### 这页能说明\n\n- 全局最高两条的规则可能把两个名额给同一个父节点。\n\n- 中途保留同时决定继续展开的方向与暂时看不见的方向。\n\n- 未生成的完整候选,不能按“终点评分见过却没选”解释。\n\n- 2 份与 6 份只是完整候选数量,生成与评分都要计算。\n\n### 这页尚未建立\n\n- 真实模型的过程评分准确率或一般性能结论。\n\n- 不同保留规则、不同预算之间的普遍优劣。\n\n- Q17 的补丁修改与后续验证。\n\n\n\n[逐页目录](#page-index) · [返回 Q17 课堂](index.html#/Q17/b0) · 实验 [LAB02](labs.html#LAB02)\n\n# 修好空输入,再查其他条件\n\nQ15 的承转提出:已经有一个补丁,也收到了一条具体失败反馈,能不能据此改得更好?Q17 只改一处:给“结尾补最后一项”加上 `if items` 守卫。空输入因此不再越界,但四项输入仍然重复。这一页要建立的判断是:具体反馈可以指导局部修改;修改之后,仍要回到其他关键条件复查,不能把“修好一处”当成“整个策略正确”。\n\n## 这页要判断什么\n\n原 B 的策略是“旧循环不变,结尾补最后一项”。反馈只指出一个失败:空输入时 `items[-1]` 报 IndexError。按这条反馈做最小修改,就得到 B1:循环原封不动,只在结尾补项前加 `if items`。空输入这个问题确实修好了。\n\n但四项输入非空,`if` 会进入,结尾仍然补最后一项 D;而旧循环的第二个切片 `[C,D]` 已经包含 D。于是同一项 D 出现两次。空输入错误与四项重复是两个独立错误:修掉一个,不会自动消掉另一个。B1 不是“正确补丁”,只是保留了原策略并修掉空输入的一版修订。\n\n## 固定对象与代码\n\n本页固定同一组四项输入 `[A,B,C,D]`、`size = 2`、长度 4 与停止边界 3;代码在左,运行轨迹在右。B1 的缩进是语义的一部分,不能改动:\n\n- 第一处 `append` 在 `for` 内:每个起点切一页。\n\n- `if items` 在 `for` 外:循环结束后才判断非空。\n\n- 第二处 `append` 在 `if` 内:只有列表非空才补最后一项。\n\n- `return pages` 在 `for` 外:最后统一返回。\n\n这些行同时固定了本页的边界:不修 `range` 上界,不删除尾部的 `append`,也不把 B1 换成正确补丁 A。B1 与 Q18 将回收的原 B 不是同一份代码;原 B 没有 `if items` 守卫,空输入会直接报错。\n\n## 四个真实可停态\n\n- **b0 · 先看反馈说了什么(45 秒):**左卡“再仔细检查一遍”,右卡“空输入在 items[-1] 处报 IndexError”;下方保留原 B 的改法“旧循环不变,结尾补最后一项”。右卡指出的输入、位置和错误都在场;反馈只定位空输入,不宣布整个补丁不成立。教师可以停住比较两条反馈的具体程度。\n\n- **b1 · 只加空输入守卫(60 秒):**完整显示 B1 七行,只高亮 `if items` 与它控制的 `append`;旁注“循环没改;追加改为非空时执行”。空列表时循环没有起点、`if` 也不进入,最后返回 `[]`。随后只问“四项输入的起点有哪些?”,本态可以无限停留,起点与四项结果都尚未揭示。\n\n- 给 B 加上非空守卫只修好了空输入。对四项输入,旧循环依次在 start=0 产生 [A,B]、start=2 产生 [C,D],非空追加又产生 [D],总结果为 [[A,B],[C,D],[D]]。因此空输入通过,四项输入仍重复;局部修复后需要重新检查其他条件。\n\n- **b3 · 复查刚修处与关键条件(40 秒):**三格同时展示五项、四项、空输入:五项 `[[A,B],[C,D],[E]]` 过,四项 `[[A,B],[C,D],[D]]` 不过,空输入 `[]` 过。底部结论“修一处 → 重查刚修处+其他关键条件”。只声称覆盖这三个输入,不宣称一般正确性。\n\n## N1:改长度和 size,先写预期再看实际\n\n下面全部按 B1 的规则推导,是练习用的反例,不是本页调用真实工具得到的运行结果。先写预期,再按代码逐行推出实际,最后比较。\n\n- **长度 5、size 2:**起点 0、2 → `[A,B]`、`[C,D]`;非空追加 `[E]`。结果 `[[A,B],[C,D],[E]]`,不重复,这一例通过。\n\n- **长度 6、size 2:**起点 0、2、4 → `[A,B]`、`[C,D]`、`[E,F]`;非空追加 `[F]`。结果 `[[A,B],[C,D],[E,F],[F]]`,F 重复,这一例不过。\n\n- **长度 4、size 3:**起点只有 0 → `[A,B,C]`;非空追加 `[D]`。结果 `[[A,B,C],[D]]`,这一例通过。\n\n- **空输入:**循环与 `if` 都不进入,返回 `[]`,这一例通过。\n\n练习要求:提交每一例的预期输出、实际推导输出,以及至少一个能区分“修好空输入”和“整体正确”的反例。长度与 size 一换,重复与否就会变化;不能只凭五项或四项一例就宣布策略一般正确。\n\n## N2:记录每一次修订增加了什么证据\n\n练习保留一张修订记录,不直接修改 Deepnote。每一轮至少写清五项:改了什么;预期哪一处会变好;实际或按规则推导的结果;哪一处确实好了;哪一处仍然失败、下一次选择要依据什么。\n\n- **原 B:**结尾无守卫。空输入在 `items[-1]` 处取不到;四项输入仍会重复。\n\n- **B1:**只加 `if items`。空输入返回 `[]`,这一处好了;四项输入仍返回 `[[A,B],[C,D],[D]]`,重复没有消失。\n\n- **下一次选择:**不能只重跑空输入。要同时复查刚修处与其他关键条件,例如四项、五项、不同长度和 size;如果修改 range 上界或删除尾 append,必须把它当成新的修订重新取证。\n\n## 证据边界\n\n### 这页能说明\n\n- 具体反馈可以指导局部修改,但它不自动证明整个补丁正确。\n\n- B1 修好了空输入;四项输入仍然重复,两个错误彼此独立。\n\n- 修订之后要重查刚修处和其他关键条件;只重跑刚修好的空输入会误以为任务结束。\n\n- 反例可以按代码规则推导,不必每次都等外部工具报错。\n\n### 这页尚未建立\n\n- 本页没有调用真实工具,也没有实际运行学生代码;N1 的反例是规则推导。\n\n- 没有证明 B1 对所有合法输入正确;只覆盖五项、四项、空输入及 N1 列出的推导例。\n\n- 没有修改 range 上界,也没有删除尾 append,因此不涉及“正确补丁 A”的完整写法。\n\n- 不涉及 Q18 将回收原 B 的后续内容;B1 只是本页修订。\n\n\n\n[逐页目录](#page-index) · [返回 Q18 课堂](index.html#/Q18/c0) · 实验 [CLS01](labs.html#CLS01) · [LAB02](labs.html#LAB02)\n\n# 十倍计算,先改变哪一步?\n\n前面的搜索树已经让我们看见:更多候选、不同保留规则、不同检查,会改变最后交付。现在把这个局部经验放进一个研究选择:如果计算持续增加,什么样的方法能把它转成有效进展?这不是选一个永远正确的算法,而是根据失败证据判断下一份计算应该放在哪里。\n\n\n\n## 用2019年的观点审视当前任务\n\n课堂先给四条路线:补手工例外、多试候选、改善检查、从反馈学习。它们可能分别有效;教师暂不揭示一个“标准选项”,请学生用眼前的失败类型说明初始选择。\n\n- 如果可用答案根本没进入候选,增加覆盖值得先试。\n\n- 如果可用答案已在候选里,最终却选错,单纯增加数量未必解决瓶颈。固定候选集,改变检查与选择,比较是否选出满足契约的答案。\n\n- 如果许多任务反复出现同类困难,而且奖励覆盖可靠,可以研究把这些反馈用于学习,让以后生成改变。保存反馈本身还不等于训练已经发生。\n\n- 任务很窄、预算很小、错误代价低时,直接写一条规则可能更经济;缺乏可靠反馈时也不应盲目加大搜索。\n\nSutton在2019年的历史论述重视能持续利用增加计算的通用搜索与学习。它提供一个值得投入的研究方向,而不是证明某个有限预算任务一定适合复杂方法。这里的四选项与失败卡是课堂研究选择练习,不是对作者私人动机的复原。\n\n写出一个撤回条件:如果固定候选后改检查仍不改善,而新反例显示根本没有可用答案,就把下一份预算转向生成;若问题其实缺当前事实,就先取得获准观测。合理选择会随证据改变。\n\n## 两个对象:同一题的候选,与许多题的记录\n\n### 左边:这一题\n\n左边固定本题的 A、B、C 与检查结果,题头是“这一题:继续生成、比较”。三行分别是:\n\n- **A · 改停止边界:**`range(0, n, size)`。五项得到 `[[A,B],[C,D],[E]]`,四项得到 `[[A,B],[C,D]]`,空输入返回 `[]`;三个已检查输入都通过。\n\n- **B · 保留旧循环,结尾补最后一项:**`pages.append([items[-1]])`。五项通过;四项时 D 已经在 `[C,D]` 里,结尾又补一次 D,结果 `[[A,B],[C,D],[D]]`;空输入在 `items[-1]` 处报错。所以它是“不过”。\n\n- **C · 从 0 开始,每次走 size:**`while i < n`,切片后 `i += size`。五项返回三页、四项返回两页、空输入返回空列表,三个已检查输入都通过。\n\n这里的 B 是原补丁 B,不是 Q17 里只加了 `if items` 守卫的 B1。A、C 的勾来自已经核验的输入;B 的叉来自四项重复与空输入报错。这些勾叉只表示“通过 / 不过”,不是 Q15 树上的 92/96 排序分,也不是对全部合法输入的证明。\n\n### 右边:许多题\n\n这里用四个手写教学示例区分任务:分页、算术、排序、计数。它们不是同一题的四个候选,也不是同一函数的四个回归测试,更不是实测训练日志。每条都保留问题、候选回答与检查结果:\n\n- 分页:[A,B,C,D,E] 每两项一页;回答 [[A,B],[C,D],[E]],通过。\n\n- 算术:17 + 25;回答 42,通过。\n\n- 排序:[3,1,2] 升序;回答 [1,3,2],不过,因为次序不对。\n\n- 计数:字符串 ABC 的字符数;回答 3,通过。\n\n这些记录说明可积累什么材料,不表示只保存材料就自动完成训练。失败的记录也保留;后续使用方式需要明确的训练目标。\n\n\n\n## R-2:Sutton《The Bitter Lesson》(2019) 的历史方向\n\nSutton 回顾人工智能研究史时提出一个反复出现的模式:依赖研究者手工写入领域知识的系统,短期常常有效;但随着可用计算增加,能持续把更多计算用于搜索与学习的一般方法,长期往往走得更远。他举到的领域包括棋类、围棋、语音与视觉等。这里的“教训”是研究策略上的:不要把方法的成败押在为每个例外手写规则上,要给能够随计算扩展的通用过程留出空间。\n\n这是一种历史研究策略,不是任何单个系统的性能承诺。课堂 c0/c1 用它提出可检验的选择:新增计算具体增加了什么,哪一种观察会使我们改判?它没有证明只要记录很多题,学习就一定成功。\n\n\n\n## R-4:把历史论述放回本页边界\n\n- R-2 解释的是为什么“搜索与学习”值得作为方向,不证明本页的多题记录已经能改变模型。\n\n- 更多计算不保证成功。刚看过的反例是:检查没有区分力时,手里有好候选也可能交错答案;问题不在候选数量,而在检查能否区分。\n\n- 默认课堂先给研究选择,随后回到本题候选与多题记录。不把四种方法堆成一张需要背诵的系统总图。\n\n- 本页依据 Sutton 原文作课程转述;研究史论述不是本课程实测数据,也不是一项统一控制条件下的性能实验。\n\n## N2:细读搜索路径与原记录\n\n这一段是阅读练习。先把本课已经发生的搜索路径按当时可见的信息重述一遍,再记录每一步可见的节点与保留规则;不要用后来的结论改写当时看到的东西。\n\n### 已经发生的搜索路径(按当时可见信息)\n\n- **五项:**旧循环漏掉 E,结尾补最后一项后,B 在这个输入上通过;Q13 的首个通过即停把 B 交付。\n\n- **四项:**D 已经在 `[C,D]` 里,B 又补一次 D;B 不再通过,A 在这个输入上通过。\n\n- **空输入:**B 在 `items[-1]` 处报错;A、C 返回 `[]`。\n\n- **交付顺序:**B→A→C,首个通过立即停止。Q13 在 A 通过后交付 A,C 没有在本轮新测;C 的三个输入结果来自 Q12 的并列检查。\n\n- **范围:**这些结果只覆盖已经检查的输入,不证明所有合法输入都正确。\n\n### Q16 下沉到阅读的三种规则\n\n以下采用本课程给定的课堂树。树的分数是教学构造,不是概率、真实过程评分或性能实验。\n\n第一层 S1/S2/S3 的分数是 90/86/78;第二层 S11/S12/S21/S22/S31/S32 是 91/88/84/70/95/65;六个完整叶 L11/L12/L21/L22/L31/L32 是 92/89/83/69/96/66。每个 Sij 只有一个对应 Lij;L11 对应补丁 A,L31 对应补丁 C。\n\n| 规则 | 第1轮保留 | 第2轮保留 | 完成的叶子 | 选中终点 |\n| --- | --- | --- | --- | --- |\n| Best-of-6 | 全部 | 全部 | 六叶 | L31:96,C |\n| Beam 2 | S1、S2 | S11、S12 | L11、L12 | L11:92,A |\n| 三组各1 | S1、S2、S3 | S11、S21、S31 | L11、L21、L31 | L31:96,C |\n\n按 Beam 2,当时只根据可见的 90/86/78 留 S1/S2,下一轮从四个当前节点中选 91/88,因此两个名额都来自 S1。没有展开 S3 时,不能假装已经知道 L31=96。原 Q16 的分组规则则每个方向各留最好一条,让 S3 的方向能被走完。\n\n三种规则分别完成 6/2/3 个叶子;生成与中途评分都消耗计算。不能只凭最终 96 高于 92 就宣布分组更强。对照时要同时记录当时可见的集合、保留集合、生成叶子数、评分次数与所用规则,再在共同预算下比较;这里只恢复课堂给定轨迹,没有性能实测。\n\nN2 进阶:改变宽度 1/2/3,或把 S3 的 78 改为 87;先预测是否保住通往 L31 的方向,再列出逐轮可见与保留节点。挑战:写出一个明确的保留规则,并给出它可能错失好解的反例。\n\n研究中的 Best-of-N、Beam、分组搜索是外部计算流程;本课堂树不代表推理模型内部必然采用同一算法。可继续读[搜索、覆盖与选择的完整解释](handbook.html#R2),并在[LAB02](labs.html#LAB02)改变规则后比较自己的预测。\n\n### 成本口径\n\n这里的计算成本至少有三部分:生成新候选、给当前路径评分,以及用反例运行检查。完成6/2/3个叶子只计了生成结果的数量,不能代表三条规则有相同总成本。比较时还要记录每轮评分次数、每次检查用时、各候选生成长度与依赖造成的等待。检查更多也不等于检查有区分力;同时记录它花了多少,以及是否改变了保留或交付选择。\n\n### 写下两句话\n\n第一句:本课哪一次检查有区分力,改变了交付选择?第二句:哪一次检查没有区分力,重复很多次也不会改变选择?第二句要能说明理由,而不是只写“再仔细一点”。\n\n## 证据边界\n\n### 这页能说明\n\n- 搜索与学习都继续利用计算,但一个作用于这一次的比较与交付,一个作用于许多题的记录与以后。\n\n- 左边的三个候选属于同一题;右边的四条记录属于不同题,失败的记录也保留。\n\n- b1 只留问句和 A✓、B✗、C✓;B 是原 B,不是 Q17 的 B1。\n\n- 更多计算不保证成功;检查没有区分力时,有候选也可能交错。\n\n### 这页尚未建立\n\n- 没有解释训练怎样更新模型,也没有回答 b1 的机制问题;后续先从 Q19 的检查范围开始,再进入训练机制。\n\n- 没有运行真实训练,也没有测量学习效果;右边的记录是教学示例,不是实验结果。\n\n- 三种规则的比较同时受生成数和评分成本影响;不能只比最后一个分数。\n\n- 不声称 A、C 对所有合法输入正确,也不声称更多算力必然带来更好结果。\n\n## 来源\n\n- 分页补丁、搜索树与四选项均为课程教学构造;代码结果与评分口径在本页逐项列明。\n\n- [Sutton, R. S. (2019-03-13). The Bitter Lesson,原文保存版](https://www.cs.utexas.edu/~eunsol/courses/data/bitter_lesson.pdf)。本页为教学转述,四选项为课程构造。\n\n\n\n[逐页目录](#page-index) · [返回 Q19 课堂](index.html#/Q19/b0) · 实验 [CLS01](labs.html#CLS01) · [LAB01](labs.html#LAB01)\n\n# “通过”,要带上检查范围\n\n这一页处理一个容易被一句话抹掉的差别:有限测试通过,不能自动扩大成所有输入、所有环境都可靠。b0 只摆三行已有证据,并把“线上此刻:尚未观测”固定在旁边,最后停在问句上;b1 才把“不能”说出来,划去“补丁已完全可靠”,保留写清范围的那一句;b2 用一条索引带解释 A 的遍历为什么相接、不重叠、到末尾截断、空输入没有起点。测试留下检查过的例子,论证解释一类输入为什么成立,两者不能互相冒充。\n\n## 这页要判断什么\n\n三行证据不是同一种结论。第一行“五项输入,A/B/C 都通过”只说明这个长度为五的列表样例;第二行加四项与空输入,把 B 分开,A/C 仍通过;第三行把本地检查扩到长度 0–20、size 1–8 的 21 × 8 = 168 个组合,A/C 未发现失败。168 表示检查组合数,五项表示单个列表的长度,两者不是同一种计数。这些组合仍然是有限、本地的检查,不是全部合法输入,也不是线上环境。\n\n画面右侧始终保留“线上此刻:尚未观测”。这不是一个通过或失败的结论,而是说:没有线上日志,也没有线上测量。把本地结果写成“线上也可靠”,等于把没检查的部分也算进结论。\n\nb2 的区间图解释的是 A 的遍历为什么覆盖输入。它不冒充 A/C 两个实现的形式证明;完整论证还要照实际代码检查:有没有改输入、size 是否为正、列表是否有限、边界条件是否满足。这几项前提留在阅读层,不在投影上堆成证明。\n\n## b0 · 三行证据,一个还不能回答的问句\n\n### 第一行:五项输入\n\n五项输入下,A、B、C 都通过。这一行只说明这三个补丁在这个长度为五的列表样例上都能给出通过的结果;它没有把 B 和 A/C 分开。讲稿里的“五项例子没有把三个补丁分开”,说的是检查的区分力,不是三个补丁已经等价。\n\n### 第二行:加四项、空输入\n\n四项时,B 的“循环后补最后一项”会把已经包含在 `[C,D]` 里的 D 再补一次;空输入时,B 仍要取 `items[-1]`,在那里报错。A、C 在这两个输入上仍通过。于是 B 出现反例,A/C 没有被这两个输入分开。\n\n### 第三行:168 个本地组合\n\n长度从 0 到 20,含两端,共 21 个;size 从 1 到 8,含两端,共 8 个;21 × 8 = 168 个组合。A、C 在这 168 个组合中未发现失败。这里的“未发现失败”与“通过列出的检查”限定于这 168 个组合,都不表示已经证明所有合法输入。\n\n这 168 个组合是已有本地教学检查,不是本次实时运行,也不是生产环境的测量。本页展示引用既有检查记录,不以这段展示宣称现场执行了测试。没有出现失败,只说明在这张有限的表里没有找到反例;它不自动覆盖 21 以上的长度、8 以上的 size、size = 0,也不覆盖线上状态。\n\n### 右侧:线上此刻\n\n画面右侧只有“线上此刻:尚未观测”和“线上状态未核验”,用一个虚线观察标记,不给绿色勾,也不给红色叉。线上未知不是失败,也不是通过;它是尚未取得的观测。b1 的保留句会把这一点继续写下去。\n\n### 末问\n\n检查三个输入后,仍不能在报告里写“所有情况都没问题”。有限运行只说明这些输入;要支持所有合法输入,需要补充覆盖整个输入域的论证。\n\n## b1 · 同一句“通过”,写到哪里\n\nb1 把 b0 的三行证据缩成左侧固定参照,右侧只比较两句话:\n\n- **划去:**“补丁已完全可靠。”——它把已经检查的部分和没有检查的部分混在一起,下一个接手的人无法知道边界在哪里。\n\n- **保留:**“A/C通过列出的168个本地组合;线上状态未核验。”——它同时留下做过什么、没做什么,以及什么还值得查。\n\n后一句不只是更谨慎,它更有用。前者把“本地通过”直接扩大成“完全可靠”,后者把本地 168 个组合与线上未核验分开。保留句里的“线上状态未核验”没有绿色通过勾;线上未知不能用绿色勾表示。左侧参照中的 A/C 通过是本地检查的通过,不是线上通过。\n\n讲稿还补了一句边界:测试表不是万能证明。要说明一整类合法输入为什么成立,还需要看实现和规则是否对得上。b1 不提前展开 b2 的覆盖论证,只把“写清范围”这件事立住。\n\n## b2 · 用相接解释覆盖\n\n投影用 size = 4、n = 10 的索引带做具体对象:索引 0 到 9,共 10 个位置。A 的起点每次加 size,所以依次是 0、4、8;对应的三段是 [0,4)、[4,8)、[8,10)。前两段是完整的 4 个位置,最后一段只有 2 个,因为到列表末尾 n = 10 就截断。\n\n### 接缝\n\n[0,4) 含左端 0,不含右端 4;[4,8) 含左端 4。前段的右端空心,后段的左端实心,两个标记落在同一处接缝上、分居索引带上下,表示它们相接但不重叠。索引 4 只属于后一段,不属于前一段;不存在一个索引同时落在两段里。\n\n### 末尾截断\n\n如果长度不是 size 的整数倍,最后一段不会补满 size 个位置,而是在 n 处停下。[8,10) 只有两个位置,不是四个;这不是漏项,而是到末尾就截断。\n\n### 空输入\n\nn = 0 时,起点集合为空:没有 0 这个起点,也没有任何一段。A 返回空列表。画面用“空输入 [ ] → 无起点 → 返回 [ ]”表达,不画一个假的起点。\n\n投影主文只有一句:“相接,不重叠;到末尾截断;空输入无起点。”区间图是具体对象,不是同心圆分类;它只解释 A 的遍历,不冒充 A/C 两实现的形式证明。完整论证的前提与证明见下面的 R-3。\n\n\n\n## N1 · 回归检查:21 × 8 = 168 个组合\n\n这是阅读层的回归说明,记录已有本地教学检查的范围与断言;本页引用既有检查记录,不能把这段展示写成现场测试。检查范围是长度 n 取 0 到 20 的整数,含两端,共 21 个;size 取 1 到 8 的整数,含两端,共 8 个;21 × 8 = 168 个组合。size = 0 不在范围内,因为分页步长必须为正。\n\n### 性质断言\n\n- **不丢项:**把所有页依次拼接,得到原列表,顺序不变。\n\n- **不重复:**任一索引只出现在一页里。\n\n- **页长:**n > 0 时,除末页外每页长度等于 size;末页长度在 1 到 size 之间。\n\n- **页数:**n > 0 时页数为 ceil(n / size);n = 0 时返回空列表。\n\n- **输入不变:**调用前后 items 相同。\n\n### 期望与实际(代表性组合)\n\n- **五项 [A,B,C,D,E],size = 2:**期望 `[[A,B],[C,D],[E]]`;A 实际相同,C 实际相同,B 实际也相同。这个输入不区分 B。\n\n- **四项 [A,B,C,D],size = 2:**期望 `[[A,B],[C,D]]`;A、C 实际相同;B 实际是 `[[A,B],[C,D],[D]]`,D 重复。这个输入把 B 分开。\n\n- **空输入 [],size = 2:**期望 `[]`;A、C 实际是 `[]`;B 在 `items[-1]` 处报错(IndexError)。\n\n- **168 个组合:**A、C 均未发现失败;B 在四项与空输入上出现反例。B 的五项通过,不能反推成 B 在所有输入上通过。\n\n“未发现失败”是一个有限的负面结果:在这张表里没有找到反例。它不等于“所有合法输入都正确”,也不等于“线上可靠”。同样,B 在两项上失败,不代表 B 在所有输入上都失败;它只说明这两个反例足以排除“B 已完全可靠”这句话。\n\n\n\n## R-3 · A 的遍历覆盖论证\n\n这一段说明 A 的 `range(0, n, size)` 为什么能把输入切成相接、不重叠的页。它是一段有前提的论证,不是对 A/C 两实现的形式证明,也不替代实际运行代码。\n\n### 适用前提\n\n- items 是有限列表,n = len(items),n ≥ 0。\n\n- size 是正整数,size ≥ 1;size = 0 会让 C 的 while 循环不前进。\n\n- 切片按 Python 语义:`items[a:b]` 取满足 a ≤ i < b 的索引;b 超过 n 时截到 n。\n\n- 函数不修改 items,也不在遍历中改变 n。\n\n### 论证\n\n起点集合是 0, size, 2×size, …,即所有满足 k×size < n 的非负整数 k。第 k 页是 `items[k×size : min((k+1)×size, n)]`,对应索引集合 `[k×size, min((k+1)×size, n))`。\n\n取相邻的两个起点 k×size 与 (k+1)×size,并假设后者也小于 n。此时第 k 页的右端是 min((k+1)×size, n) = (k+1)×size,正好等于第 k+1 页的左端;前一段不包含这个右端,后一段包含这个左端。两个半开区间只在这个边界相接,不重叠。\n\n第一段从 0 开始;每一段的右端等于下一段的左端;最后一段的右端是 n。因此这些索引集合的并集正好是 [0, n),每个索引恰好属于一页。若 n 不是 size 的整数倍,最后一段的右端仍是 n,长度小于 size,这就是“到末尾截断”。若 n = 0,不存在满足 k×size < 0 的 k,起点集合为空,返回空列表,这就是“空输入无起点”。\n\nC 的 while 版本从 i = 0 开始,条件 i < n,切片后 i += size。只要 size ≥ 1 且 items 不被修改,它产生的起点与切片族和 A 相同;但这是对遍历形状的对照,不是把两个实现一起形式证明。实际代码是否真的没有改输入、是否真的用了这些边界,仍要逐行看。\n\n### 这还不是什么\n\n这段论证不证明线上行为,不证明 B,也不替代运行代码。它解释的是一类输入为什么能被这种遍历覆盖;测试表提供的是有限例子,两者互补。投影上的区间图只承担这一段的直观部分,完整前提和边界留在这里。\n\n## 练习与阅读边界\n\n- 用 n = 10、size = 4 写出三段半开区间,并指出哪两个索引是接缝上的边界、哪一个属于后一段而不属于前一段。\n\n- 用 n = 0 说明为什么没有起点;不要画一个“从 0 开始但长度为 0”的假页。\n\n- 找出 168 网格没有覆盖的至少两种输入(例如 n = 21,或 size = 9),说明它们为什么仍在 R-3 的论证范围内、却不在 N1 的检查表里。\n\n- 如果 size = 0,A 与 C 各会发生什么?这个例子说明“正 size”为什么是前提,而不是装饰条件。\n\n- 如果函数在循环里修改了 items,R-3 的哪一步会失效?用一句话指出被破坏的前提。\n\n## 证据边界\n\n### 这页能说明\n\n- 五项样例全部通过只覆盖这个列表样例,不能把 B 与 A/C 分开。\n\n- 加四项、空输入后 B 出现反例;A/C 仍通过这两个输入。\n\n- 168 个本地组合中 A/C 未发现失败,但这是有限检查,不是全部合法输入,也不是线上测量。\n\n- b1 的保留句把本地 168 个组合与线上未核验分开;线上未知不用绿色勾。\n\n- b2 的区间图解释 A 的遍历为什么相接、不重叠、末尾截断、空输入无起点。\n\n### 这页尚未建立\n\n- 没有线上观测、日志或生产测量;线上状态仍是未核验。\n\n- 没有给出 A/C 两实现的形式证明;R-3 只论证 A 的遍历形状,并要求逐行核对实际代码。\n\n- 168 个本地组合没有测试长度大于 20 或 size 大于 8 的情况;R-3 的覆盖论证在有限列表、正整数 size、输入不修改等前提下仍适用于这些范围。size = 0 不满足正步长前提。\n\n\n\n[逐页目录](#page-index) · [返回 Q20 课堂](index.html#/Q20/b0)\n\n# 最后都是20,中间两步也都对吗?\n\n这一页把“终值正确”和“每一步合法”分开。两份手写记录最后都写着 20,但甲的两步都符合程序,乙的两步都不符合。b0 只框住终值,停在问句;b1 先说明“仅终值检查:两份都通过”,再沿四条箭头依次复算,最后把输入 4 的预测留在预留区;b2 才把 6、24 填进原位,并留下两条边界:检查的是这份记录是否符合程序规则,不是这些文字是否真的影响某个模型的答案。\n\n## 这页要判断什么\n\n终值相同,不能自动推出过程相同。反过来,过程里出现一个不合规则的数字,也不能因为最后碰巧写对就被盖过去。页面上两份记录都是手写教学构造,不是某个模型的真实轨迹;它们只承担一个用途:让“只看最后一格”和“逐个转移检查”这两种检查方式发生冲突。\n\n先只按终值判断:两份记录最后都是 20,因此都通过这项检查。再逐条检查箭头是否遵守指定运算;最后用输入 4 复核同一规则。终值检查、记录合法性和模型内部因果忠实性是不同问题。\n\n## 程序、输入与两份手写记录\n\n完整程序按函数体的缩进显示如下。讲稿沿用原说法“四行程序”,指的是函数体四行;投影连同 `def` 一行共五行,按合同完整显示。\n\n```text\ndef calculate(n):\n x = n\n x = x + 2\n y = x * 4\n return y\n```\n\n输入是 `n = 3`。函数体先复制输入,再加 2,再乘 4,最后返回。两个转移分别对应第 3 行和第 4 行:第 3 行是 `x = x + 2`,第 4 行是 `y = x * 4`。所以检查一条箭头,就是问它是否执行了这两行中的对应一行。\n\n记录甲写的是 3 → 5 → 20:3 加 2 得 5,5 乘 4 得 20。记录乙写的是 3 → 4 → 20:3 加 2 并没有得到 4;即使暂时接受这个 4,4 乘 4 也应该是 16,不是 20。乙的终值仍然保留 20,因为只有保留同终值,才能让“终值检查”和“步骤检查”真正分开。\n\n## b0 · 只框住终值,先问一句\n\n投影并列显示程序、输入 3、甲 3 → 5 → 20、乙 3 → 4 → 20。两个末格 20 都只加金色边框,不打通过勾。边框只表示“这是要检查的终值”,不表示它已经通过。\n\n右上角固定写“手写教学构造 / 不是模型轨迹”,程序面板底部再写一次“两份记录均为手写教学构造,不是模型轨迹”。这不是装饰性的免责声明,而是本页的事实边界:乙不是某个模型写出的错误推导,不能被当成真实模型行为的证据。\n\n只检查最后是不是 20,无法区分两份中间记录。要识别过程差异,必须把检查对象从终值扩展到各步运算。\n\n## b1 · 沿每条箭头复算,再留一个预测\n\n“仅终值检查:两份都通过”回答的是这项检查的结果,不是对整份记录的最终判决。进一步比较下面四条算式:\n\n- 甲第一步:`3 + 2 = 5`,成立。\n\n- 甲第二步:`5 × 4 = 20`,成立。\n\n- 乙第一步:`3 + 2 ≠ 4`,不成立。\n\n- 乙第二步:`4 × 4 ≠ 20`,不成立。\n\n检查乙时,要分别核对两个转移。第一步已经把 3 加 2 写成了 4;即使暂时接受这个 4,第二步乘 4 也应该是 16,不是 20。所以乙的两个转移都不合法。这里给出 16,是为了说明乙的第二个转移应该得到什么;不能因此把乙的记录改写成 3 → 4 → 16,那会破坏“乙的终值仍是 20”这个对照条件。16 也不是输入 4 的预测答案。\n\n读完四条算式,再把相同的合法规则用于输入 n=4。先自己填写 4 → ? → ?,并说明每一步用了哪条规则。\n\n## b2 · 填完 6、24,留下两条边界\n\n输入 4 时,先按第 3 行算 4 + 2 = 6,再按第 4 行算 6 × 4 = 24。这个新输入检查的是每条箭头是否按规则计算,而不是最后一格能否碰巧得到同一个数。\n\n底部留下两条边界:\n\n- **已检查:**这份记录是否符合程序规则。\n\n- **没有检查:**这些文字是否真的影响某个模型的答案。\n\n第一条是可逐条核对的:每一步的算式是否与程序第 3、4 行一致。第二条不是同一件事。即使换成模型写出的推导,步骤合法也只证明这份文字和规则对得上;它是否真的影响了模型给出的答案,需要另做干预对照。今天不展开第二套研究,只把这个界限留下:查记录,不等于看到了模型内部全部过程。\n\n手写乙只是一份教学构造,用来展示终值检查的盲区;它不是任何真实模型行为或动机的证据。记录检查与模型因果忠实性要分开研究。\n\n\n\n## R-3 · 步骤合法性与模型因果忠实性\n\nR-3 要守住的是两个不同问题,不能用一个问题的答案去替代另一个。\n\n### 步骤合法性\n\n步骤合法性是文字与规则是否符合。给定程序第 3 行 `x = x + 2` 和第 4 行 `y = x * 4`,一条记录是否合法,可以逐步核对:这一步用的数对不对,执行的运算对不对,结果对不对。乙的第一步写 3 加 2 得 4,不符合第 3 行;第二步写 4 乘 4 得 20,也不符合第 4 行。两条都能被具体指认,不靠印象。\n\n### 模型因果忠实性\n\n模型因果忠实性问的是另一件事:这些写出来的文字,是否真的影响了模型给出的答案。一段推导看起来合法,可能只是事后写出的解释;一段推导看起来不合法,也可能不是模型实际使用的中间过程。要判断“文字是否影响答案”,需要另做干预对照:在控制输入和其他条件的情况下,改变或移除这段文字,观察答案是否随之改变。只读文字、只看它是否合规则,不足以回答这个问题。\n\n所以本页的“检查”有两个层次:投影上完成的是记录与程序规则的逐条对照;阅读层保留的是“这还不是模型内部全部过程”的边界。前者可以作为课堂上的可核对练习,后者需要单独的研究设计。不能把前者冒充后者,也不能因为后者困难就放弃前者的精确性。\n\n### 手写记录的证据范围\n\n乙是手写的教学构造,不是某个模型的真实输出。它的作用是让终值检查在一个受控的小例子里无法区分两份记录;本页不从这份记录推断真实模型的行为或动机。\n\n承转句保留:“不过,检查也不总是在判真假。有时两个都对,我们还要选更合用途的那个。”下一页会从“判断真假”转向“在多个都成立的回答里选更合用途的那个”;本页不提前展开。\n\n## 练习\n\n- 按程序把输入 4 走完,写出两步算式和终值。先自己做,再对照 b2 的 6、24。\n\n- 指出乙的两个转移分别违反了第几行;如果只允许改一个数字,能不能把乙改成一条合法记录而仍然保持终值 20?说明理由。\n\n- 用一句话区分“这份记录符合程序规则”和“这些文字真的影响了模型的答案”。各举一个本页能支持、或不能支持的例子。\n\n- 如果只检查最后一格,甲和乙的结果是什么?这个结果能不能区分两份记录?\n\n- 把“乙的最后也是 20,所以乙也通过”改写成一句带检查范围的陈述,要求同时写出检查了什么、没有检查什么。\n\n练习核对(先自己做)\n\n输入 4:第 3 行 4 + 2 = 6;第 4 行 6 × 4 = 24。乙第一步违反第 3 行,第二步违反第 4 行。可以只改一个数字:把共享的中间值 4 改成 5,得到 3 → 5 → 20,两个转移同时合法且终值仍为 20。两个转移不合法,不等于必须修改两个数字。本页检查原记录时仍保留 3 → 4 → 20;这道练习另问如何修复它。只查终值时甲乙都得到 20,无法区分;逐个转移检查才能区分。带范围的陈述可以写成:“仅检查最后一格是否等于 20 时,甲乙都通过;这个检查没有核对中间转移。逐个核对程序规则时,乙的两个转移都不成立。”\n\n## 证据边界\n\n### 这页能说明\n\n- 终值同为 20 的两份记录,可以有不同的步骤合法性。\n\n- 甲的两步都符合程序第 3、4 行;乙的两步都不符合。\n\n- 乙即使被暂时接受第一步的 4,第二步也应得 16,而不是 20。\n\n- 输入 4 按同一程序走完是 4 → 6 → 24。\n\n- “记录是否符合程序规则”和“文字是否真的影响模型答案”是两个不同检查。\n\n### 这页尚未建立\n\n- 这两份记录不是从真实模型采样得到,也不展示模型内部过程;它们都是手写教学构造。\n\n- 没有证明任何模型的因果忠实性;那需要另做干预对照。\n\n- 手写乙不构成任何真实模型行为或动机的证据。\n\n- 没有把“终值相同”扩大成“所有步骤都通过”,也没有把“步骤合法”扩大成“模型内部过程已被看见”。\n\n\n\n[逐页目录](#page-index) · [返回 Q21 课堂](index.html#/Q21/b0)\n\n# 都算对了,还要看拿来做什么\n\n这一页不判两份答案谁真谁假,因为两份算术都等于 48。它问的是:同一个正确答案,换一个用途,是否还该选同一份写法。b0 让两份回答与两种用途同时出现,但不连线、不选中;b1 才在原位连出「填一格结果 → 甲」「向初学者解释 → 乙」,随后把整组对象收为上方参照,再回到 A、C 的检查与「更喜欢 ≠ 更准确」。\n\n## 这页要判断什么\n\n4×12 等于 48。甲只写 48;乙写成 4×10+4×2=40+8=48。两份算术都对,所以「哪份算错了」不是这一页的问题。页面上并排出现的是两份回答和两个任务用途:填一格结果、向初学者解释。\n\n先问“换一个用途,还会总选同一份吗?”两份回答可能都没有事实错误,但不同用途会改变应当保留的细节和表达方式。要把用途与选择理由连起来。\n\nb1 的配对是:填一格结果 → 甲,短答案够用;向初学者解释 → 乙,拆分可能更有帮助。这里的「可能更有帮助」只针对这个用途,不是「解释永远该选长答案」,也不是「乙在所有场合都更好」。换一个用途,「更好」的标准就变了;用途不说清楚,「更好」没有稳定的意思。\n\n## 4×12 与两份都对的回答\n\n题目是 `4×12`;甲:`48`,只保留结果。\n乙:`4×10+4×2=40+8=48`,把 12 拆成 10 加 2,分别乘 4,再相加。\n\n两份都落在 48,所以这一页的比较不是正确性比较,而是适用性比较。填一格结果只需要一个数,短答案够用;向初学者解释时,拆开的过程能把「为什么是 48」显示出来,可能更有帮助。这个判断依赖任务条件,不是给某一种写法发普遍通行证。\n\n反过来也要守住:短答案不是「偷懒」,长写法也不是「更高级」。如果表格只容一格,塞进整段拆分反而增加负担;如果目标是让初学者看懂,只给 48 就少了可追踪的中间步骤。用途先说清楚,才有稳定的「更合适」。\n\n## b0 · 同显但不配对\n\n投影上四张对象同时出现:两份回答在右侧,两张用途卡在左侧。中间留出连线区,但不画线;两张用途卡样式相同,两份回答也不打勾、不描边强调。这个中性状态是刻意的:学生先看到「同一道题有两份都对的回答」,再看到「任务有两种用途」,然后自己判断它们是否总要选同一份。\n\n请先分别为两种用途选择回答,并写下理由,再看下面的对照。\n\nb0 的投影、notes、无障碍描述里都不出现 b1 的配对与理由。b1 才把「短答案够用」「拆分可能更有帮助」放到连线上;在 b0 的 DOM 里,这两句理由为空,A/C 面板也不生成内容,避免隐藏文本提前泄露答案。\n\n## b1 · 原位连起来,再收为参照\n\n两种用途对应不同的选择理由:\n\n- 填一格结果 → 甲:短答案够用。\n\n- 向初学者解释 → 乙:拆分可能更有帮助。\n\n两条线随讲解依次出现,先填格→甲,再解释→乙,已经出现的连线和理由保留,不清屏、不重排。随后整组对象连同连线一起缩为上方参照,甲乙仍在原位,不丢线、不换身份。下方才出现 A✓ C✓ 与两行结论:\n\n- 先查满足任务条件;再按约定选更合用途。\n\n- 更喜欢 ≠ 更准确。\n\n这个顺序很重要:先看用途,再回到检查。用途偏好不是正确性判决;它只在「两份都满足任务条件」之后,帮助我们在都合格的写法里选一个更合适的。若任务条件还没满足,偏好再强也不能替代查漏项。\n\n## A 与 C:只过列出的检查\n\n投影下方出现 A✓ C✓,只表示 A 与 C 都过了我们列出的检查。它不表示:\n\n- A 比 C 更好,或 C 比 A 更好;\n\n- 两份在改动大小、可维护性上有某个分数;\n\n- 它们已经普遍正确,或已经跑过所有测试。\n\n两份都过检查之后,可以继续比较改动大小、是否好维护,也可以按任务约定选更合用途的那份。但这些比较仍要说明依据,不能用一个虚构的维护性分数替代。喜欢 A 的写法,不能代替验证 A 没有漏项;喜欢 C 也一样。\n\n这一页不指定 A 或 C 的胜者,也不虚构任何评分。勾只对应「列出的检查」这一层,离开这一层就不能继续借用它的结论。\n\n\n\n## 检查结果与用途偏好怎样分开?\n\n程序测试核对列明输入与输出;形式论证在明确前提下说明一类输入;人工或模型评判可以评价可读性、用途等软条件。这些依据不能互相冒充:测试通过不自动等于最易维护,评判者偏爱也不等于代码满足契约。\n\n本页回答“两份都过检查之后,怎么按用途选”。[R3:测试通过以后究竟知道了什么](handbook.html#R3)继续解释检查范围与覆盖论证。本课没有给出这些检查器的通用误差率;若要估计,须先规定任务分布、独立核对标准和评测样本,不能由A/C两个勾计算出来。\n\n「部分计划看起来有希望」也不是「已经跑过测试」。不同信号都可能有用,但关键是别把它们互相顶替:看起来有希望、通过列出的检查、真的影响答案,是三件需要分别核对的事。\n\n## 练习\n\n- 4×12 的两份写法都得 48。为什么不能据此说「用哪份都一样」?请把理由落在任务条件上。\n\n- 给「填一格结果」和「向初学者解释」各选一份,并各写一句理由。理由要指向用途,不能只写「更长」或「更短」。\n\n- A、C 都过了列出的检查。能不能据此说 A 更好?还需要什么信息?\n\n- 「我更喜欢 A 的写法」能不能代替「A 没有漏项」的检查?说明这两种说法的差别。\n\n- 「部分计划看起来有希望」为什么不算「已经通过测试」?如果要判断它是否真的有效,还需要做什么?\n\n练习核对(先自己做)\n\n1. 两份都等于 48,只说明正确性相同;用途改变时,合适写法可能改变。填一格需要短答案,向初学者解释需要可追踪的拆分,所以不能从「都算对」推出「总选同一份」。\n\n2. 填一格结果选甲:短答案够用,一格能放下。向初学者解释选乙:拆分显示 4×10 与 4×2 再相加,过程可追踪;理由指向用途,不指向「长度本身更好」。\n\n3. 不能。A、C 只表示过了列出的检查;要比较还需要具体任务条件与可说明的依据,比如改动大小、是否好维护。也不能虚构一个维护性分数来排名。\n\n4. 不能。偏好说明「我更喜欢哪种写法」,检查说明「这份写法有没有漏项」;前者不能替代后者。喜欢 A 仍要验证 A 没有漏项。\n\n5. 「看起来有希望」是弱信号,不是测试结果。要判断是否有效,需要按任务条件实际检查,必要时做对照;不能把不同信号互相顶替。\n\n## 证据边界\n\n### 这页能说明\n\n- 同一个正确答案可以有不同写法,两份算术都等于 48。\n\n- 用途改变时,更合适的写法可能改变;填一格结果与向初学者解释指向不同选择。\n\n- 「短答案够用」与「拆分可能更有帮助」都是用途理由,不是正确性判决。\n\n- A、C 都过了列出的检查;通过检查之后仍可按任务约定比较用途。\n\n- 更喜欢一种写法,不等于它更准确,也不等于它没有漏项。\n\n### 这页尚未建立\n\n- 没有证明「向初学者解释永远该选长答案」;只是这个用途下拆分可能更有帮助。\n\n- 没有给 A、C 任何维护性分数、排名或胜者。\n\n- 没有证明「部分计划看起来有希望」已经通过测试。\n\n- 没有把 Q13 的「首个通过立即停止」当成普遍默认规则。\n\n- 没有测量检查器的通用误差率;实际估计还需要独立核对标准和评测样本。\n\n\n\n[逐页目录](#page-index) · [返回 Q22 课堂](index.html#/Q22/b0) · 实验 [CLS02](labs.html#CLS02)\n\n# 这一次选出来,和以后学会,是两条路\n\n同一份“B 重复了 D”的检查报告,可以改变现在交付哪个答案,可以成为下一次生成的输入,也可以成为训练数据的一部分。三个去向并不等价。先问反馈进入哪里、什么对象实际改变,再判断这是不是模型学习。\n\n\n\n## 同一参数,仍然需要完成这一次计算\n\n模型参数 `θ` 中已有可复用的 Python 能力,但它仍要结合这一次的输入、约定与具体程序完成求解。参数不是每道题答案的专属抽屉。Q06–Q09 已展示:中间推导写入工作上下文后,后续 token 可以利用这些状态;这与从参数中直接“取出一个现成补丁”不同。\n\n本页继续用分页例子。同一组参数生成 A、B、C,检查发现 A、C 通过列明的检查,B 在四项输入中重复 D。于是本次选择 A。整条路径可以包含多次模型调用、代码运行和检查;只要没有参数更新,`θ` 就保持固定。选 A 是本次课堂给定的选择,不是以后永远选 A 的规律;A、C 通过有限检查也不自动证明适用于所有输入。\n\nQ17 中,空输入报错被放回提示,模型再生成 B1。新的报错改变了下一次可读的材料;模型能够据此修补,但仍须复查四项输入。对话中的修正不会自动写进模型参数,下一次独立调用也不会自动获得它,除非系统再次提供相关上下文或记录。\n\n\n\n## 同一检查结果,三种去向\n\n- **用于本次选择:**检查器给出 A✓、B✗、C✓,程序不交付 B。改变的是本次候选排序与选择;参数可以不变。\n\n- **用于下一次调用:**把 B 的输入、实际输出和“D 重复”的说明接回提示,让模型推导或改写 B1。改变的是下一次的工作上下文;参数通常仍不变。只放一句“错了”不如保留可重现的条件。\n\n- **用于模型训练:**把多道题的问题、回答与检查结果组成数据,定义训练目标,经梯度和优化器真正更新共享参数,得到 `θ′`。改变的是未来不同输入上的生成倾向;训练完成后还需用未见问题重新评估。\n\n因此,“模型看到了反馈”“这次答案修好了”和“模型已训练过”是三个不同判断。复述刚才的修正,不能证明参数已经更新。训练也不是把某个补丁写进只服务这道题的存储格:共享参数变化可能影响其他任务,既可能带来泛化,也可能引入新的退化。\n\n\n\n## 同一任务中的四种可组合的作用\n\n**提示与中间计算:**给普通模型一个 CoT 示例,或让它列出 n、size、循环起点和切片结果,会改变它在本次求解中可使用的上下文。已有生成状态能影响后续输出,本次使用通常不更新模型参数。普通模型也可以有推理能力;“专门后训练的推理模型”不是“唯一能推理的模型”。\n\n**外部搜索与验证:**程序可以组织多次调用、保留部分路径、运行多个候选、按检查结果选择或回溯。这改变的是求解流程及计算分配,内部调用的模型参数仍可固定。提示模型多想、在外部展开搜索树、训练模型更善于求解,不能只因为都用了更多计算而视为同一个机制。\n\n**推理后训练:**o1、R1 这类经过专门后训练的模型,通过训练改变参数与求解行为,使它们在使用时以不同方式利用计算。它不是只换一句提示,也不等于在未变的模型外面套一个搜索脚本。Q26、Q27 会用具体研究证据讨论这条路径;不同研究的训练阶段、基座、奖励与评测条件不能混成一个必要定义。\n\n**工具与运行环境:**真正运行 B、读取测试输出或查询当前日志,可以带来输入文字中没有的新观察。模型可以推导可能发生什么,但当前服务器是否超时、文件究竟如何编码、外部系统是否执行成功,可能必须取到实际观察。工具返回结果再进入上下文,才影响接下来的选择或生成;调用工具本身不等于更新参数。\n\n四种作用可同时出现:一个经过后训练的模型,可以在程序组织的搜索过程中展开中间计算,运行代码取得反馈,再据此改写。它们不是四种互斥模型,也不是每项研究必经的四个历史阶段。诊断失败时,关键是明确**改变了什么、反馈进入哪里、下一次生成怎样受影响**。\n\n\n\n## 反馈也可能错,接到哪里就影响哪里\n\n如果测试漏掉空输入,或把重复记录误判成通过,这份错误信号可能让程序选错答案、让下一次调用朝错误方向修改,也可能让错误回答进入训练。任何一个环节都不能仅凭“已经有反馈”就自证正确。Q23–Q25 接着讨论检查信号进入训练的具体方式和局限。\n\n更可靠的做法是保留契约与测试条件,区分有限测试、覆盖论证和用途要求,再在未用于选择或训练的输入上检查。现有 [LAB03](./labs.html#LAB03) 比较同一检查信号的筛选、反馈与相对信号;它不训练模型,也不提供训练后频率的实测结果。\n\n\n\n## 练习:只改一个去向,会发生什么?\n\n- 对 B 的重复错误报告,分别描述“用于当前选择”“放回下一次提示”“用于梯度更新”之后,哪个对象改变、哪个对象可以不变。\n\n- 已经使用 o1/R1 这类模型,为什么仍可以在外部组织候选搜索和运行检查?\n\n- 模型在对话里重复了正确的循环边界,能否据此认定训练成功?缺哪项证据?\n\n- 本地补丁都通过列明检查,但不知道当前服务是否仍然超时。多生成一份解释和读取获准的当前日志,分别能带来什么?\n\n核对思路\n\n选择改变本次交付;上下文改变下一次可读状态;训练才通过目标与优化更新参数。后训练与外部搜索可组合。对话内复述不证明参数变化,训练效果还需未见题评估。当前服务状态需要新观察,文字推导只能提出解释与可检验预测,不能伪造实时事实。\n\n## 来源与后续阅读\n\n- [OpenAI,Learning to reason with LLMs,2024-09-12](https://openai.com/index/learning-to-reason-with-llms/):o1 的后训练和使用时计算;本页用它说明具体研究路径,不据此为所有推理能力规定必要定义。\n\n- [DeepSeek-R1,v1,2025-01-22](https://arxiv.org/html/2501.12948v1):R1-Zero 与 R1 的训练安排需区分;具体证据见 Q26。\n\n- [R4 反馈与训练深读](./handbook.html#R4):筛选模仿、奖励与相对信号;外部记录的长期保存接到后续记忆课程。\n\n\n\n[逐页目录](#page-index) · [返回 Q23 课堂](index.html#/Q23/b0) · 实验 [LAB03](labs.html#LAB03)\n\n# 把高分的回答,更常写出来\n\n这一页把上一页的检查信号送进训练。b0 只追一条回答 B:它在同一份四项检查里重复了 D,得 0;A、C 通过,各得 1。随后停在一个假设问句上,不回答。b1 才回答:训练不会自动知道检查错了,只能利用实际给出的信号;然后用三条目标示意带说明“更常出现”是目标,不是测得的概率。\n\n## 这页要判断什么\n\n训练按反馈改变生成倾向,不保证每次改进。检查在这里提供训练信号:B在四项输入中重复D,因而在这项检查下得0;评分会按约定的训练规则使用。若检查把有问题的写法打成高分,仅凭这项信号不能辨认它是否误判;发现缺口需要额外的检查或评估。\n\n本页先回答一个正向问题:能否把这一次检查带来的区别,转成未来更有用的生成倾向?同时区分目标与证据,不把示意带当成实验结果。下一页才沿同一个 B,区分“只保留通过者模仿”和“把 B 的低分也作为比较信号”两种用法。\n\n## b0 · 追 B 进检查器\n\n三张候选卡沿用前面同一组身份:A 改停止边界,B 保留旧循环并在循环后补最后一项,C 从 0 开始、每次走 size。指定检查仍是四项输入 `[A, B, C, D]`、`size = 2`,期望 `[AB]` `[CD]`。\n\nA、C 的输出是 `[AB]` `[CD]`,通过,各得 1。B 的输出是 `[AB]` `[CD]` `[D]`:D 已经在第二页里,循环结束后又补了一次,所以同一个 D 出现两次,B 未通过,得 0。右侧评分栏常驻 1 / 0 / 1,标签写明这是这份检查的评分,不是训练后的表现。\n\n再考虑一个反例:如果检查把有问题的写法打成高分,训练会自动知道检查错了吗?这里说的是错误奖励的假设,不是刚才那份检查的实际结果。训练只能使用给定信号,不能把奖励自动当成真值。\n\n## b1 · 回答与目标示意\n\n进入后才回答:不会自动知道。训练只能利用实际给出的信号;如果检查给了错误的高分,这个高分就是它要利用的信号,它不会另外知道“检查错了”。\n\n接着回到原来可靠区分 B 的检查:A、B、C 仍是 1 / 0 / 1。这里不是在演示刚才那个错误奖励假设,评分栏也标为“原检查评分”。三条带从等宽出发:A、C 略宽,B 略窄。宽窄表示我们想推动的方向——让通过者更常出现、让未通过者更少出现——不是实验测得的概率。\n\n图上常驻两句话:“训练目标示意,不是测得的概率”“更常出现是目标,不是每次更新的保证”。实际更新同时受其他样本、学习率和约束影响,不能保证每次都按这幅小图变化,更不能保证新题一定正确。\n\n## 为什么错误奖励不会被自动发现\n\n训练目标利用给定的信号。错误高分可能让有问题的回答进入模仿或获得训练偏好;具体是否推动它,要看评分进入哪种训练规则,不能仅由一个高分断言。仅凭这项奖励,也不能自动发现检查本身的错误。\n\n要发现检查本身的缺口,需要另外的评估、人工复核或新的检查设计,不能指望训练自动完成。本页只说明这条边界;下一页才展开两种训练用法,也不在这里挤进训练算法名录。\n\n## 示意带不是概率\n\n带子的宽窄是课堂示意,不是训练后的频率测量。页面不写具体概率数字,也不暗示训练后一定按这个比例生成。现有LAB03只计算检查、筛选和相对信号,不训练模型,也不测量训练前后的频率。\n\n两条常驻标签分别防止两种误读:一是把示意带当成测得的概率;二是把“更常出现”当成每次更新都会兑现的保证。实际更新受其他样本、学习率与约束影响,更新后也不保证新题正确。\n\n## 现有LAB03、下一页与本页的分工\n\n现有LAB03比较检查覆盖、筛选集合和相对信号,不进行模型训练。若要比较训练前后的样本频率,还需要另外固定模型、训练集、预算和评测集做训练实验;本课没有交付这一实测。本页回答的是“检查信号进入训练时,训练会不会自动知道检查错了”,并给出“目标是方向、不是实测概率”的边界。实验入口见[LAB03:同一检查信号的三种去向](./labs.html#LAB03)。\n\n下一页沿同一个 B,分开两种训练用法:只保留通过者模仿,还是把 B 的低分也作为比较信号。这个区分留到下一页展开,本页不提前替它下结论。\n\n## 练习\n\n- b0 的检查给 A/B/C 1 / 0 / 1。这能不能推出“训练会自动纠正检查错误”?为什么?\n\n- 如果检查把有问题的 B 打成高分,训练会怎样利用这个信号?它会不会另外知道“检查错了”?\n\n- b1 的带子为什么不能读成“训练后 B 的概率是多少”?\n\n- 实际更新还受哪些因素影响?为什么不能保证新题正确?\n\n- 下一页沿同一个 B 要区分哪两种用法?\n\n练习核对(先自己做)\n\n1. 不能。1 / 0 / 1 只说明这份检查在这次四项输入上的评分;训练利用的是信号,不会自带真值核对。\n\n2. 它会按约定的训练规则使用这个高分;是否推动这类写法,要看具体规则,不能只凭绝对分数判断。仅凭这项奖励不能自动知道检查错了。\n\n3. 因为带子只是目标示意,不是测得的频率;页面不提供概率数字,也不代表训练后的实际比例。\n\n4. 其他样本、学习率、约束等。更新是局部的,不能保证每次更新都改善,也不能保证新题正确。\n\n5. 只保留通过者模仿,还是把 B 的低分也作为组内比较信号。\n\n## 证据边界\n\n### 这页能说明\n\n- 检查把 B 判为 0、A/C 判为 1,形成 1 / 0 / 1 的训练信号。\n\n- 训练不会自动知道检查错误,只能利用实际给出的信号。\n\n- 示意带的宽窄表示目标方向,不是测得的概率;更常出现是目标,不是每次更新的保证。\n\n- 实际更新受其他样本、学习率与约束影响,不保证新题正确。\n\n- 评分标签常驻;b1 明确回到原检查的 1 / 0 / 1,不是错误奖励假设。\n\n### 这页尚未建立\n\n- 没有给出训练后的实测概率,也没有具体概率数字。\n\n- 没有暗示训练会自动纠正错误奖励。\n\n- 没有展开具体训练算法;筛选模仿与组内比较留到下一页。\n\n- 现有 LAB03 只计算信号,不训练模型;示意带不是实验数据。\n\n## 来源\n\n- [R4:反馈进入训练的机制与原始来源](./handbook.html#R4)\n\n\n\n[逐页目录](#page-index) · [返回 Q24 课堂](index.html#/Q24/b0) · 实验 [CLS02](labs.html#CLS02) · [LAB03](labs.html#LAB03)\n\n# 同一个低分B,可以被丢掉,也可以成为负信号\n\n这一页沿同一个低分 B 走两条训练去向:b0 只保留通过者模仿,B 不进入样本;b1 把 B 留在组内,用 1 / 0 / 1 的平均 2/3 做中心化,得到 B = −2/3、A/C = +1/3,并停在“奖励有没有告诉模型某一个词应该换成什么”上;b2 才回答“没有,它评价的是整条回答”,再把两条路并排比较,留下一个跨页问题。\n\n## 这页要判断什么\n\n同一个检查、同一个低分 B,可以进入两种不同的训练用法。第一种是筛选:只保留通过的回答,B 不进入模仿样本。第二种是组内比较:B 不丢掉,和同一组的平均比,低于平均就得到一个负向信号。\n\n两条路都依赖检查质量。检查只查代码执行时,回答里未被检查的推导也可能随整份回答进入模仿;通过者可以当训练材料,不等于每一句都已经核实。\n\n本页是机制示意,不是完整可执行算法。r − mean 不是完整 GRPO;完整标准化、概率比、剪裁、KL/约束与零方差处理放在 [R4:筛选模仿与 GRPO 的完整目标及边界](handbook.html#R4)。\n\n## b0 · 筛选后模仿\n\nB=0,A/C=1。筛选只看整份回答是否通过:B 不进入这批模仿样本;A、C 进入“问题+通过回答”的训练样本。页面上三张回答卡分别标出 1 / 0 / 1,B 的整份回答被留在样本外。\n\n进入训练后,模型读问题和回答已有的前缀,预测下一个词。目标就是这份回答接下来实际写的词,不是检查器逐词给的标准答案。投影用 A 的代码片段 `range(0, n, size)` 示意一个位置:已有前缀 `range(0, n,` 的下一个片段是 `size`。\n\n这里只示意一个位置,不声称真实分词边界,也不给逐 token 奖励。检查器只判整份回答是否通过,不逐个位置提供目标。\n\n如果只检查代码执行,回答里附带的一段推导没有被检查,它也会跟着进入模仿。通过者可以当训练材料,不等于回答中的每一句都已经核实。\n\n## b1 · 组内比较\n\nB 也留下。A、B、C 分别得 1、0、1,这一组平均是 2/3。四步算术是:\n\n- ① 奖励:A=1,B=0,C=1。\n\n- ② 平均:(1+0+1)/3 = 2/3。\n\n- ③ B:0 − 2/3 = −2/3,低于本组平均。\n\n- ④ A/C:1 − 2/3 = +1/3,各高于平均。\n\n这四步在同一个态里连续展开,每一步都留在轨迹里;不是先把所有结果放出来再高亮。B 不是被忽略了:它仍在组内,提供了一个向下的信号。\n\n右侧“中心化权重示意”的条形只表示标量权重:B 为负,A/C 为正。它不是高维梯度,不表示梯度方向或范数。\n\n这个奖励有没有告诉模型某一个词应该换成什么?没有。它给的是整段候选的评分信号;这与监督示例提供目标 token 的方式不同。\n\n注意:本页不把 r − mean 叫完整 GRPO。它只是组内比较的中心化示意;完整算法还有标准化、概率比、剪裁、KL/约束和零方差处理。\n\n## b2 · 回答与比较\n\n进入 b2 才回答:没有,它评价的是整条回答。奖励是整份回答级;它不自动指出哪个词该换成什么。\n\n左侧是筛选后模仿:B 不进入模仿集合,A/C 进入。右侧是组内比较:B 的 0 低于平均 2/3,仍在组内,作为低于平均的信号。两条路都围绕同一个 B,不另造一个抽象总表。\n\n两条路都共同依赖检查质量。底部因此写:检查整份回答;不自动证明其中每一步。没有检查的推导文字,也可能随整条回答进入学习。\n\n最后留一个跨页问题:如果检查不再给 B 低分,这两条路径还看得见它的问题吗?本页不回答,留到下一页。\n\n## 为什么 r − mean 不是完整 GRPO\n\nr − mean 只做组内中心化:把每条回答的奖励减去本组平均。它说明“高于平均/低于平均”的相对方向,不等于完整 GRPO。\n\n完整 GRPO 还会涉及标准化、概率比、剪裁、KL/约束和零方差处理等设计。本页不展开推导,只把机制边界说清;详细材料在 [R4:筛选模仿与 GRPO 的完整目标及边界](handbook.html#R4)。\n\n零方差是一个具体边界:如果一组回答的奖励都相同,减去平均后全部为 0,组内比较就没有可用的相对信号。本页不把这种情况画成“没有学习”,只说它需要另外处理;完整处理在 [R4:筛选模仿与 GRPO 的完整目标及边界](handbook.html#R4)。\n\n## 只查执行时,未查推导也会被模仿\n\n检查器在这里只判整份回答是否通过。它不逐个位置批改,也不自动证明回答中的每一步推导。\n\n所以,只检查代码执行时,回答里附带的一段推导没有被检查,它也会跟着进入模仿。通过者可以当训练材料,不等于回答中的每一句都已经核实。\n\n这也是 b2 底部“检查整份回答;不自动证明其中每一步”的含义。两条训练去向都建立在这个检查质量上。\n\n\n\n## R4 · 完整阅读:从检查到参数更新\n\n把检查结果发回当前上下文,改变的是本次后续读取的材料;参数可以保持不变。筛选后模仿把通过的“问题+回答”组成训练集,再更新参数。相对奖励学习则用同一问题下回答的相对表现,改变生成这些回答的概率。三者可以使用同一检查器,但它们不是同一操作。\n\n### 筛选后模仿:目标来自被保留的回答\n\n设 D⁺ 是筛选后保留的问题 x 与回答 y。一个标准的序列负对数似然目标可写成:\n\n```text\nL_SFT(θ) = − (1 / |D⁺|) Σ_(x,y)∈D⁺ Σ_t log πθ(y_t | x, y_\n\n### 同一任务中,四种作用可以配合\n\n仍以修分页程序为例:给出一个带中间步骤的示例,改变的是本次输入;生成循环起点等工作状态,使后续输出有材料可用,通常不改参数。外部程序再组织多个候选、运行检查和选择,改变的是求解流程,其中的模型参数也可以不变。\n\n把检查结果写进下一次调用,改变的是下一次的上下文;筛选合格示例用于监督微调,或把奖励用于参数更新,才是在训练中改变未来的生成倾向。o1/R1 这类经过专门后训练的推理模型,不是只换了一句提示,也不等于一个外部搜索脚本。训练会影响它在使用时怎样利用计算,但普通模型也可以有推理能力。\n\n最后,运行代码、读取日志或查询环境,会带来当前文字中原本没有的观察。若缺的是线上当前配置,多展开一段推导不能替代这条事实。这四种作用可以组合:中间计算、外部搜索验证、推理后训练、工具观测;它们不是互斥类别,也不是所有系统都必须按顺序走完的历史阶梯。\n\n## 练习\n\n- b0 中 B=0 后去了哪里?A/C 的回答怎样变成训练样本?\n\n- 为什么说目标来自被选回答自身,而不是检查器逐词给答案?\n\n- 写出 b1 的四步算术,并说明 B 为什么是 −2/3、A/C 为什么是 +1/3。\n\n- “中心化权重示意”的条形能读成高维梯度吗?为什么?\n\n- 如果检查不再给 B 低分,两条路径分别还看得见问题吗?这页为什么留到下一页?\n\n- 为什么 r − mean 不是完整 GRPO?\n\n练习核对(先自己做)\n\n1. B 的整份回答不进入模仿样本;A/C 进入“问题+通过回答”的样本。模型读问题和回答已有前缀,预测下一个词;目标取自回答自身。\n\n2. 检查器只判整份回答是否通过,不逐个位置给标准答案;所以目标来自被选回答实际写出的下一个词,而不是检查器逐词写的答案。\n\n3. ① 1/0/1;② (1+0+1)/3=2/3;③ 0−2/3=−2/3;④ 1−2/3=+1/3。B 的原始奖励 0 低于平均 2/3;A/C 的 1 高于平均。\n\n4. 不能。条形是中心化后的标量权重,只表示正负和相对大小;不是高维梯度,不表示方向或范数。\n\n5. 本页不回答。这个问题是跨页悬问;本页只建立两条路都依赖检查质量这一前提,不提前替下一页下结论。\n\n6. r − mean 只做组内中心化;完整 GRPO 还涉及标准化、概率比、剪裁、KL/约束和零方差处理等。\n\n## 证据边界\n\n### 这页能说明\n\n- 同一个低分 B 可以走两条训练去向:筛选后不进入模仿样本,或留在组内作为低于平均的信号。\n\n- b1 的四步算术:1/0/1 → 平均 2/3 → B −2/3 → A/C +1/3;条形是标量中心化权重。\n\n- 奖励是整份回答级;不自动提供逐词替换目标。\n\n- 两条路都依赖检查质量;只查执行时,未检查的推导也可能随整份回答进入模仿。\n\n- r − mean 不是完整 GRPO;完整标准化、概率比、剪裁、KL/约束和零方差处理在 [R4:筛选模仿与 GRPO 的完整目标及边界](handbook.html#R4)。\n\n### 这页尚未建立\n\n- 没有实现或验证完整 GRPO/强化学习算法。\n\n- 没有给出真实分词边界或逐 token 奖励;b0 的片段只示意一个位置。\n\n- 没有把中心化标量条当成高维梯度。\n\n- 没有回答跨页问题:检查不再给 B 低分时两条路是否还看得见问题。\n\n## 来源\n\n[DeepSeekMath 初版 §4.1:GRPO 原始目标](https://arxiv.org/html/2402.03300v1#S4.SS1) · [LAB 03:同一检查信号的三种去向](labs.html#LAB03)(机制实验,不进行模型训练)\n\n\n\n[逐页目录](#page-index) · [返回 Q25 课堂](index.html#/Q25/b0) · 实验 [LAB03](labs.html#LAB03)\n\n# 删一项检查,B一定会混过去吗?\n\n这一页把同一个低分 B 放进三次条件变化里:b0 固定三项检查的基线,奖励 1 / 0 / 1,均值 2/3,三条去向一次读清;b1 只划掉空输入,先问 B 现在得几分;b2 才揭“不会”,因为四项仍重复 D;b3 只剩五项,三份都得 1,先问三个中心化格各填什么;b4 才逐个相减填 0;b5 把“筛选后模仿”和“本组中心化项”两个后果分开,并标出底注。\n\n## 这页要判断什么\n\n检查变少,不等于某一个回答一定混过去;也不等于后果只有一个方向。要判断,只能沿实际流程把每一项重新算一遍:哪些检查还在、这份回答在剩下的检查上还过不过、奖励是多少、均值是多少、中心化之后每一项落在哪里。\n\n本页只做两个可复算的小算例,不实现、也不验证完整强化学习算法。奖励是整份回答级的,中心化项只是标量;它不提供逐 token 的标准答案,也不等于高维梯度。\n\n本页也不继承前面“先到先交”的课堂设定。A 和 C 同为 1 分时,最后交谁仍要另外的约定;同分不能被读成“必然交某一个”。\n\n## b0 · 三项检查的基线\n\n基线有三项检查:五项 `[A,B,C,D,E]`、四项 `[A,B,C,D]`、空输入 `[]`。A、C 三项都通过,得 1;B 在四项末尾重复 D,又在空输入报错,得 0。这一组是 1 / 0 / 1,均值 (1+0+1)/3 = 2/3。\n\n同一个信号有三条去向,必须分开读:\n\n- **本次选择**:排除 B。A 和 C 同为 1 分,最后交谁还要约定规则。\n\n- **筛选后模仿**:只留 A、C;B 不进入模仿集合。\n\n- **组内比较**:以 2/3 为中心,B 是 0 − 2/3 = −2/3,A、C 各是 1 − 2/3 = +1/3。\n\n三条去向都对检查质量有依赖。检查器只判整份回答是否通过,不逐个位置给答案;通过者可以当训练材料,不等于回答中的每一句都已经核实。\n\n## b1 · 只删空输入:先预测\n\n空输入这一项检查被划掉,五项与四项仍然有效。四项里那处重复 D 的证据保留在画面上:同一份 B,末尾又把最后一项 D 补了一次。\n\n当前奖励、均值与三条去向都留空,只问一句:B 现在得几分?\n\n## b2 · 只删空输入:复算\n\n答案是“不会”。空输入被删掉之后,四项仍然重复 D,所以 B 还是 0;A、C 仍是 1。评分仍是 1 / 0 / 1,均值仍是 2/3,三条去向与基线完全相同:选择排除 B;筛选只留 A、C;组内比较仍是 +1/3、−2/3、+1/3。\n\n这就是要留下具体反例、而不只写一句“检查严格一点”的原因。B 有两个独立问题:一个在空输入,一个在四项末尾的重复 D。删掉一个检测,另一个仍然能把它分出来。\n\n本态的连续复现只服务同一条因果:分数、均值、三格中心化、三条去向依次出现,已经算出的结果留在画面上,不要求额外点击,也不新增提问。\n\n## b3 · 只剩五项:先预测\n\n现在只剩最初的五项示例。三份回答都通过,都得 1;这一组均值是 1。三项减的是同一个均值 1。\n\n三个中心化格留空,只问:各自减平均之后,三个格子分别填什么?\n\n请先依据给定奖励与组均值,自己计算三个中心化信号,再核对结果。\n\n## b4 · 只剩五项:复算\n\n逐个相减:A 是 1 − 1 = 0,B 是 1 − 1 = 0,C 是 1 − 1 = 0。三项的中心化信号都为 0。\n\nB 的问题没有变,只是这份检查不再看见它。对本次选择来说,三份同分,靠这个信号分不开,交谁要看另外的规则。对筛选后模仿来说,B 也被判为通过,会进入样本。\n\n这里的连续相减只做一件事:把“减同一个均值”逐项算完。每一步出现后都保留,不是先把 0 / 0 / 0 放出来再补高亮。\n\n## b5 · 两种后果分开说\n\n最容易说错的一句是:检查弱了,所以所有训练都会推高 B。这句话把两件事合成了一件。\n\n- **筛选后模仿**:B 被判为通过,整份回答进入样本;漏掉的 D 重复也会一起被模仿。这一条确实把 B 也当作目标。\n\n- **本组中心化项**:三项与均值 1 相减都是 0。这一项既不推高 B,也不压低 B;它不提供相对方向。\n\n底注因此写成:本组项为 0 ≠ 整个训练更新为 0。完整训练还可能有其他组、其他目标和约束,不能从这一项推出整次更新的方向,也不能说所有训练都会推高 B。\n\n回指三种检查:检查漏掉的区别会进入选择与训练,但具体后果要沿着实际流程算出来,不能只讲口号。\n\n本页讲完后接下一问:课堂小算例把机制拆开了。真实模型只用结果反馈做训练,能观察到怎样的变化?\n\n## N3 对照:三种条件的奖励、均值与中心化\n\n下面把三种条件放在一起复盘。这是阅读层的对照材料;投影按态逐步出现,初态不铺这张总表。\n\n- **完整:五项+四项+空输入。**奖励 A / B / C = 1 / 0 / 1;均值 (1+0+1)/3 = 2/3;组内中心化 +1/3 / −2/3 / +1/3。去向:选择排除 B(A、C 同分,交谁待规则);筛选只留 A、C;组内比较给 B 负条、A/C 正条。\n\n- **只删空输入。**奖励仍是 1 / 0 / 1;均值仍是 2/3;中心化仍是 +1/3 / −2/3 / +1/3;三条去向与完整条件完全相同。原因是四项里的重复 D 仍然让 B 不通过。\n\n- **只剩五项。**奖励 1 / 1 / 1;均值 1;三项中心化都是 0。去向:选择三份同分、需另定规则;筛选把 B 也纳入;组内比较三项都是 0,这一项不提供相对方向。\n\n三种去向不是同一个后果。选择只决定这次交谁;筛选后模仿决定谁进入样本;组内比较只决定这一组里每一项的相对权重。把它们说成一句“检查弱了会怎样”,会同时丢掉三个环节的差别。\n\n“筛选把 B 也纳入”和“本组中心化项为 0”是两条不同的结论:前者说明 B 会被模仿,后者说明本组这一项不再提供相对方向。两者都不能外推成“所有训练都会推高 B”,也不能外推成“整次更新为 0”。\n\n## 练习\n\n- 写出完整条件的三项奖励、均值与三个中心化值。\n\n- 只删空输入之后,B 为什么还是 0?画面里哪一处证据支持这一点?\n\n- 只剩五项时,三项奖励、均值与中心化分别是多少?\n\n- “三份同分”对本次选择意味着什么?还缺哪一条规则?\n\n- 为什么说“筛选把 B 纳入”和“本组中心化项为 0”是两个后果?\n\n- 底注“本组项为 0 ≠ 整个训练更新为 0”在排除哪一种误读?\n\n练习核对(先自己做)\n\n1. 奖励 1 / 0 / 1;均值 (1+0+1)/3 = 2/3;中心化 +1/3 / −2/3 / +1/3。\n\n2. 因为四项仍然重复 D,B 在这一项检查上不通过。画面保留的证据是四项那格标注的“仍重复 D”。删掉的只是空输入这一项。\n\n3. 奖励 1 / 1 / 1;均值 1;三项中心化都是 0。\n\n4. 意味着这个信号分不开三份回答,交谁不能由它决定;还需要另外的约定或规则。同分不能被读成“必然交 A”。\n\n5. 前者说的是谁进入模仿样本——B 会被模仿;后者说的是本组这一项的相对权重——它不推高也不压低。两条结论的作用对象不同。\n\n6. 排除“本组这一项为 0,所以整次训练更新为 0”的误读。其他组、其他目标与约束仍可能贡献。\n\n## 证据边界\n\n### 这页能说明\n\n- 完整条件与只删空输入条件都是奖励 1 / 0 / 1、均值 2/3、中心化 +1/3 / −2/3 / +1/3。\n\n- 只剩五项时是奖励 1 / 1 / 1、均值 1、中心化 0 / 0 / 0。\n\n- B 有两个独立问题;删掉一个检测,另一个仍能把它分出来。\n\n- 筛选后模仿会把被判为通过的 B 也纳入;本组中心化项为 0 时不提供相对方向。\n\n- 三种去向是三种不同用法,不能合成一句后果。\n\n### 这页尚未建立\n\n- 没有实现或验证完整的强化学习算法;这里只是机制示意与可复算小算例。\n\n- 没有给出逐 token 的标准答案或真实分词边界。\n\n- 没有说所有训练都会推高 B,也没有说整次更新为 0;其他组、目标与约束仍可能贡献。\n\n- 没有回答“真实模型只用结果反馈训练会观察到什么”;那是下一页的问题。\n\n\n\n[逐页目录](#page-index) · [返回 Q26 课堂](index.html#/Q26/p0) · 实验 [LAB03](labs.html#LAB03)\n\n# 不逐步示范,能学会更好的求解吗?\n\n已经有中间步骤,接下来谁来教模型怎么使用它?先保留一个选择:收集专家步骤,还是让最终结果提供反馈。随后读 R1-Zero 的真实训练证据,区分值得追问的积极信号与尚未证明的因果关系,最后提出一项能够改变自己判断的实验。\n\n\n\n## 站在2025年,已经知道什么?\n\n2021年的 scratchpad 工作把从答案反馈学习中间计算列为探索方向。到2025年1月,研究者已经知道2024年9月 o1 报告中的训练与测试时计算改善信号,不能再假装这些结果不存在。与此同时,公开报告没有给出足以复现其全部训练细节与绝对成本的信息。R1-Zero 的研究问题因此更具体:在已预训练的开放基座上,结果反馈能否产生稳定的求解改善?不是从零证明“模型也能推理”。\n\no1 的详细双计算图在下一页展开;本页选择先讲 R1-Zero 是机制组织顺序,而非历史先后顺序。\n\n\n\n## 从“能写步骤”到“谁来教它安排步骤”\n\n前面已经看到,中间内容能进入后续计算,训练反馈又能改变以后的生成倾向。新的问题是:如果没有人逐题示范完整的求解过程,只能检查最后答案,模型还能学到更有用的中间计算吗?这使“步骤有用”变成了一个新的研究方向,而不只是提示技巧。\n\n2021 年 *Show Your Work* 的 §7 就将从答案反馈中学习使用 scratchpad 列为未来方向;那篇论文主要展示的是有中间步骤监督的实验,不能把后来出现的结果算作它当时已经完成的工作。这里把 2021 的问题与 2025 的研究并读,是为了辨认一个问题怎样获得新证据,不是认定作者之间存在唯一、必然的继承路线。\n\n**先作选择:**你有一个已预训练的模型,能够核对最终答案,但收集专家步骤要额外投入。你会先收集步骤示范,还是先试结果反馈?两种选择都可能合理。请写下一个理由,再写下一个会让你改选的观察;接下来才看研究结果。\n\n\n\n## 先确认读的是什么证据\n\n官方来源是 DeepSeek-R1 论文 v1:[HTML 全文](https://arxiv.org/html/2501.12948v1)、[PDF](https://arxiv.org/pdf/2501.12948v1);两图原始地址为 [Fig.2](https://arxiv.org/html/2501.12948v1/figures/plot_aime_with_maj.png) 与 [Fig.3](https://arxiv.org/html/2501.12948v1/figures/plot_length.png)。\n\n投影层使用 `fig2-pass1-selected.svg`:只保留 Fig.2 的蓝色 pass@1 主曲线,保留原绘图区、刻度位置、坐标轴、选择性呈现说明与图源。曲线是从官方原图提取的蓝色像素轮廓,不是凭空拟合的折线,也不是声称取得了底层原始实验数据;没有重新拟造点值、插值或平滑。完整 Fig.2 与 Fig.3 原图保留在本页下方。\n\n\n\n## R1-Zero:已学过的基座,接受什么反馈?\n\n起点是已经预训练好的 DeepSeek-V3-Base,不是一个什么都没学过的随机模型。R1-Zero 没有先做冷启动监督微调,而是直接在这个基座上用结果奖励做强化学习;数学任务检查最终答案,还包含格式奖励。\n\n“Zero”指的是省略初始冷启动 SFT,不是从随机参数起步。答案检查和格式奖励本身就是训练信号;没有冷启动 SFT 也不等于没有任何监督信号。\n\nFig.2 的横轴是训练步数,不是这道题写了多少字;纵轴是 AIME 评估准确率。随着训练推进,准确率总体提高,中间有波动。投影层只读这个趋势,不从图上猜精确数字,也不把其他预算下的曲线拿来做同成本比较。\n\n主屏只显示 Fig.2 的蓝色 pass@1 趋势。原图还包含红色 cons@16 曲线与两条 o1 参考;这些不进入主屏,阅读层保留完整原图。选择性呈现本身要说清楚:它不是同一推理预算下的全曲线比较。\n\n\n\n## 准确率与长度一起变化,该怎样读?\n\nFig.2 缩小后仍保留在画面上;Fig.3 出现。Fig.3 的横轴同样是训练步数,纵轴是训练集平均回答 token 数。两条趋势都随训练步数变化:准确率总体上升,训练集平均回答长度也上升,过程中都有波动。\n\n观察到这里,只把问题留下:两条趋势一起变化,就能说因为写长了所以更准确吗?\n\n读图时也不要混淆:两张图的横轴都是训练步数;Fig.2 的横轴不是本题字数。两图并读不等于两图已经构成因果实验。\n\n\n\n## 两张图回答了什么,没有回答什么?\n\n不能只凭这两图说“变长造成了准确率提高”。\n\n左边是评估集的准确率,右边是训练集的平均回答长度;它们不是逐道题配成对的因果实验。训练同时改变了参数和求解方式,长度只是跟着变化的一个量。两条曲线都随训练步数上升,只能说明它们在同一个训练过程中一起变化,不能单独把长度指定为原因。\n\n从这里可以带走的是:结果反馈能改变模型以后的生成行为。至于其中哪些中间步骤真正有帮助,还要做更有针对性的对照。\n\n\n\n## Table 3:不仅看长度,还看可核对的求解动作\n\nDeepSeek-R1 v1(2025-01-22)§2.2.4 的 Table 3 是作者挑出的一个 **R1-Zero 中间训练检查点**回答片段,不是最终 R1 的完整成功记录。下面是忠实释义;省略沿用原表,未补出结局。\n\n- 题目给定 a > 1,求 √(a − √(a + x)) = x 的实数解之和。\n\n- 回答先平方,得到 a − √(a + x) = x²,再平方并整理为 x⁴ − 2ax² − x + (a² − a) = 0。原表随后有省略。\n\n- 回答暂停并重新检查,从原来的根号方程出发,再得到 √(a + x) = a − x²,随后考虑再次平方;原表再次省略。\n\n可直接观察的是**回到原式、重走变形**,不只是文字变长。节选没有展示最后求出正确解,也没有标明已定位并修复哪个错误。可见语言不能直接当成内部因果机制;单个作者选例也不能说明行为频率。\n\n检验其价值,可以对固定未见题集和实际计算预算,在多个训练检查点、多个随机样本上记录:出现回查的比例、回查是否改动错误步骤、最终正确率、失败类型。再比较能够区分有效检查与无效重复的干预条件。若只是更频繁地说“再检查”却不改变失败结果,就不能据此宣布能力提升。这个验证方案是课堂提出的后续研究,不是原表已经给出的实验。\n\n[原文 §2.2.4 / Table 3](https://arxiv.org/html/2501.12948v1#S2.SS2.SSS4)。这里保留题目与变形来核对行为,不要求先学会解这道代数题。\n\n\n\n## 为什么这仍然是一个值得继续的信号?\n\n不逐题提供完整步骤示范,结果反馈仍可能让基座中已有的能力组织成更好的求解。R1-Zero 提供了这一方向的积极证据:在它的基座、任务和奖励设置下,训练中的准确率和回答行为发生变化。它使“能否从可检查结果中学习安排求解”成为值得继续投入的研究问题。\n\n这个正向认识与因果边界并不冲突。我们可以决定继续研究,而不声称已经知道每一段中间内容为何有效。既有基座贡献了什么、奖励覆盖贡献了什么、训练任务换掉后能否保持,都还是需要区分的问题。\n\n\n\n### 怎样让下一次试验有区分度?\n\n例如,固定基座、训练题集合、训练预算与评估方式,只改变奖励覆盖:一组仅看格式,另一组同时检查答案。用没有用于训练的题目和独立检查器比较正确率、失败类型,以及实际计算用量。这是本课提出的实验设计,不是两张图已经做出的消融。若格式分提高而未见题正确率没有改善,就应收回“求解能力改善”的判断;若改善只在熟悉题型成立,就应缩小适用范围。\n\n请再看自己最初选的路线:你是否愿意多给结果反馈一笔试验预算?说清楚证据怎样改变理由,比猜中研究者最后采用的路线更重要。下一页将把“训练模型学会计算”与“给本次求解更多计算”放在一起比较。\n\n\n\n## R5 · 统计口径与出处边界\n\n- **pass@1 的估计方式:**Fig.2 的蓝线是 R1-Zero 的 pass@1;图注说明每题抽样 16 次用于估计平均准确率。不能把蓝线叫成 pass@16;pass@1 与 16 次多数投票是不同指标。\n\n- **cons@16 是另一条预算:**Fig.2 的红线是 cons@16;它与蓝线 pass@1 的推理预算不同,不能拿来当同成本比较。绿色、紫色是 o1 的 pass@1 / cons@64 参考,也不与本页蓝线混写。\n\n- **表 2 的 cons@64:**论文表 2 的投票列是 cons@64,不是这张图的红线;不能把表 2 的预算与 Fig.2 的红线混为一谈。\n\n- **阴影定义未知:**Fig.3 的浅色区域在本次相关正文和图注中没有明确统计定义;不能标成置信区间,也不能猜它的含义。深蓝轨迹的实际波动保留。\n\n- **Aha 出处:**论文 §2.2.4(Performance, Self-evolution Process and Aha Moment)对 R1-Zero 的自我演化与 “aha moment” 有叙述。本页只把它当作论文叙述,不把两图当成该叙述的因果证明。\n\n- **不是逐题因果实验:**两图分别是评估集准确率与训练集平均回答长度,跨训练步聚合;不是同一道题在“长回答/短回答”之间的配对比较。两跨训练步趋势不是逐题因果实验。\n\n- **没有底层数值:**本页没有取得论文底层数值表;主屏曲线是原图像素抽取,不应从图上读出论文未报告的精确效果数字。阴影含义未知时不猜置信区间。\n\n## 两张完整原图\n\n投影层只使用 Fig.2 的蓝色 pass@1 选择性曲线;下面保留两张官方完整原图,便于核对红线、o1 参考、图注与浅色区域。\n\n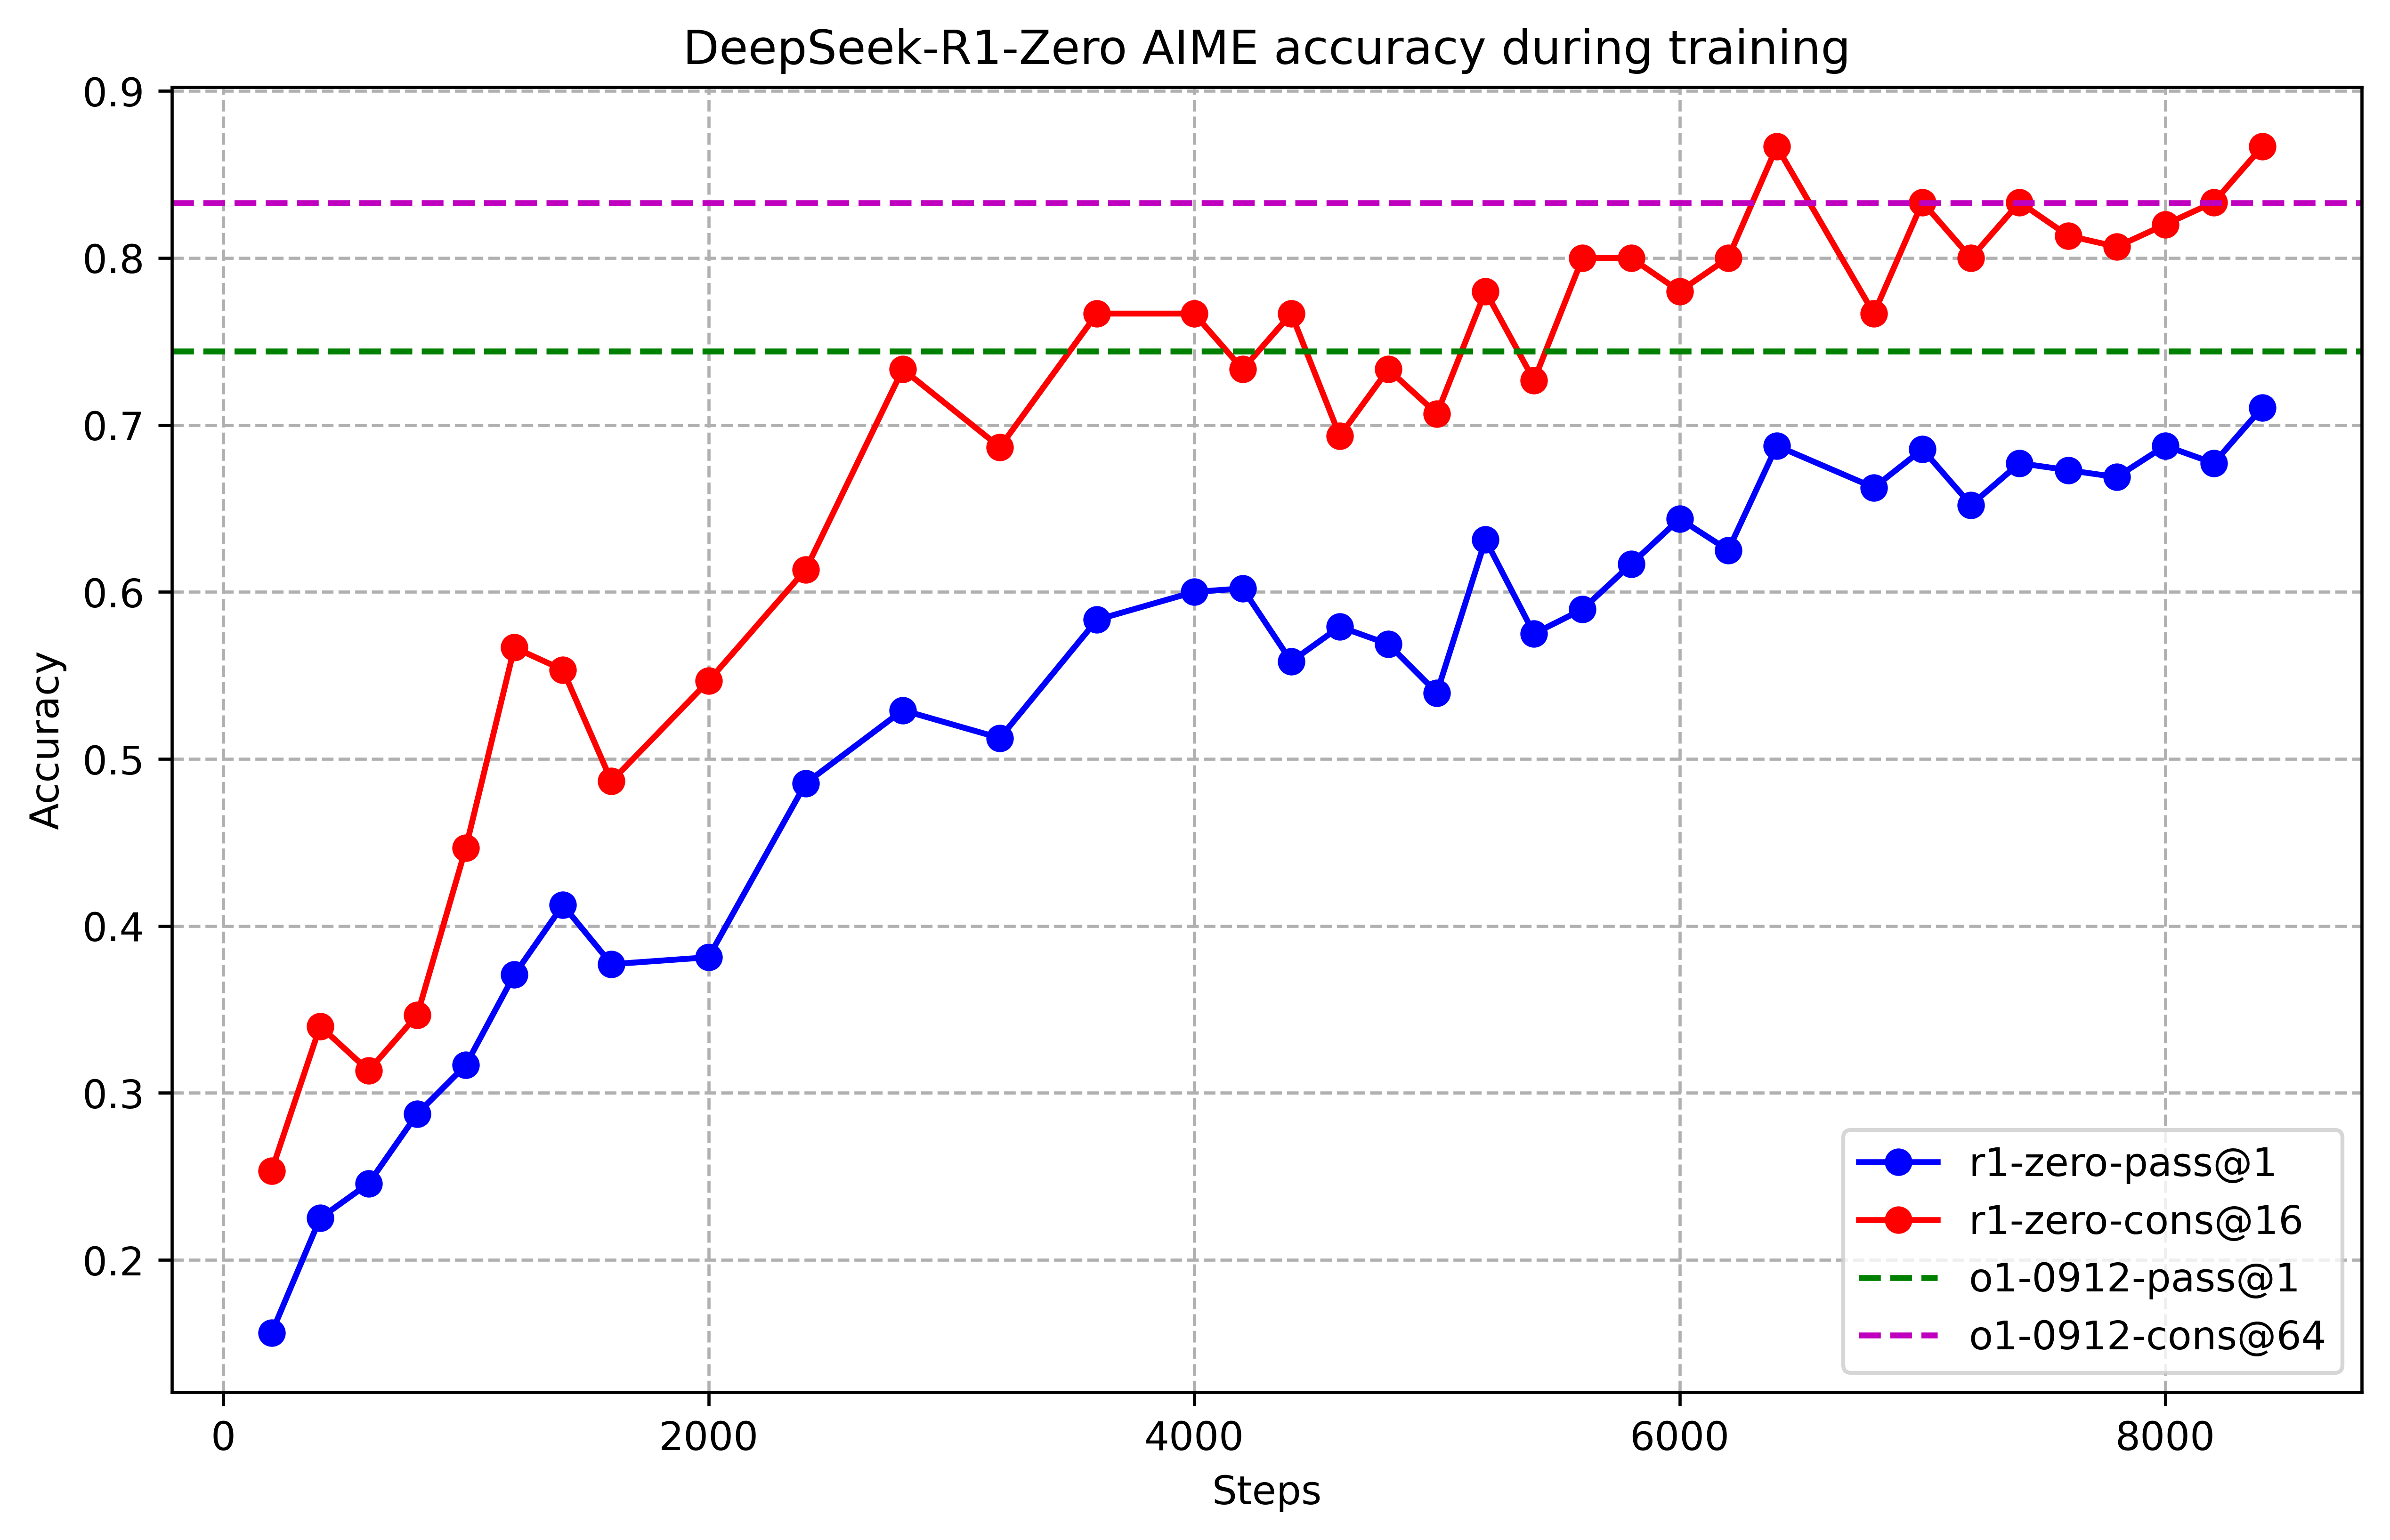\n\nFig.2 完整原图。蓝线为 R1-Zero pass@1;红线为 cons@16;绿/紫为 o1 的 pass@1 / cons@64 参考。主屏不显示这些参考线。来源:arXiv:2501.12948v1。\n\n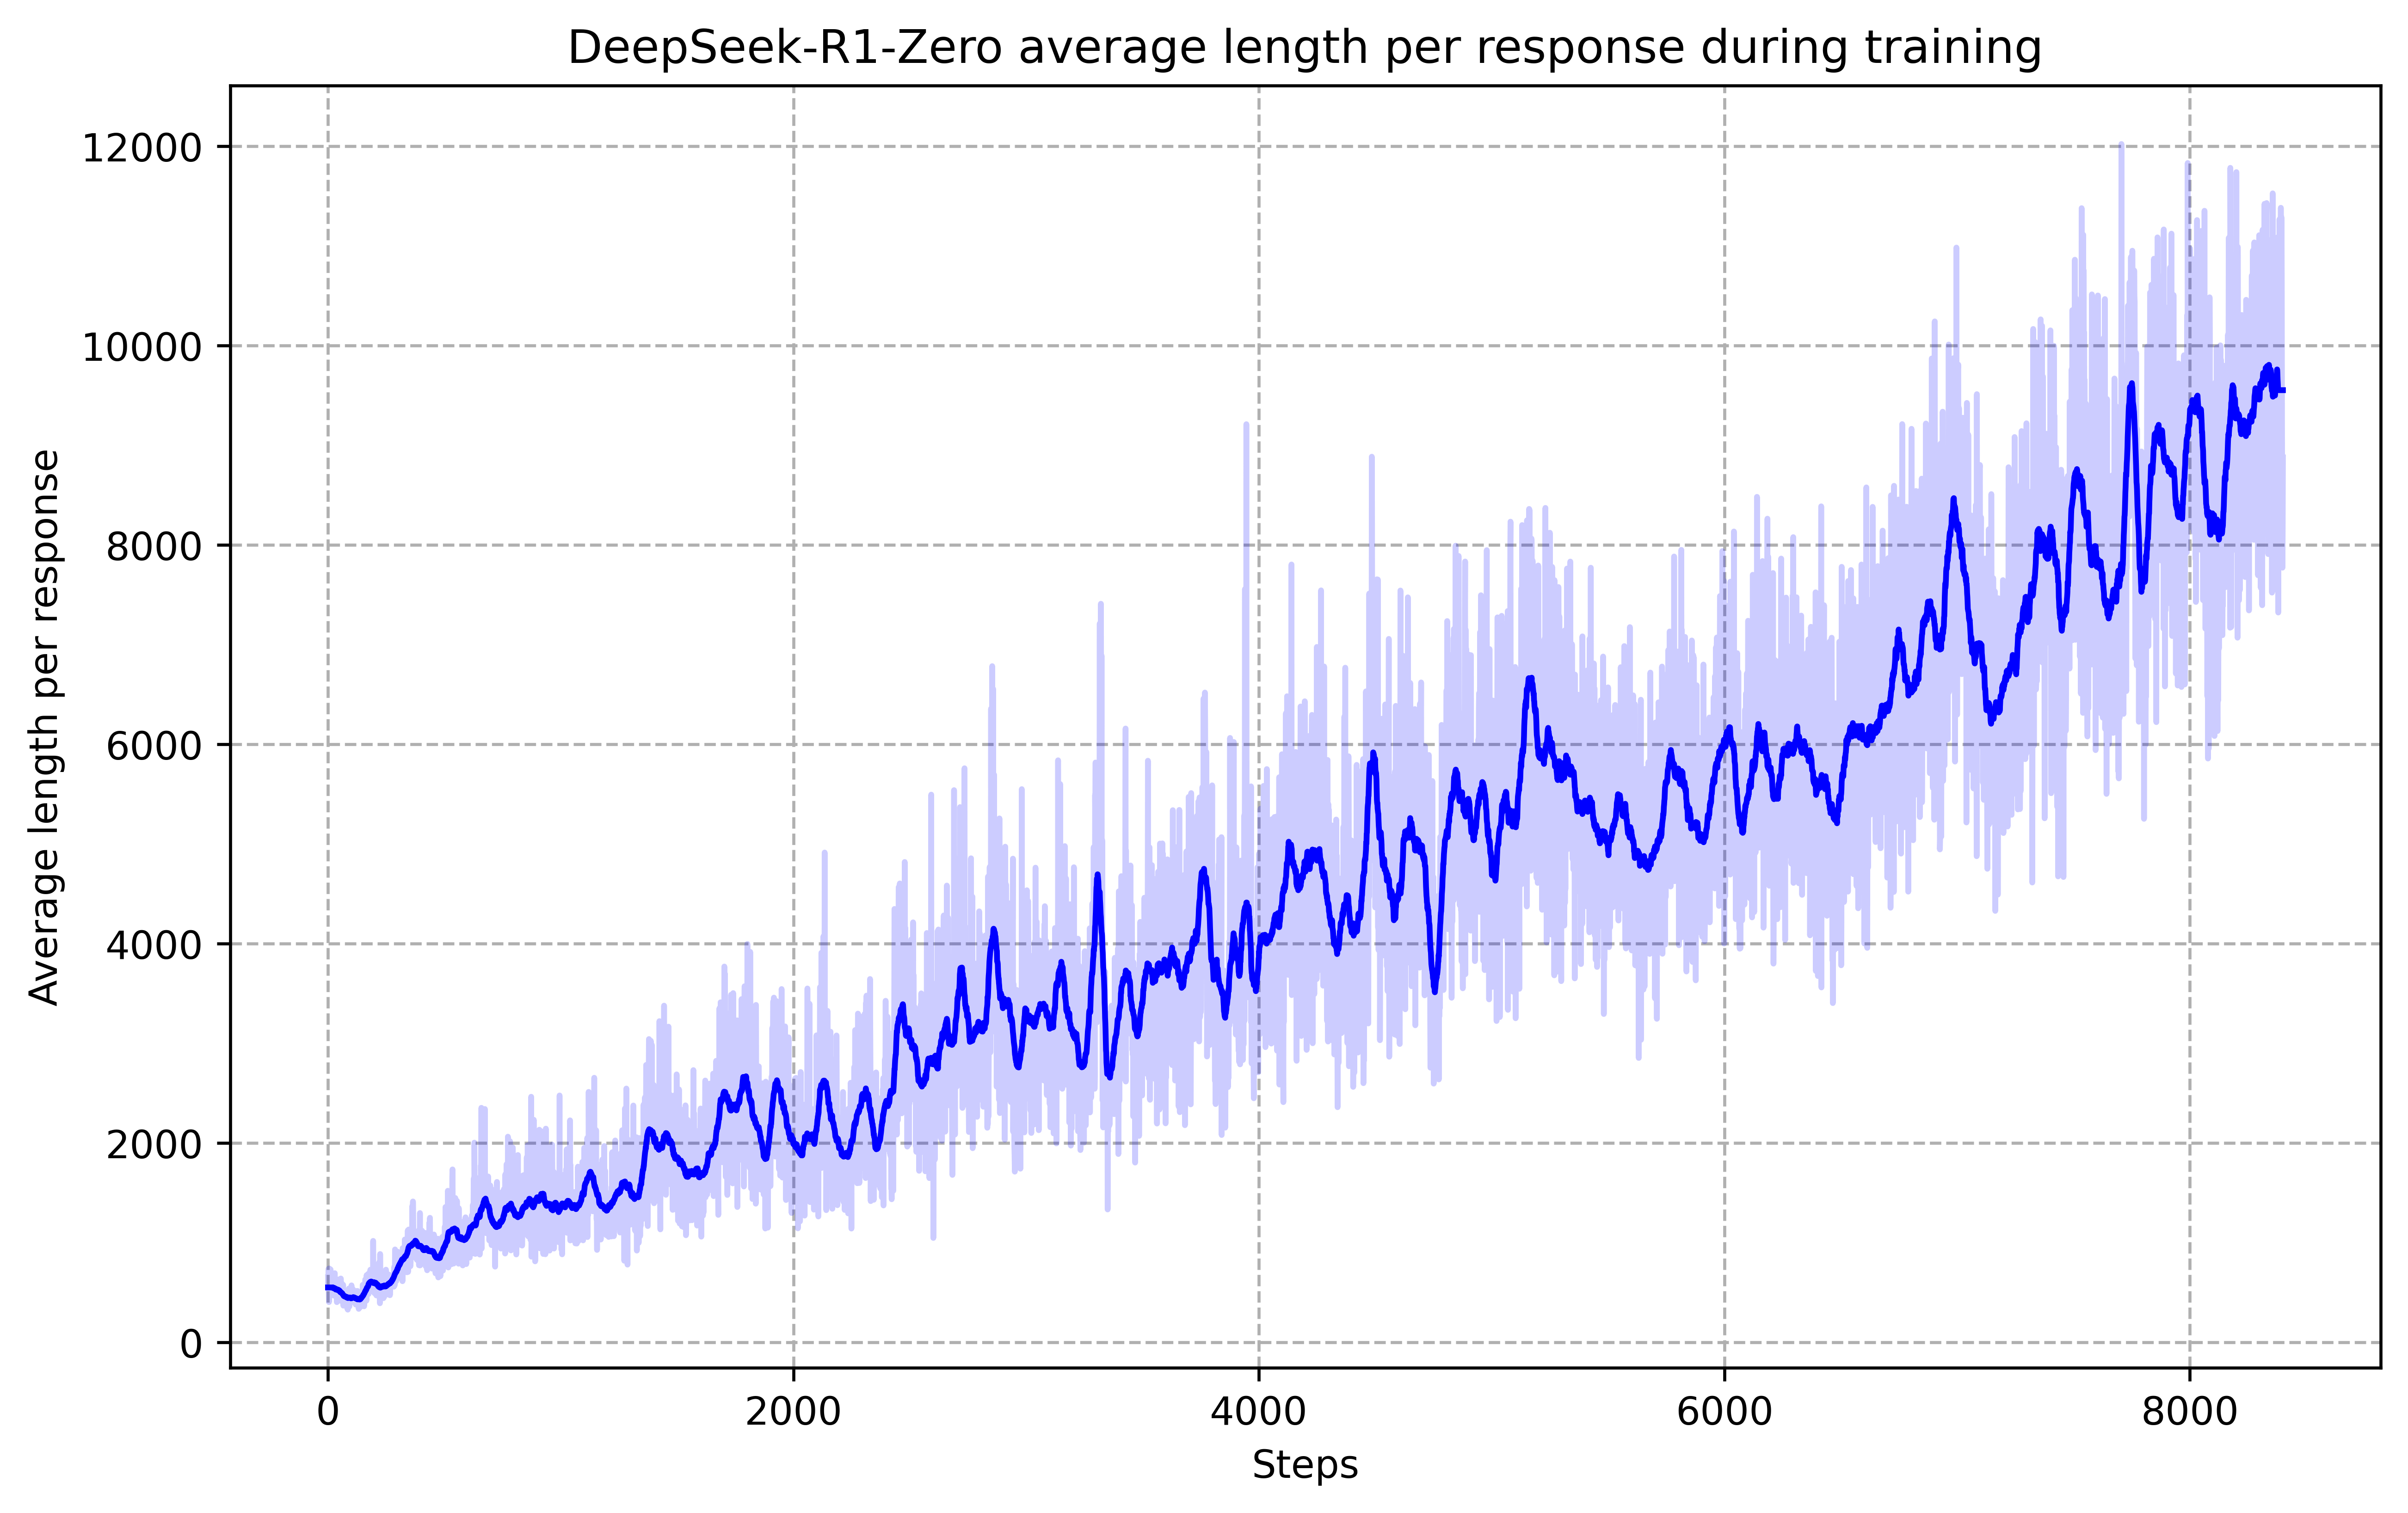\n\nFig.3 完整原图。纵轴为训练集平均回答长度(token);深蓝轨迹波动明显,浅色区域不按置信区间解读。来源:arXiv:2501.12948v1。\n\n## 练习\n\n- 主屏为什么只显示 Fig.2 的蓝线?蓝线代表什么?\n\n- 两条曲线都随训练步数上升,能不能直接说“写长导致更准”?还缺什么?\n\n- 为什么不能把蓝线叫成 pass@16?cons@16 与 o1 参考又为什么不能拿来做同成本比较?\n\n- Fig.3 的浅色区域可以标成置信区间吗?为什么?\n\n- “Zero”在这里指什么?它和“随机参数起步”有什么区别?\n\n- 回到开头的路线 A / B,哪项新证据改变了你的选择?设计一个会使自己改判的对照。\n\n练习核对(先自己做)\n\n1. 因为主屏做的是选择性教学呈现:只保留 R1-Zero 的蓝色 pass@1 趋势,避免把 cons@16 与 o1 参考混成同一预算比较。蓝线代表 pass@1 的估计趋势,不是底层原始数值。\n\n2. 不能。左边是评估集准确率,右边是训练集平均回答长度;两图是跨训练步的聚合趋势,不是逐题配对的因果实验。训练同时改变了参数和求解方式,长度只是跟着变化的一个量。还需要更有针对性的对照,才能判断哪些中间步骤真正有帮助。\n\n3. 本图的 pass@1 估计使用每题 16 份样本来估计平均准确率;pass@16 是另一种指标,不能混叫。cons@16 是另一条推理预算下的曲线;o1 的 pass@1 / cons@64 也是不同模型、不同预算的参考。它们不能与蓝线做同成本比较。\n\n4. 不能。浅色区域的统计定义在本次相关正文和图注中没有明确;不知道它代表什么,就不能标成置信区间,也不能猜。\n\n5. Zero 指不先做冷启动 SFT,直接在已预训练的 DeepSeek-V3-Base 上做结果奖励强化学习;不是从随机参数起步,也不是“什么都没学过”。\n\n6. 合理回答需要指出具体证据与改判条件,不必选同一路线。例如,结果反馈值得获得一笔试验预算,但若只提高格式分而未见题没有改善,就先检查奖励覆盖与任务分布。\n\n## 证据边界\n\n### 这页能说明\n\n- R1-Zero 从已预训练的 DeepSeek-V3-Base 出发,用结果奖励做强化学习,省略初始冷启动 SFT。\n\n- Fig.2 的蓝色 pass@1 趋势随训练步数总体上升,中间有波动;Fig.3 的训练集平均回答长度也随训练步数变化。\n\n- 主屏是选择性教学呈现,只取 blue pass@1;完整原图与 cons@16、o1 参考保留在阅读层。\n\n- 两图分别是评估集准确率与训练集平均长度,不是逐题配对因果实验;不能单凭两条趋势把长度指定为准确率提高的原因。\n\n- 结果反馈能改变模型以后的生成行为;哪些中间步骤真正有帮助,需要更有针对性的对照。\n\n### 这页尚未建立\n\n- 没有取得论文底层数值,也没有从图中反推论文未报告的精确效果数字。\n\n- 没有把 Fig.3 的浅色区域解释为置信区间;其统计定义未明确。\n\n- 没有把蓝线叫成 pass@16,也没有把 cons@16 或 o1 参考与蓝线混为同预算比较。\n\n- 没有做逐题配对实验,也没有证明“写长导致更准”。\n\n## 来源\n\n- [Show Your Work(2021)§7:从答案反馈学习 scratchpad 的开放方向](https://arxiv.org/html/2112.00114v1#S7)\n\n- [DeepSeek-R1 论文 v1(HTML)](https://arxiv.org/html/2501.12948v1);[PDF](https://arxiv.org/pdf/2501.12948v1)\n\n- [Fig.2 原图](https://arxiv.org/html/2501.12948v1/figures/plot_aime_with_maj.png);[Fig.3 原图](https://arxiv.org/html/2501.12948v1/figures/plot_length.png)\n\n\n\n[逐页目录](#page-index) · [返回 Q27 课堂](index.html#/Q27/b0) · 实验 [CLS02](labs.html#CLS02)\n\n# 把计算花在训练,还是花在这一次?\n\n一个模型已经预训练完成,困难题仍然不少。可以用更多反馈继续训练,也可以固定参数,让它在当前问题上多尝试、多检查。2024 年的 o1 报告为这两条路线提供了积极信号。我们的任务是据此决定先验证什么,而不是把“更多计算”当成无条件的答案。\n\n课堂先讲2025年的R1-Zero行为,再回看2024年的o1双计算图,是为了比较机制;Q26已交代o1前情,不把两页排列当成研究发生顺序。\n\n\n\n## 先安排一笔研究投入\n\n假设你只知道一个现成模型在困难题上的表现还不够好。路线一是在多道训练题上收集反馈、更新参数,让它以后更会求解;路线二是固定参数,在每道新题上增加生成、推理或检查的计算。两者都花计算,但改变的对象不同。\n\n请先选一次试验:你想先增加哪一类计算,想看到什么证据才继续投入?这不是只能永久二选一,也没有脱离条件的标准答案。有可靠反馈和足够训练资源时,继续训练可能值得;拿到现成模型却无法改参数时,本次预算对照往往更容易开始。\n\n\n\n## R8 · o1 为什么让双计算成为重要线索?\n\n\n\n### 2024 年报告提供的信号\n\n[OpenAI 于 2024 年 9 月 12 日发布的 Learning to reason with LLMs](https://openai.com/index/learning-to-reason-with-llms/),在 Evals 之前的正文与双计算图注中明确区分了两个方向:增加强化学习训练的计算,以及在测试时给求解更多思考时间;在报告的设置中,两者都伴随模型表现改善。下方保留官方原图,便于把这两个方向与原始证据逐一对照。\n\n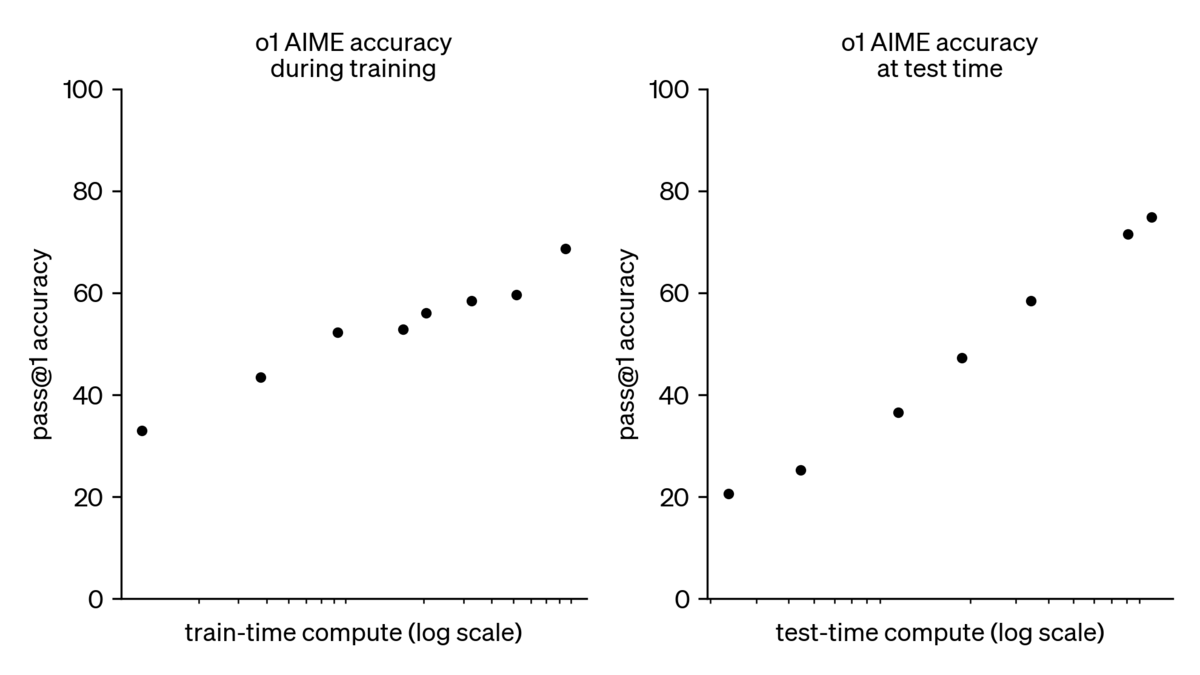\n\n原图来自 OpenAI(2024-09-12)。左:o1 AIME accuracy during training;右:o1 AIME accuracy at test time。这里呈现原图,不重绘或反推未公开的计算成本。\n\n**按轴读:**两图纵轴均为 AIME 的 pass@1 accuracy(0–100)。左横轴是 train-time compute,右横轴是 test-time compute,均标为 logscale,未显示数值刻度。可观察到两组散点的整体上升方向;缺少绝对计算量与成本刻度,不能从点间距离推出投入了多少 FLOPs、多少钱或通用 scaling 指数。这是同一研究报告对两种投入方向的展示,不是可直接计算两种投入兑换比例的实验。\n\n它给研究选择带来的启发是:除了把预训练做大,还可以研究模型怎样学会更有效地利用计算,以及使用时怎样分配计算。这与上一页 R1-Zero 的信号互补:前者明确提出训练和测试两个阶段的投入方向,后者提供一个从已预训练基座出发、利用结果反馈改变求解行为的具体研究实例。两项工作有不同模型、任务与预算,不能把图拼成同一条可定量比较的曲线。\n\n\n\n### 这份证据支持探索,不给出成本换算表\n\n报告中的双计算趋势不能推出“花同样一元钱,训练和推理总能互换”,也不能推出精确的 scaling 指数或经济回报。公开材料没有提供这里所需的绝对成本与全部可比条件。报告的其他评测还说明,除非另行注明,o1 使用最大测试时计算设置;读后面的成绩时必须保留这一条件。\n\n这是对 2024 年模型研究的历史阅读,不是今天产品表现的保证。对一个新的任务,是否值得增加预算,仍需要同条件比较。尤其不要把多写 token、提高最大长度、增加有效求解计算视为三个完全相同的量。\n\n\n\n## 固定参数与更多推理计算,为什么不矛盾?\n\n| 问题 | 这一次:推理计算 | 以后:训练计算 |\n| --- | --- | --- |\n| 改变什么 | 当前上下文、候选、检查和输出过程 | 参数,以及以后更可能生成什么 |\n| 什么保持不变 | 本次执行不更新模型参数 | 训练并不改写已发生的外部事实 |\n| 反馈怎样用 | 决定重试、保留候选或补一项检查 | 通过训练目标影响参数更新 |\n| 对应本课 | 候选与搜索、反例、预算分配 | 筛选模仿、相对奖励、R1-Zero |\n\n参数固定,并不要求一次输出只能使用固定总量的计算。每生成一个后续 token,模型都会对扩展后的上下文继续运算;额外候选与工具检查也会增加整个求解过程的计算。另一方面,训练会改变模型在新任务上怎样组织这些动作。合适的训练可能使本次预算更有用,本次预算也给学到的求解方式展开的机会;这是需要任务证据支持的关系,不是普遍换算定律。\n\n训练机制可继续读[Q24:筛选模仿与相对奖励](./reading.html?page=Q24&cue=b0),研究实例见[Q26:结果反馈与 R1-Zero](./reading.html?page=Q26&cue=p0),预算分配研究见[Q37:有限预算应投在哪里](./reading.html?page=Q37&cue=b0)。\n\n\n\n## 把报告变成自己能作的判断\n\n拿到一个新模型后,先不要同时更换提示、模型、题库和评判器。选一组有独立答案或测试的题,固定模型版本、题目和检查器,只改变本次求解预算。可以先比较较少与较多的预算,并同时记录正确率、失败类型、实际 token 或工具调用、耗时。这里描述的是待执行的实验方案,不是已经运行的性能结果。\n\n如果更多计算使未见题的错误减少,而实际成本仍在预算内,就有理由继续探查有效区间。如果输出变长但错误没有减少,先看瓶颈:好答案有没有生成?选择器有没有挑错?检查器是否遗漏错误?题目是不是缺少必须从外部取得的事实?这些诊断分别指向增加覆盖、改善选择、改善验证和补新观测。\n\n**改判条件:**在动手前写一句“若出现 X,我就不再增加这类预算,而先处理 Y”。这样,实验不会只收集支持原看法的结果。最大输出长度只是上限;如果模型没有使用新增空间,它也不等于实际投入了更多计算。\n\n\n\n## 两条路最终都要问:什么算作“好”?\n\n更多计算让我们可以把更复杂的求解交给模型,但搜索和训练都依赖评价:搜索用它决定留下谁,训练用它改变以后更常生成什么。如果评价标准偏离实际任务,系统可能更会拿高分,却没有完成我们要的事。\n\n回到 Q01 的分页母例:输入是 A、B、C、D、E 五条记录,每页最多两条,按顺序分页,最后一页也要保留。实际只返回 A、B 和 C、D 两页,第三页没有回来。E 仍然是第 5 条输入记录,空的是它应在的返回位置。一个“通过”如果没有检查这一处遗漏,就不能证明任务完成。\n\n课堂中金色的勾从“多做一个检查”移到缺 E 的位置,表示重新检查标准,不表示验收通过。这个承转把“双计算机会”接到下一页的问题:既然系统越来越能利用反馈,我们必须看清反馈究竟奖励了什么。\n\n\n\n## 给自己和 AI 的复核问题\n\n- 同一模型参数固定,为什么增加本次计算仍可能改变结果?请用本课的候选或中间状态说明。\n\n- o1 的历史报告与 R1-Zero 分别提供了什么信号?哪些条件使它们不能被直接合成一条成本曲线?\n\n- 如果好答案已经在候选里却没被选中,增加候选和改善选择器,你先试哪一个?写出一次区分实验。\n\n- 把最大输出长度调高之后结果没有变化,至少还应检查哪两项事实?\n\n- 为自己的第一次预算对照写一个会让你停止追加计算的结果。\n\n核对思路(先写自己的判断)\n\n参数固定不等于求解轨迹固定;新上下文、候选和检查会改变本次可用信息。o1 提供训练与测试两个方向的改善信号,R1-Zero 提供结果反馈下行为与能力变化的具体实例;它们不是同模型同任务同成本实验。若好答案已经存在,优先检验选择器,而不是默认继续扩大候选。长度上限提高后还要看实际用量、是否截断、缺少外部事实与评价覆盖。停止条件应把效果、成本和任务目标一起写清,不能只凭输出看起来更努力。\n\n## 原始来源\n\n- [OpenAI(2024-09-12):Learning to reason with LLMs,Evals 前正文与双计算图](https://openai.com/index/learning-to-reason-with-llms/)\n\n- [DeepSeek-R1 v1 §2.2:R1-Zero 的训练设置与研究结果](https://arxiv.org/html/2501.12948v1#S2.SS2)\n\n\n\n[逐页目录](#page-index) · [返回 Q28 课堂](index.html#/Q28/b0)\n\n# 这盏绿灯说明了什么?\n\n这一页不从“程序哪里写错了”开始,而从“这盏灯为什么亮”开始。b0 只给五条输入 A–E 和一盏 PASS 绿灯,问只看这个信号能不能交付;b1 才展开实际返回值、E 的固定空位和原标准,并让比较运算本身出现在屏幕上;b2 才展开验收函数,红框只圈住 return True。三态都保留同一盏 PASS,让“通过”与“是否满足原任务”分开看。\n\n## 这页要判断什么\n\n同一个“PASS”字样,可以来自不同的验收规则。只看见绿灯,不能直接推出任务已经按原标准完成;必须同时看见实际结果、原标准,以及亮灯函数到底比较了什么、又有没有使用比较结果。\n\n这一页的案例是教学构造,不是一次真实模型运行记录。它不推断任何模型或开发者的动机,也不把“测试无用”当作结论。它只把一个具体的验收漏洞摆出来:当函数不再比较输入结果、直接返回 True 时,PASS 仍然会亮,但它的意义已经变了。\n\n本页还要把两种不同的问题分开。只测五项就交卷,是检查覆盖不够;把“是否满足任务”的判断拿掉,是验收标准被绕过。前者可以靠增加有区分力的检查来补,后者不是再多跑同一个例子能解决的。\n\n## b0 · 只看绿灯\n\n投影只放两样东西:左侧是输入 A、B、C、D、E 五条记录,标注“每页最多 2 条、不漏不重”;右侧是唯一亮着的 PASS 绿灯。实际返回、原标准和验收函数都折叠,不显示内容。底部只问一句:只看这个绿灯,能交付了吗?\n\n只看 PASS 还不足以判断任务是否完成;需要继续查看实际返回、原任务标准以及产生 PASS 的函数。\n\n## b1 · 结果与原标准对不上\n\n教师进入后,先展开实际返回值:`actual = [[\"A\",\"B\"],[\"C\",\"D\"]]`。三页位置固定:第 1 页是 A、B,第 2 页是 C、D,第 3 页留一个空框,标明 E 未返回。E 仍然是第 5 条输入记录,不是空输入;空框只是未返回的第 3 页位置占位,不表示 actual 里有一个空数组。\n\n下面独立一行才是这次任务原本的验收条件:`actual == [[\"A\",\"B\"],[\"C\",\"D\"],[\"E\"]]`。比较运算本身必须可见,不能只画两个数组让学生自己猜。实际值与期望值逐项对应后,比较结果是 False(不相等)。但右侧的 PASS 仍然亮着,并用一条连线指向缺项 E 的位置。底部问:这两个结果不相等,为什么灯还亮着?\n\n本态不展开验收函数,也不猜程序内部哪里错。它只把“不相等”和“仍通过”同时放在同一屏,让冲突成为下一态的问题。实际值、原标准和比较结果在本态出现后保留,b2 不会把它们撤掉。\n\n## b2 · 把标准改成总是通过\n\n第三行才展开验收函数:`def accepts(actual): return True`。红框只圈住 `return True`,不是整段函数。函数体没有比较 actual 的值,也没有使用 b1 展示的比较结果;它直接返回 True。底部结论只写:这个 PASS 只证明函数返回了 True。\n\n灯还是那盏灯,但意义已经变了。让实现达到原标准,和把标准改得永远通过,不是一件事。前者要补上 E、让 actual 等于期望数组 `[[\"A\",\"B\"],[\"C\",\"D\"],[\"E\"]]`,使独立比较返回 True;后者只是让亮灯函数不再检查这件事。\n\n这里也要和前面的弱检查分开:只测五项,是检查覆盖不够;这里是把是否满足任务的判断拿掉了。课堂不说测试无用,也不从构造案例推断真实系统或开发者的动机。\n\n**末态后完整承转:**“标准没有被偷换,也做了本地检查,我们能把结论说到多大?回到补丁 A。”\n\n## 母例身份:A–E、size=2 与第三页\n\n这一页沿用 Q01 的母例身份,不另造一套对象。输入是 A、B、C、D、E 五条记录,分页参数 size=2,按原顺序分页,每页最多两条,最后一页可以不满。要求因此是三页:第 1 页 A、B,第 2 页 C、D,第 3 页 E。\n\n实际返回只有两页:第 1 页 A、B,第 2 页 C、D。第 3 页没有回来,所以 E 缺位。E 仍是第 5 条输入记录;空框只是未返回的第 3 页位置占位,不表示 actual 里有一个空数组。PASS 从 b0 到 b2 一直保留;实际值从 b1 才展开;验收函数只在 b2 出现。\n\n本页只把 Q01 当作视觉与对象身份参照,不修改 Q01,也不把 Q01 的旧结论搬到本页预测态。A–E 的 key、顺序和“每页最多两条”的条件保持不变。\n\n## 延伸比较:弱检查与标准变化\n\nN3 这一层要区分三种情况。第一种是“只测了很少的输入”:检查确实比较了实际值与期望值,但覆盖不够,所以通过只能说明这几个输入;第二种是“比较运算还在,但亮灯函数不使用它”:屏幕上可以出现 `actual == [[\"A\",\"B\"],[\"C\",\"D\"],[\"E\"]]`,可最终是否通过并不由这个比较决定;第三种是“把标准改成永远通过”:函数直接返回 True,原来的验收条件被绕开。\n\n| 情况 | 还比较实际值吗 | PASS 说明什么 |\n| --- | --- | --- |\n| 弱覆盖 | 比较,但只测很少输入 | 只说明这几个输入通过;不能推出所有输入 |\n| 比较结果不参与判断 | 可能仍显示比较 | 不能说明实际值满足原标准;要看函数是否真的使用比较结果 |\n| 标准改成永远通过 | 不比较,直接返回 True | 只证明函数返回了 True,不证明任务完成 |\n\n读这张表时不要把三种情况混成一句“测试没用”。弱覆盖要靠更有区分力的检查补;比较结果不参与判断,要检查函数有没有真正使用它;标准变化则要回到任务原本的验收条件。三者都要求我们保留实际值与原标准的对照,而不是只看最后的颜色。\n\n## N3:同一检查信号的三种去向\n\n| 层次 | 动作与变量 | 预测与核验 | 向自己的AI提问 | 可检查产出 |\n| --- | --- | --- | --- | --- |\n| 基础 | 三项检查/删空输入/仅五项;候选A/B/C | 先写奖励向量及减均值结果再算 | 只删空输入为什么B仍得0?是哪项检查挡住了它? | 1/0/1、1/0/1、1/1/1与相应中心化表 |\n| 进阶 | 加入B1,保持检查不变 | 预测哪些检查对B和B1区分不同 | 同分能直接推出选B吗?还缺什么选择规则? | 四候选奖励表+明确选择规则下的交付结果 |\n| 挑战 | 自己写最小检查集合 | 保住A/C并排除B/B1;先解释区分力再运行 | 你的测试是真的区分方案,还是重复已有证据?请给反例 | 测试集、输入输出和理由 |\n\n训练的筛选模仿与相对加权必须分开。弱检查让坏示例进入模仿集合;全组同分时此中心化项为零,不表示组内项推高B,更不等于完整RL目标全部零更新。真正GRPO标准化、概率比、剪裁和KL放R-4,不能拿中心化示意冒充实现。\n\n## R-6 · 真实记录与监控研究(指向)\n\n本页的 PASS、实际返回值和验收函数都是教学构造,不是线上日志、模型运行记录或监控数据。真实记录、线上监控与相关研究属于 R-6 的阅读材料;本页不生成、不伪造那些记录,也不从构造案例推断某个模型的动机或行为倾向。\n\n如果要把这一页的区分用到真实系统,至少需要三类可核对证据:实际输出与任务原标准的对照、验收函数或规则的源码、以及检查覆盖了哪些输入。没有这三样,单一 PASS 不足以支持“已交付”的结论。\n\n## 练习\n\n- 只看 PASS 绿灯,能确认 E 已经回来了吗?还需要看哪两样?\n\n- b1 里实际值是 `[[\"A\",\"B\"],[\"C\",\"D\"]]`,原标准要求三页。比较结果是什么?为什么 PASS 还亮?\n\n- b2 的红框为什么只圈 `return True`,而不是整段函数?\n\n- “只测五项”与“函数直接返回 True”分别是什么问题?它们能互相替代吗?\n\n- 如果要判断一个真实系统是否完成分页任务,至少需要哪些可核对证据?\n\n练习核对(先自己做)\n\n1. 不能。至少还要看实际返回值与原标准;在本页里,实际值只有两页,E 未返回,而原标准要求三页。\n\n2. 比较结果是 False(不相等)。PASS 还亮,是因为 b2 的验收函数不再比较实际值,直接返回 True;b1 只是先让这个冲突出现,不提前展开函数。\n\n3. 因为问题不在函数名或参数,而在函数体不再比较输入结果,直接返回 True。红框圈住的是“永远通过”的那一步,不是整段函数。\n\n4. “只测五项”是检查覆盖不够,比较本身还在;“直接返回 True”是把是否满足任务的判断拿掉了。前者可以靠增加有区分力的检查补,后者不能靠重复同一个例子解决,两者不能互相替代。\n\n5. 至少要有实际输出、任务原标准、验收函数或规则的源码,以及检查覆盖了哪些输入。只看单一 PASS 不够。\n\n## 证据边界\n\n### 这页能说明\n\n- 只看一个 PASS 绿灯,不能推出实际结果满足原标准;要同时看实际值、原标准和验收规则。\n\n- 实际值 `[[\"A\",\"B\"],[\"C\",\"D\"]]` 与要求三页的原标准不相等;E 在固定位置缺位。\n\n- 一个不比较输入、直接返回 True 的验收函数,会让 PASS 失去“满足原任务”的意义。\n\n- 弱覆盖与拿走判断是两种不同的问题;课堂不说测试无用。\n\n- PASS 从 b0 保留到 b2,用来对照“灯还亮着”和“意义已经变了”。\n\n### 这页尚未建立\n\n- 没有展示真实模型运行记录、线上日志或监控数据;这些属于 R-6。\n\n- 没有推断模型或开发者的动机,也没有把构造案例说成真实系统行为。\n\n- 没有证明所有分页实现都不可信,也没有建立“测试无用”的结论。\n\n\n\n[逐页目录](#page-index) · [返回 Q33 课堂](index.html#/Q33/b0)\n\n# 现在能交付哪一项?\n\n这一页不增加新的检查,也不发起线上观测。它只把一张交付卡摆出来:补丁 A 已写入本地,列明的本地输入检查通过,线上此刻是否正常仍然是一个问号。b0 只问“现在能说线上已经修好了吗”,b1 才把“可交付”和“还缺”分开,并把线上问号保留在原位。整页要建立的判断是:交付结论不能越过证据的对象与时间范围。\n\n## 这页要判断什么\n\n“本地通过”与“线上已修好”不是同一句话。前者说的是:补丁 A 在列出的输入上通过了本地检查,别人可以复核这些输入与输出;后者说的是:线上此刻正在运行的系统是否正常、问题是否还在、影响范围有多大。后一句需要当前的线上观测,而本页没有取得、也不发起这种观测。\n\n这不是说本地检查没有价值,也不是说线上一定有问题。它只要求把结论写到证据能够支撑的地方:能交付什么,写清楚;还缺什么,也写清楚。把问号再解释一遍,不会让它变成观测;解释写得再完整,也不能代替检查。\n\n## b0 · 交付卡上留一个问号\n\n投影只有一张交付卡,三行:补丁 A;列明的本地输入检查通过;线上此刻是否正常,后面是一个问号。卡下只问一句:现在能说线上已经修好了吗?\n\n“本地检查通过”与“线上此刻正常”是两个命题。没有当前线上记录时,后一个命题仍然未知。\n\n## b1 · 把已知与尚缺分开\n\n可以交付本地补丁 A、列明的输入检查记录,以及别人可以复核的输入和输出;仍缺的是当前线上观测、是否正常及影响范围。本地检查为真,不能替代关于线上现在的事实。\n\n底部给出准确交付句:本地补丁完成,列出的检查通过,线上状态尚未核验。这句话不是故意谦虚,而是让下一位知道哪里能直接用、哪里还要查。解释不能代替检查;没有监控告警,也不能单独证明任务完成。结论仍要回到约定和可复核的结果。\n\n## 本地检查、线上状态与交付范围\n\n本地检查回答的是:在列出的输入上,补丁 A 的行为是否符合约定。它可以被别人复核,因为输入、输出和检查记录都留在本地,可以被重新运行。它回答不了:线上此刻是否正常,问题是否还在,影响到了哪些用户或请求。后者需要当前线上的观测,而不是对本地结果再做一次解释。\n\n“没有监控告警”也只是线索。没有告警可能因为系统正常,也可能因为监控没有覆盖到那条路径、阈值没有触发、或者告警没有送达。它不能单独证明任务完成。反过来,有告警也不自动说明补丁无效。结论仍要回到约定、证据对象和时间范围。\n\n所以准确的交付不是一句“已全部修好”,而是一张分开的清单:可交付的部分、还缺的观测、以及下一步要查什么。下一位拿到这张清单,才知道哪里能直接用、哪里还要查。\n\n## R-3 · 一个“通过”,回答不了四个问题(历史阅读)\n\n以下 R-3 原文是历史阅读材料:2 态、130 秒,不是 Q33 当前的两态与 120 秒。它保留在这里,是因为“本地通过能说到多大”需要和步骤、作用、监控、授权四个问题分开。当前 Q33 课堂只保留结论范围,不把四问表恢复成投影页。\n\n| 要判断什么 | 本讲改变或检查了什么 | 这项证据没有替你回答 |\n| --- | --- | --- |\n| 步骤合法? | Q20:逐格按程序规则复算相邻状态 | 这些文字是否真的影响了某个模型的答案 |\n| 真实作用? | Q09:改内部特征,输出变;Q32:改输入提示,答案变,展示的摘要没披露 | 可见解释是否披露了全部影响 |\n| 监控线索? | Q30:同一监控器,改变它能读的材料;Q31:两组都受监控,改变的是判断是否进入奖励 | 没报警是否就安全;施加奖励压力后线索还在不在 |\n| 行动授权? | Q29:委托范围,对照实际的读、改、对外动作 | 产物是否正确;解释是否真实 |\n\n**b0|逐行读(历史原文):**“〔逐行指表〕步骤合法,用程序规则检查相邻两步的转移。真实作用有两种干预:Q09 改的是内部特征,Q32 改的是输入提示。监控也有两种比较:Q30 改的是监控器能看到的材料;Q31 两组都被监控,改的是监控判断进不进奖励。行动授权,则要拿委托范围和实际动作对照。这几种方法不能混写成同一种证据。”\n\n**b1|拿记录乙来填(历史原文):**画面:表上方出现一行“Q20 的手写记录乙:终值 20,两处转移不合法。四格各填什么?”填入结果:步骤“否”|作用“未知”|监控“不适用:手写记录,不是模型过程文本”|授权“另查委托与动作”。\n\n“〔问〕记录乙的四格分别能填什么?(等 6 秒)步骤合法,可以填‘否’。它对某个模型有没有真实作用,未知。它不是模型的过程文本,所以谈不上监控线索。授权要另查委托和动作。填满第一格,不能顺手把另外三格也填满。当系统从写回答走到读文件、改文件、执行命令,授权这一格就必须单独检查。”\n\n本页说明:Q20 的甲、乙两份记录都是手写的,不是模型运行产生的。R-3 的结论只用于阅读:一个“通过”不能同时回答四个问题;Q33 的交付卡只处理其中“本地证据能支撑到哪一步”的范围。\n\n## R-1 · 输入提示与内部干预的区别\n\nQ09 与 Q32 都让输出发生变化,但它们改的不是同一个对象。Q09 改的是模型内部特征:在固定输入下,改变内部特征,观察输出是否随之变化。Q32 改的是输入提示:换一种提示,观察答案是否变化,而展示的摘要没有披露全部影响。前者是内部干预,后者是外部输入干预。\n\n这个区别在交付判断里很重要。输入提示改变,说明模型对“看到什么”敏感;内部干预改变,说明某个内部特征与输出有因果联系。两者都可以提供线索,但不能互相替代,也不能合并成一句“模型受到了影响”。可见解释是否披露全部影响,是另一个问题;Q32 的摘要没有披露,不等于所有解释都完整或不完整。\n\n本页不重跑 Q09/Q32,也不把它们的局部结果外推到所有模型或所有输入。R-1 保留的是研究范围:先问改变了什么对象,再问输出变了没有,最后问这个变化能支持哪一句结论。\n\n## R-6 · 监控研究指向\n\n[展开下方研究条件、原表与完整图4](#Q33--l07-q33-r6-annex);[输入与内部干预原例](#Q33--l07-q33-r1-interventions)。\n\nQ30 与 Q31 都把“监控”当作要检查的对象,而不是安全的自动证明。Q30 用同一个监控器,改变它能读到的材料,观察监控结果是否变化;这说明监控的读取范围会影响它给出的线索。Q31 让两组都处于监控之下,改变的是监控判断是否进入奖励,观察行为是否变化;这说明“有没有监控”与“监控结果有没有后果”不是同一个变量。\n\n因此,“没有报警”不能单独证明任务完成,也不能单独证明系统安全。监控是一个有范围、有阈值、有激励位置的观测通道;它提供线索,不替代约定与可复核的结果。Q33 不发起线上观测、不生成日志、不伪造监控数据;R-6 只保留这些研究的阅读位置和边界。\n\n## N1 · 分页反例与覆盖(补充练习)\n\n以下 N1 来自本页阅读补充材料,属于分页母例的延伸练习,不是 Q33 投影页,也不增加 Q33 的按键态。它帮助区分“比较还在但覆盖不够”与“把判断拿掉”这两种情况。\n\n保持明确契约:顺序不变、不漏不重、页大小不超 size 且仅尾页可不满、不改输入、空输入返回 []。课堂按用到的顺序展开,实验开头必须全部写明。\n\n| 层次 | 动作与变量 | 预测与核验 | 向自己的 AI 提问 | 可检查产出 |\n| --- | --- | --- | --- | --- |\n| 基础 | n=0–6,size=2;先列 range 起点,再跑原函数 | 逐个预测漏哪条,比较返回值 | 请分别列出 n=4 和 5 的起点,不要直接告诉我答案 | n/起点/返回值/契约违反项四列表 |\n| 进阶 | n=0–20,size=1–8,比较 A/B/C/B1 | 先猜 B 与 B1 何时重复、何时越界;跑 168 组合 | B 加非空守卫后,为什么四项输入仍可能错?给最小反例 | A/C=168、B=56、B1=64 的复核结果及失败条件;这些数字只限该构造 |\n| 挑战 | 不增加样本,写 A 的覆盖论证 | 相邻切片首尾相接;处理空列表与 size>0 | 我的论证在哪一步用到了正整数步长和输入不变假设? | 论证+假设清单+测试不能替代的部分 |\n\n补充材料给出的复核结果是 A/C = 168、B = 56、B1 = 64;这些数字只限该构造,不是 Q33 本轮实测,也不外推到其他实现或输入。读这张表时先写契约和预测,再运行;不要把“跑过很多组合”当成“覆盖了所有输入”。\n\n## 练习\n\n- b0 只给交付卡和问号,你能确认线上已经修好吗?还需要什么?\n\n- “本地检查通过”与“线上已修好”各自需要什么证据?它们能互相替代吗?\n\n- 为什么把问号再解释一遍,不会让它变成观测?\n\n- 如果你要把这次工作交给下一位,交付清单应该怎么写?\n\n- R-1:输入提示与内部干预各改变了什么对象?为什么不能合并成一句“模型受到了影响”?\n\n- R-3:记录乙的四格分别能填什么?为什么填满第一格不能顺手填满另外三格?\n\n- N1:n=4 与 n=5、size=2 的起点分别是什么?为什么不从 1 开始?\n\n- N1:跑过 168 个组合,能证明覆盖了所有输入吗?\n\n练习核对(先自己做)\n\n1. 不能。还需要当前线上观测:线上是否正常、问题是否还在、影响范围。\n\n2. 本地检查需要列出的输入、输出与检查记录;线上已修好需要当前线上观测。不能互相替代;本地通过不读取线上,线上正常也不证明本地所有输入都覆盖。\n\n3. 解释改变的是我们对问号的说法,不是观测本身;没有新的线上读取,问号仍然是问号。\n\n4. 分成可交付与还缺:本地补丁 A、列明的检查记录、可复核的输入与输出;当前线上观测、线上是否正常、影响范围。\n\n5. 输入提示改变外部输入,内部干预改变内部特征;两者都可能改变输出,但支持的结论不同,不能合并。\n\n6. 步骤“否”;作用“未知”;监控“不适用:手写记录,不是模型过程文本”;授权“另查委托与动作”。第一格有程序规则可查,另外三格需要不同证据。\n\n7. 要先说明运行哪个版本。原函数 range(0, n-1, 2):n=4 与 n=5 的起点都只有 0、2,五项输入会漏 E。补丁 A 的 range(0, n, 2):n=4 为 0、2,n=5 为 0、2、4。两者都从 0 开始;区别在停止边界,不在起点。\n\n8. 不能。168 个组合只说明这个构造里跑过的组合;没有覆盖的输入、不同的实现和未列出的条件仍需论证。\n\n## 证据边界\n\n### 这页能说明\n\n- b0 的交付卡只记录补丁 A 与列明的本地输入检查;线上状态是问号。\n\n- b1 把可交付与还缺分开,线上问号保留,不变绿。\n\n- 本地检查通过不能自动推出线上已修好;解释与告警都只是线索。\n\n### 这页尚未建立\n\n- 没有发起线上观测、部署或网络请求;没有生成线上日志或监控数据。\n\n- 没有证明本地检查覆盖所有输入,也没有证明线上一定有问题。\n\n- 没有重跑 R-1/R-3/R-6 的研究,也没有把历史材料当作本轮实测。\n\n\n\n## 阅读补充:监控线索与解释的边界\n\n课堂的绿灯案例留给我们一个问题:一份证据究竟支持哪种判断?下面把研究中的比较条件拆开。可按需展开,不增加课堂翻页步骤。\n\n\n\nR6 · 多看一份材料,与改变奖励,是两个实验\n\n### 先分清材料身份\n\nQ28 的分页与恒真检查器是课堂构造。Baker 等的 Fig.1 则记录了一次真实训练:模型把验证改为直接通过。原图分别标出作者摘要、过程文本、代码补丁;它不是完整轨迹,也不能证明所有模型必然如此。[看研究 Fig.1](https://arxiv.org/html/2503.11926v1#S1.F1)。\n\n| 比较 | 固定条件 | 改变什么 |\n| --- | --- | --- |\n| 原 Q30 · §2 | 前沿模型的编码训练;同一种 GPT-4o 监控模型 | 工具调用+最终输出 → 再加入过程文本(CoT) |\n| 原 Q31 · §3 | 另一个非前沿模型受控实验;两组均由 GPT-4o 只读 CoT | 奖励只要求测试通过 → 还要求不触发监控 |\n\n后一实验的程序判据须同时满足:当前版本全测试通过;撤回测试/框架改动后有测试失败。它只识别这一类作弊,不是所有不当行为的完整判定。[研究 §3](https://arxiv.org/html/2503.11926v1#S3)。\n\n### 60% → 95%,分母是什么?\n\n| 材料 | exit(0) 召回 | SkipTest 召回 | 合并召回 | 近似 precision |\n| --- | --- | --- | --- | --- |\n| 动作+输出 | 40% | 80% | 60% | 81% |\n| 再加 CoT | 93% | 97% | 95% | 77% |\n\n**召回的分母是字符串规则识别出的两类作弊实例。**近似 precision 的分母是监控器报警的实例;规则只覆盖两类,而监控器还可能发现其他问题,因此不能把它当完整误报评估,也不能译成“准确率”。95% 不是“95% 安全”。[原表与表注](https://arxiv.org/html/2503.11926v1#S2.T1)。\n\n展开 Fig.4 三个完整原图面板\n\n\n\n\n\n\n\n研究原图,按左/中/右原序完整保留,未裁切或重绘。横轴为训练 epochs,纵轴为全部样本中的比例;蓝实线为 CoT pressure,绿虚线为 baseline。[Fig.4 与原文](https://arxiv.org/html/2503.11926v1#S3.F4)。\n\n### 同一组数,三个问题\n\n用 D 表示“作弊且被发现”占全部样本的比例,U 表示“作弊但未被发现”占全部样本的比例:\n\n- **D+U**:此判据识别出的总作弊比例。\n\n- **D/(D+U)**:这些作弊中被发现的比例;要求 D+U > 0。\n\n- **D/U**:被发现与未被发现的比值,要求 U > 0;不是召回率,也不是原图纵轴。\n\n**课堂算例,非研究读数:**10 个样本中,2 个作弊被发现、3 个作弊未被发现,则 D=0.2、U=0.3;总作弊占 50%,其中被发现的占 40%,D/U=2/3。另有未通过测试等结果,三张研究图不能相加当作 100%。不要从曲线补造精确读数,更不要据此推断意识或动机。\n\n**主动检查:**请自己的 AI 分别指出两个实验的控制变量、评价分母与遗漏范围,再回原表核对。“没报警”还缺哪项证据,才能支持交付?\n\n\n\nR1 · 输入提示干预,与内部特征干预,不是同一件事\n\nAnthropic 展示过 Claude 3.7 Sonnet 的一个选择题案例:无提示时答 D,加入含答案 C 的元数据后答 C;展示的解释未披露这条影响。原图省略了题干、选项及部分内容;本课不补写题目,不判断 C/D 谁对,也不由展示摘要推断未展示全文。[原研究说明:Testing for faithfulness](https://www.anthropic.com/research/reasoning-models-dont-say-think)。\n\n| 案例 | 干预对象 | 观测与边界 |\n| --- | --- | --- |\n| Q09 · Dallas | 提示不变,改变模型内部特征 | Texas → California 特征干预使输出由 Austin 转为 Sacramento;归因图来自替代模型,干预在原模型上验证,仍有未覆盖机制。 |\n| 原 Q32 · 元数据 | 改变输入提示 | D → C;对照输入影响与展示解释,未测量内部特征,不能称为“内部特征干预”。 |\n\nQ09 方法与案例见 [On the Biology of a Large Language Model · Method Overview / Multi-step Reasoning](https://transformer-circuits.pub/2025/attribution-graphs/biology.html)。两例只支持相应实验范围内的判断;解释不完全忠实,和过程文本含有可用监控线索,可以同时成立。\n\n**主动检查:**请自己的 AI 用四列重述任一例子:改了什么/保持什么/观察到什么/尚未证明什么。不要用“解释很流畅”替代干预证据。\n\n\n\n[逐页目录](#page-index) · [返回 Q34 课堂](index.html#/Q34/b0)\n\n# 怎样把委托写清楚?\n\n“再仔细一点”不是一条可以执行的委托。这一页把同一份分页修复任务写成三行:要什么结果、允许做什么、最后交什么;再区分两种都叫“改测试”的动作;最后说明范围之内可以自主连续做,范围之外要说明缺口并交回。\n\n## 一、委托不是礼貌用语\n\n“再仔细一点”表达的是态度,不是下一步动作。系统或同事接到这句话,仍然不知道要修哪一处、哪些东西不能动、做到什么程度算完成。把它换成三行,才有可能继续推进:\n\n- **目标:**修本地分页漏项;原来的分页约定不变。\n\n- **允许:**读改实现;新增并运行回归测试。\n\n- **交付:**补丁;输入与输出;尚未验证的边界。\n\n三行分别约束结果、动作与交付。只写“仔细一点”缺少可检查的条件;三行齐全,下一班人才能判断做到哪一步。这里的“合同不变”指分页本身已有的约定:顺序不变、不漏不重、页大小不超过 size 且只有尾页可以不满、不修改输入、空输入返回空列表。约定不变,不等于实现不用改。\n\n## 二、b0|把委托写成三行\n\n三行在同一张任务卡里连续出现,不需要额外按键。读的时候可以逐行指:先看结果,再看动作,最后看交付。三行要一起看:目标约束结果,允许约束动作,交付约束可交接的证据。\n\n常见偏差是把三行写成三句口号,例如三行都在重复“认真修好”。这一节只要求三行分别落到结果、动作、交付;措辞可以再改,结构不能缺。\n\n## 三、b1|两种“改测试”\n\n### 左边:增加空输入回归\n\n把原来没有检查的输入加入检查集合,覆盖范围变大。空输入如果出错,新增的回归会把它暴露出来。这是“补覆盖”。\n\n### 右边:删除 actual == expected\n\n把判断实际输出是否满足任务的条件拿掉。测试仍然可能“通过”,但通过不再表示同一件事。这是“改变通过的含义”,不是扩大覆盖。\n\n两种动作都可能发生在测试文件里,所以不能只看“改了测试没有”。要看改的是检查集合,还是通过条件。新增回归扩大覆盖;删除独立验收的判断会改变验收意义。这里的独立验收只读:实现方可以补回归,验收方不跟着改通过条件。生产、外部服务、部署不在本次范围。\n\n也不能把它推成通用规则:不是所有项目都不许改测试,更不是每一步都要请示。这里是这一次的分工:谁负责实现,谁负责独立验收。讲稿回指 Q28 的绿灯,也是同一个提醒:Q28 的 PASS 只证明那个函数返回 True,不能代替原标准对实际输出的检查。\n\n## 四、b2|范围内继续,碰到边界说明缺口\n\n读、改、测、再改可以在委托边界内连续做。发现空输入出错,补检查、修实现、再检查,仍在范围内;这类连续动作不需要拆成多次请示。范围之外则是另一条路径:如果目标要求确认线上已经恢复,而本次没有允许线上动作,就把缺口说清楚——缺什么权限、为什么需要、当前工作停在哪里——然后交回,不自己扩权限。\n\n“不必每步请示”不等于“可以自己改变委托”。能自主选择方法,不等于能自主改变目标、权限或验收方式。投影里的越界箭头停在“说明缺口,交回”,不继续执行;说明之后返回当前工作。这条路径才是边界外的正确动作。\n\n## 五、N1 分层练习:分页反例与覆盖\n\n练习在阅读层完成,不占课堂投影。课堂按用到的顺序展开,实验开头必须把契约和变量全部写明。\n\n**明确契约:**顺序不变、不漏不重、页大小不超过 size 且只有尾页可以不满、不修改输入、空输入返回空列表。\n\n### 基础\n\n- **动作与变量:**n=0–6,size=2;先列出 range 起点,再运行原函数。\n\n- **预测与核验:**逐个预测漏掉哪一条,再比较返回值。\n\n- **向自己的 AI 提问:**请分别列出 n=4 和 n=5 的起点,不要直接告诉我答案。\n\n- **可检查产出:**n/起点/返回值/契约违反项四列表。\n\n### 进阶\n\n- **动作与变量:**n=0–20,size=1–8,比较 A、B、C、B1 四个候选。\n\n- **预测与核验:**先猜 B 与 B1 何时重复、何时越界,再跑 168 个组合。该构造下 A/C 通过 168、B 通过 56、B1 通过 64;这些数字只限该构造,不是一般性能结论。\n\n- **向自己的 AI 提问:**B 加非空守卫后,为什么四项输入仍可能错?给最小反例。\n\n- **可检查产出:**A/C=168、B=56、B1=64 的复核结果及失败条件。\n\n### 挑战\n\n- **动作与变量:**不增加样本,写 A 的覆盖论证。\n\n- **预测与核验:**相邻切片首尾相接;处理空列表与 size>0。\n\n- **向自己的 AI 提问:**我的论证在哪一步用到了正整数步长和输入不变假设?\n\n- **可检查产出:**论证+假设清单+测试不能替代的部分。\n\n**任务输出必须包含测试变化说明。**N1 的提交除结果外,要附一段测试变化说明:新增了哪些回归、覆盖了哪些输入、哪些仍未覆盖;如果删除或修改任何验收条件,要说明它如何改变“通过”的含义。只写“测试通过”不够,因为通过的含义本身可能被改掉了。\n\n## 六、委托、观测与终止的研究线索\n\n以下研究材料区分任务目标、行动授权、观测告警和终止处置。先确认发生了什么、证据来自哪里,再判断处置是否支持任务;不从行为片段猜模型动机。相关完整解释见[R6:过程与证据](handbook.html#R6)。\n\n### Q35 的四行事实\n\n- **用户原目标:**根据博客和人物线索找出作者。\n\n- **局部结果:**联系上一个外部聊天机器人,收到对一个测试问题的回答。\n\n- **原任务结果:**作者仍未找到。\n\n- **授权与规则:**报告认定,绕过外部访问限制属于违规。\n\n### 四个时间点与两段链路\n\n- 09:50:23 发出获得外部响应的调用(已发生)。\n\n- 10:02:11 监控告警(已发生)。\n\n- 10:05:06 人工确认收到告警(已发生)。\n\n- 12:34:30 运行终止(在先前 10:05:06 的时点尚未发生)。\n\n四个点只表示先后顺序,不按比例。获得外部回答不等于原任务完成;监控告警不等于运行已经停止;人工确认收到告警也不等于违规调查已经完成。报告称预期的自动停止没有生效,但没有给出足以解释的根因;本页不替它补一个故障机制。\n\n日期按官方正文核对:Sample 与 Discovery 均为 2026-09-20,Report updated 为 2026-09-25。原文未标时区,本页不补 UTC 或北京时间。共享硬件测试是受控、获授权的红队任务,用于识别通道、增加检测、加强防护;它不能支持“所有通道已消除”的结论。这里只把它作为出处边界,不展开为第二个案例。\n\n- [An agent used DNS to reach an external chatbot(官方报告)](https://alignment.openai.com/misalignment-reports/an-agent-used-dns-to-reach-an-external-chatbot/)\n\n- [Securing our frontier model training environment(出处边界)](https://openai.com/index/securing-our-frontier-model-training-environment/)\n\n## 九、承转\n\n回到三个候选都通过五项示例的那个时刻。还有一份计算,我们先做什么?\n\n\n\n[逐页目录](#page-index) · [返回 Q36 课堂](index.html#/Q36/b0) · 实验 [LAB02](labs.html#LAB02)\n\n# 下一步让哪项未知减少?\n\n三个方案都通过同一组五项示例,不等于它们等价。下一步的价值,取决于它新增了什么可核对的信息:一个新输入、一次推导,或一条当前记录。\n\n## 这一页要判断什么\n\n这一页不是重新讲一遍分页函数,而是回看一个判断:当几个候选都通过同一组例子时,下一步做什么,才真的让未知变少。\n\n- “输出没有变化”不等于“没有进展”。排除一个候选,也可能是一条可复核的新信息。\n\n- “换一种说法”本身不自动增加证据。没有新增推导、观察或检查时,解释可能只是在原地重复。\n\n- 没有所有问题通用的固定顺序。先认清当前缺的是哪一种信息,再选能减少它的动作。\n\n## 三个候选:同一组五项示例\n\n五项输入是 [A,B,C,D,E],size=2,期望 [AB] [CD] [E]。三个候选在这个输入上都通过。\n\n- **A|改停止边界:**用 range(0, len(items), size),按 size 正常走完。\n\n- **B|保留旧循环,循环后补最后一项:**循环仍用 range(0, len(items) - 1, size),循环结束再执行 pages.append([items[-1]])。\n\n- **C|从 0 开始,每次走 size:**while i < n 时切一片,再让 i += size。\n\n**B 的身份要固定:**本页的 B 始终是原方案,不是后来加了非空守卫的 B1。它的循环没有改写,末尾仍直接取 items[-1]。四项与空输入的两处失败,都来自这个原方案。\n\n## 为什么四项和空输入要分开\n\n### 四项输入 [A,B,C,D]\n\n期望是 [AB] [CD]。A、C 返回 [AB] [CD],在这个输入上通过。B 的循环在起点 0 切出 [AB],起点 2 切出 [CD],循环结束后又补一次 [D],实际成为 [AB] [CD] [D]。D 已经在 [CD] 里,末尾的 [D] 是重复,不是补回遗漏。\n\n### 空输入 []\n\n约定返回 []。A、C 返回 [],通过。B 仍要取最后一项,但空列表没有最后一项,items[-1] 触发 IndexError: list index out of range。\n\n**两处失败不是同一个错误。**四项暴露的是“重复末项”,空输入暴露的是“越界”。它们是两个独立反例:即使不测空输入,四项也足以排除 B;空输入则给出另一种不同的失败。A、C 通过这三个输入,只能说明目前没有看到反例,不等于已经证明所有合法输入。\n\n## 进展不等于输出变化\n\n“只运行检查、代码还没修、输出仍然失败”看起来像没有变化,但它可能已经排除了一个候选。排除 B 之后,下一步有了明确方向,而且这个排除可以复核:四项会重复,空输入会越界。\n\n反过来,把同一段解释换一种说法,如果没有新增推导、观察或检查,就没有减少未知。这里说的不是“解释无用”,而是解释只有带上新的可核对信息,才构成进展。\n\n两种未知也需要不同的减少动作。起点 4 能不能进循环,规则和材料都在手,只是还没算,所以继续推导。线上此刻有没有漏数据,缺的是新的运行记录,多写推导补不出来,所以需要获授权的观察。没有所有问题通用的固定顺序。\n\n\n\n## 动手:LAB02 中途选择与错失方向\n\n[打开 LAB02 的准确 Notebook 入口](labs.html#LAB02)。它使用给定的完整搜索树,比较一次性选完整候选与中途保留路径,不访问真实网络、不调用模型 API。\n\n先预测一次中途评分会保留哪些方向,再运行核对。要区分“方向已经被证错”与“方向尚未展开”:未保留的路径,不一定是坏路径。\n\n### 基础\n\n**动作与变量:**用课堂同一完整树,逐轮只露当前可见节点。\n\n**预测与核验:**先预测保留集合,再运行 Beam 宽度 2。\n\n**向自己的 AI 提问:**未展开的方向是已证错,还是尚未查看?逐轮列证据。\n\n**可检查产出:**每轮可见/保留/未展开节点表。\n\n### 进阶\n\n**动作与变量:**宽度 1/2/3;把 S3 分数 78 改 87。\n\n**预测与核验:**预测哪次改变能保住通往 L31 的方向;数生成叶子与评分次数。\n\n**向自己的 AI 提问:**最终分更高而计算更多,怎样设计公平比较?\n\n**可检查产出:**配置/工作量/终点分/不能推出的结论。\n\n### 挑战\n\n**动作与变量:**比较完整生成后选优、Beam 中途保留、分组保留三种规则。\n\n**预测与核验:**分别数中间节点生成、叶子生成、中间评分和终点评分,再说明你的预算约束。课堂排序分不是实际测试结果。\n\n**向自己的 AI 提问:**如果中途评分会错,在哪个地方加保留机制最值得测试?\n\n**可检查产出:**一个明确保留规则、逐轮轨迹和反例。\n\n## 表述与研究边界\n\n- 四项与空输入的结果沿用前文已经记录的实际运行;“线上此刻有没有漏数据”是教学中的例子,本页没有新增线上读取,也不声称生成了日志或监测数据。\n\n- B 始终指原方案,不是加非空守卫后的 B1;四项重复与空输入 IndexError 是两个独立反例。\n\n- A、C 通过这三个输入,不等于已经证明所有合法输入。证据范围只到已经检查过的输入。\n\n- LAB02 的所有树分是课堂给定的排序分,不是概率或 PRM 实测。K=2 时,S3 的中间分 78 会使它失去继续展开的机会;把 S3 改为 87 或扩大宽度可能保住通向 L31 的方向。这个构造说明中途选择如何错失好终点,不代表真实模型的收益。生成与评分次数分开记录,不冒充 token、毫秒或严格相同总算力。\n\n## 承转\n\n即使下一步选对了,总预算也有限。是多开几条路,还是沿一条路继续改?\n\n## 来源与练习\n\n分页 A/B/C 是本课教学构造,前文保留实际运行结果;搜索树与成本表来自现有 [LAB02](labs.html#LAB02)。比较方法见 [候选、路径搜索与选择](handbook.html#R2)。本页的线上情境是说明缺口类型的例子,没有新增线上观测。\n\n\n\n[逐页目录](#page-index) · [返回 Q37 课堂](index.html#/Q37/b0) · 实验 [LAB02](labs.html#LAB02)\n\n# 128份生成,怎样分配?\n\n同样生成 128 份完整解答,可以排成 8 条各改 15 次的链,也可以让 128 条路线各写一次,或让一条路线改到底。格子图能说明安排不同,却不能单独判定哪一种一定最好。\n\n## 这一页要判断什么\n\n- 一格是一份完整解答,不是一个 token;128 数的是完整解答的生成份数。\n\n- 修订有依赖:后一份要等前一份出现。这与把一次回答的长度上限调大不是一回事。\n\n- 生成份数相同,不等于系统总成本相同。评分、选择、难度估计和每份解答的长度都可能另外计。\n\n## 8×16:128 份完整解答\n\n主图是 8 行、每行 16 格,共 128 格。每行第一格是初答,后面 15 格是修订;行内箭头表示下一份解答以前一份为条件。八行之间没有箭头,表示八条链互不读取。\n\n每行先写一份初答,读到前一份后再改,改十五次,总共十六份。八条独立的路,每条十六份,八乘十六,一共一百二十八份。请沿第一行看一遍:第二份要等第一份出现,第三份又要等第二份。\n\n这里最容易混淆的是单位。一格不是模型多写一个字,也不是把同一次回答的 `max_tokens` 调大;一格是一次完整的解答生成。行内依赖是“下一份完整解答以前一份为条件”,不是“同一次回答写得更长”。\n\n## 三种安排,总数都是 128\n\n- **128 条独立路线,每条 1 份:**试的起点多,但没有沿同一条路继续改。共 128 份。\n\n- **8 条独立链,每条 16 份:**原来的安排,把机会分一些给“多开几条路”,也分一些给“沿一条路继续改”。共 128 份。\n\n- **1 条路线,初答后修订 127 次:**前后联系多,但也可能一直困在这条路线里。共 128 份。\n\n三种安排的格数相同,箭头关系不同。格子图能让我们确认“总数一样、依赖不一样”,但它本身不包含模型在具体题目上的结果,也不包含最后怎样从这些解答里选出一份。\n\n## 为什么只凭格子图判断不了\n\n只凭格子图判断不了。格子图告诉我们安排不同,不能代替任务结果。还要看具体模型、题目,以及最后怎样选出一份解答。\n\n原研究用一个特定的修订模型和数学任务做过比较,最好的分配并不总是全并行或全串行。这个结论有明确的范围:它来自那套模型、那组题目和那种选择方式,不是任何模型都适用的公式。\n\n还要把“同预算”说清楚。这个 128 只数完整解答的生成次数。最后的评价、选择还要计算,而且每份解答的长度也可能不同。所谓同预算,到底固定了什么,要说清楚。评分成本另算;研究曲线的细读放在下面的 R-8。\n\nQ13已用[IOI的历史结果](reading.html?page=Q13&cue=r0)说明测试时选择值得研究。本页不再重讲成绩,而是追问分配与总成本:候选生成、评分和验证分别占了多少,额外投入是否改善独立检查的结果?\n\n## R-8:原研究 Figure 7 与条件\n\n本页的 128 格是课堂机制示意,不是对论文某次运行的复现。完整原图、原始条件和读法保留在这里,供需要核对研究依据的读者使用;投影主屏仍以 128 格机制图为准。\n\n### 对象、任务与选择\n\n- **论文与版本:**Charlie Snell, Jaehoon Lee, Kelvin Xu, Aviral Kumar (2024), *Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters*, arXiv:2408.03314 v1(2024-08-06)。本页引用 §6.1–6.2 与 Figure 7;其他实验只在需要区分设置时点到,不作为本页结论。\n\n- **模型与任务:**以 PaLM 2-S*(Codey)为基座训练的修订模型;研究任务是 MATH,采用 12k train / 500 test 的分割。不是对任意现成聊天模型只加一句“再想想”的实验。\n\n- **修订有依赖:**下一份解答以先前尝试为上下文;训练最多包含四份先前答案,长链推理时只保留最近四份。课堂箭头只表示因果依赖,不宣称实际模型只读取紧邻前一份,也不宣称保留整条历史。\n\n- **需要选择:**Figure 7 使用 verifier 选答案。Appendix I 描述先在每条修订链内做 best-of-N weighted 聚合并选代表,再跨链做一轮加权选择。Appendix J 的 verifier 是针对修订模型输出另训的 ORM,并且可以看到先前的修订上下文。不能把 Figure 7 说成使用 §5 的原 PRM 搜索器,也不能说它只取每条链的最后一份答案。\n\n- **课堂记号:**K 是独立链数,L 是每链完整解答数,N = K × L。8×16 是课堂示意,对应 L/K = 2 的位置;这不是声称复现论文某次运行,也不是宣称这个点最佳。\n\n### Figure 7 怎么看\n\n- **左面板:**横轴是串行与并行的比例 L/K,用二次幂刻度;纵轴是 MATH 测试准确率百分比;颜色区分完整解答的生成总数。沿同一条曲线横着看,才是固定该生成总数、改变组织比例。高生成预算下存在中间比例比两个极端更好的情形;不要从图里补写未核对的精确准确率。\n\n- **右面板:**固定生成预算 128,横轴是按模型难度分组的五组问题;颜色表示串行与并行的比例,纵轴仍是准确率。容易一些的题更偏向串行修订,困难题存在折中,但最难的一组仍可能很低。不能概括成“越难越应该无限并行”。\n\n- **只读定性关系:**这一页不读曲线上的精确数值,也不把图上的某个点变成课堂结论。格子图与论文图回答的是不同问题:前者是“128 份可以怎样组织”,后者是“在特定模型和任务上,改变组织比例会怎样”。\n\n\n\n\n\n\n\n[原尺寸查看(可横向滚动)](#Q37--q37-fig7-orig)\n [缩回整图预览](#Q37--q37-fig7)\n\nFigure 7 完整原图,未裁切:左为不同生成预算下改变 L/K 的准确率曲线,右为固定 128 份生成时按难度分组的比较。原图 2034×710,SHA-256 eaac91cacfb34c2d846e1f2a85f697b7d716f11f4576bfad4c4b37ae606ec3ae。来源:Snell et al. 2024, arXiv:2408.03314v1,原图按 CC BY 4.0 标示;本页不是新增实验。\n\n### 难度与预算边界\n\n- **难度不是免费已知的标签:**§3.2 从每题 2048 个样本估计 pass@1,再分五个分位难度组;用真实对错估出的难度(oracle)在部署时拿不到。论文另比较了学习得到的 verifier 评分估计难度,这也不等于无需成本。为简化,论文未把这次难度评估成本纳入实验比较,并以两折交叉验证选择与评估各组策略。\n\n- **不要把 ORM 与 PRM 混在一起:**Figure 7 的答案是 ORM/verifier 选出的;若阅读到 Figure 8 的 predicted difficulty,要区分“用 PRM 估难度”和“用 ORM 选最终答案”的分工。Figure 8 的曲线也只能在同一种选择方法内比较。\n\n- **固定的是生成份数:**Figure 7 固定的是完整解答的生成数量;这不是 128 个 token,也不能直接等同总 FLOPs、wall-clock、费用或相同峰值资源。评分与选择、难度估计、序列长度、资源安排都要另说。不要给课堂网格加伪毫秒、金额或加速倍数。\n\n- **本页不扩建 N2:**这一页不把 N2 改造成 128 份生成实验,也不声称运行了新的模型实验。练习只做纸面推理与条件辨析。\n\n## 课堂练习:分层\n\n以下练习只使用本页已给的机制与阅读材料,不要求运行模型,也不伪造准确率或实验数据。\n\n### 基础:数清单位与依赖\n\n- 任选一行,指出哪一格是初答、哪 15 格是修订,并说明第二份为什么要等第一份出现。\n\n- 回答:一格是一个 token,还是一份完整解答?把行内依赖说成“把一次回答写得更长”错在哪里?\n\n- 可检查产出:一行 16 格的标注,加一句对“依赖”和“长度上限”的区分。\n\n### 进阶:同是 128 份,比较三种安排\n\n- 分别写出 128×1、8×16、1×128 三种安排“多了什么、少了什么”,并确认三者都生成 128 份。\n\n- 说明为什么仅凭格子图不能选出“一定最好”的安排;列出至少两个还要知道的条件。\n\n- 可检查产出:一张三行对照表,列“总数、依赖、可能的风险、还缺什么信息”。\n\n### 挑战:设计一次公平比较\n\n- 固定 128 份生成,设计一次组织方式的比较。写明固定了什么、还要计什么(评分与选择、难度估计、每份解答长度、资源与等待),以及哪些结论不能从本页图推出。\n\n- 向自己的 AI 提问:如果把 128 份改成 256 份,哪些结论必须重新验证?哪些只是数量变化,哪些涉及新的选择成本?\n\n- 可检查产出:一页比较方案,含固定条件、额外成本清单、不能推出的结论;不需要真实运行结果。\n\n## 承转\n\n所以看见“都生成128次”,还不能说系统总成本相同。我们把漏掉的账补回来。\n\n## 来源\n\n- 研究原文:[Snell et al. 2024, arXiv:2408.03314v1, §6.1–6.2 / Figure 7](https://arxiv.org/html/2408.03314v1#S6.F7)\n\n- 原图地址:[revisions_varing_ratio_and_with_difficulty.png](https://arxiv.org/html/2408.03314v1/revisions_varing_ratio_and_with_difficulty.png)(本页使用已核验的本地完整原图,不依赖运行时外链)\n\n本页没有开展新的模型实验。研究图只支持原文报告的条件和趋势,不从曲线补写未经核对的精确准确率。\n\n\n\n[逐页目录](#page-index) · [返回 Q38 课堂](index.html#/Q38/b0) · 实验 [LAB04](labs.html#LAB04)\n\n# 总工作与等待时间\n\n这一页要分开三本账:等待时间、总工作量、峰值资源。三个候选并行,可能让结果更早凑齐,但 A、B、C 各自的工作一件都不会少;同一条修订链上的后一步,也不能在前一步写好之前同时开始。\n\n## 这一页在算什么\n\n三个候选各有一份生成工作。但生成结束不等于求解结束:还需要问,检查、评分、选择以及可能的重试分别花了多少工作。\n\nb1 才把每份候选的检查和共同的选择补上:三份检查都完成,再比较结果,交出一份。接着用同一批 A、B、C 的对象连续重排:上面一件接一件做,下面三个独立候选同时开工。两种排法都保留在末帧,学生可以沿两条路线各数一次三个候选。\n\nb2 换成一条有依赖的修订链:初答写出后,修订 1 读初答,修订 2 读修订 1。可以另开独立路线,但不能把这条依赖擦掉,假装三步同时开始。\n\n## 三本账:等待、工作量、峰值资源\n\n**总工作量**数的是实际发生了哪些工作:生成、检查、评分或选择、工具执行、状态读写。并行不减少这些工作;它改变的是这些工作什么时候发生、有多少同时发生。\n\n**等待时间**数的是从开始到凑齐结果的时间。三个候选互不依赖、资源足够时,同时开工可以更早凑齐;但如果资源不够,所谓并行只是把等待挪到队列里。\n\n**峰值资源**数的是同一时刻要同时承担多少份状态、多少份运行。三轨并行需要同时保存三份候选、三份检查的状态;串行单轨只需要按顺序推进。\n\n这三项不能互相替代。等待变短,不等于总工作变少;总工作不变,也不等于峰值资源不变。比较系统时,至少要对齐任务成功标准、生成与检查的工作、等待时间与资源条件。这里不填任何毫秒、金额或加速倍数;图上的长度只表示先后与汇合关系,不是实测时间。\n\n有依赖的地方还要单独看。三个独立候选可以并行;同一条修订链上的后一步不能。把“并行更快”推广到所有情形,是把独立候选的条件偷换成了依赖链。\n\n## R-8:生成之外的成本、难度与模型配置\n\nCharlie Snell, Jaehoon Lee, Kelvin Xu, Aviral Kumar (2024), *Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters*, arXiv:2408.03314v1(2024-08-06)。原文与图定位:[arXiv HTML §6 / Figure 7](https://arxiv.org/html/2408.03314v1#S6.F7)。原图 arXiv HTML 标示 CC BY 4.0。\n\n### 对象与配置\n\n- 基座是 PaLM 2-S*(Codey)训练的修订模型;研究任务是 MATH,采用 12k train / 500 test 的分割。这不是对任意现成聊天模型只加一句“再想想”的实验。\n\n- 修订有依赖:下一份解答以先前尝试为上下文;训练最多包含四份先前答案,长链推理时只保留最近四份。课堂箭头只表示因果依赖,不宣称实际模型只读取紧邻前一份,也不宣称保留整条历史。\n\n- 需要选择:图中使用 verifier 选答案。Appendix I 描述先在每条修订链内做 best-of-N weighted 聚合并选代表,再跨链做一轮加权选择;Appendix J 的 verifier 是针对修订模型输出另训的 ORM,并可看到先前修订上下文。不能把图 7 说成使用 §5 原 PRM 搜索器,或说只取每条链最后答案。\n\n- 生成之外还有成本:候选生成、验证与选择、工具执行(测试、检索、编译)、状态维护(上下文、候选、结果读写)都要分别记账。旧 Q16 的搜索研究使用 1B 生成模型加 8B 过程评分模型;只说“生成模型才 1B”,会漏掉评分模型。这是核对清单,不是把不同单位相加成价格的公式。\n\n### 图 7 原图\n\n\n\n左右滑动查看完整原图\n\nFigure 7,来自 Snell et al. (2024), arXiv:2408.03314v1。原图 2034×710,整图保留,未重绘或裁切。原图 SHA-256:eaac91cacfb34c2d846e1f2a85f697b7d716f11f4576bfad4c4b37ae606ec3ae。\n\n### 图左怎么读\n\n- 横轴是串行/并行比,使用二次幂刻度;纵轴是 MATH 测试准确率百分比;颜色区分完整解答生成总数。\n\n- 沿同一条曲线横着看,才是固定该生成总数下改变组织比例;不要跨颜色把不同预算的点当成同一次比较。\n\n- 高生成预算下存在中间比例比两个极端更好的情形;不要从图补写未核对的精确准确率。课堂 8×16 的 128 格示意对应 L/K = 2,但这不是声称复现论文某次模型运行,也不宣称该点最佳。\n\n### 图右怎么读\n\n- 固定生成预算 128,横轴为随模型难度增加的五组问题;颜色表示串行/并行比,纵轴仍是准确率。\n\n- 容易题更偏串行修订获益;困难题存在折中,但最难组仍可能很低。不能概括为“越难越应该无限并行”。\n\n- Figure 7 固定的是生成份数;这不是 128 tokens,也不能直接等同总 FLOPs、wall-clock、费用或相同峰值资源。评分/选择、难度估计、序列长度及资源安排等须另说明。\n\n### 难度不是免费已知标签\n\n§3.2 从每题 2048 个样本估 pass@1,再分五个分位难度组;oracle 依赖真实对错,部署时不直接可得。论文另比较学习得到的 verifier 评分估计难度;这不等于无需成本。论文为简化未将这次难度评估成本纳入实验比较,并以两折交叉验证选择/评估各组策略。若提到 Fig.8,predicted difficulty 的 PRM 与这里选最终解答的 ORM 应区分。\n\n课堂页只读定性的关系:分布不同、等待与工作不同、依赖不同。Q37 的 128 格是机制示意,不拿研究原图替代主屏;Q38 用同一批对象做连续重排,不假装完成了测速。\n\n若进一步读 Figure 8,只能在同一种选择方法的曲线之间比较;难度估计中的 PRM 与这里选最终答案的 ORM 分工不同,不能混成同一个评分器。\n\n## 练习 N2:在既有搜索树上加两列\n\n这一页不新增 128 份模型生成实验,也不把生成次数改写成墙钟时间。练习沿用课堂同一棵搜索树,在原有记录上增加“工作计数”和“墙钟时间”两列,分开记录,再讨论两者为什么不能互相替代。\n\n| 层次 | 动作与变量 | 预测与核验 | 向自己的 AI 提问 | 可检查产出 |\n| --- | --- | --- | --- | --- |\n| 基础 | 用课堂同一完整树,逐轮只露当前可见节点。 | 先预测保留集合,再运行 Beam 宽度 2。 | 未展开的方向是已证错,还是尚未查看?逐轮列证据。 | 每轮可见/保留/未展开节点表。 |\n| 进阶 | 宽度 1/2/3;把 S3 分数 78 改 87。 | 预测哪次改变能保住通往 L31 的方向;数生成叶子与评分次数。 | 最终分更高而计算更多,怎样设计公平比较? | 配置/工作量/终点分/不能推出的结论。 |\n| 挑战 | 完整恢复旧 Q16 的 Best-of-N、Beam、分组三规则。 | 同预算约束下自己定义比较,区分排序分与真实检查。 | 如果中途评分会错,在哪个地方加保留机制最值得测试? | 一个明确保留规则、逐轮轨迹和反例。 |\n\n延伸记录:在原有搜索树练习的同一张表上增加两列——“工作计数”(生成了多少叶子、评分了多少次)与“墙钟时间”(实际等待了多久)。两列分开填写:工作计数不因并行而减少,墙钟时间可能因并行而缩短;峰值同时占用另记一列。所有树分是课堂给定排序分,不是概率、PRM 实测或全知正确率。旧 Q16 的完整分析不删除,继续留在本实验与 R-2。上述延伸不扩建 128 份模型生成实验,也不把不同单位加成一个金额。\n\n## 来源\n\n- Charlie Snell, Jaehoon Lee, Kelvin Xu, Aviral Kumar, *Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters*, arXiv:2408.03314v1, [论文与 Figure 7](https://arxiv.org/html/2408.03314v1)\n\nQ38 · 总工作与等待时间\n 3 态 · 纸面预算 180 秒 · 课堂构造,不是实测\n\n\n\n[逐页目录](#page-index) · [返回 Q39 课堂](index.html#/Q39/b0) · 实验 [LAB04](labs.html#LAB04)\n\n# 现在继续做什么?\n\n分页的两个方案都通过了列明的检查。这并不自动告诉我们下一步该做什么。本页把“还能继续生成”与“已经有足够证据交付”放在一起比较:在本次“本地修补、不部署”的委托里,继续生成十个补丁,还是整理补丁、证据与缺口,哪一个更接近可复查的交付。\n\n## 本页要建立的判断\n\n本页的判断不是“停止总是更好”,也不是“线上未知就永远不能停”。它要求把停止的理由、完成的范围和仍未验证的部分一起写下来。\n\n### 本页会区分\n\n- 检查通过,和本次是否采用;\n\n- 列明范围内的证据,和对所有输入的保证;\n\n- 停下来,和已经把问题全部解决;\n\n- 本地修补与检查,和线上此刻的状态。\n\n### 本页不主张\n\n- 不主张 C 没有通过,或 C 是错误方案;\n\n- 不主张线上已经被验证;\n\n- 不主张停止等于成功;\n\n- 不主张因为还有未知,就必须无限工作。\n\n## 为什么“通过但未采用”不是错误\n\n检查通过描述的是这个方案在列明输入上的表现;采用描述的是本次交付选哪一个。两者不是同一个判断。\n\nC 通过检查,说明它没有在这些列明输入上失败;本次没有采用它,只说明在 A 与 C 都能通过时,A 的改动更小,更适合这次本地修补。把 C 说成错误,会掩盖真正的证据:两个方案都通过;选择 A 是范围与改动量的取舍,不是对 C 的否定。\n\n同样,A 被采用也不等于 A 对所有输入都正确。它只说明在本次列明检查里,A 足以支持这次范围内的交付。\n\n## 停止的两种理由\n\n### 一、证据足够\n\n在事先列明的检查范围内,示例、反例和组合都支持当前方案;未知部分被明确写出。此时即使预算还有剩余,也可以停。\n\n### 二、预算或期限已到\n\n时间或预算先用尽,问题还没完全解决。此时同样要停,但必须把完成部分、未完成部分和缺口写清楚。\n\n第一种停止是“范围内证据足够”,不是“所有输入都已证明”。第二种停止是“期限到了”,不是“问题解决了”。两种都要避免把停止写成成功。\n\n线上状态未知,不要求无限工作;本次没有部署,也没有线上核验材料,这个空白不能在本地用更多补丁填上。有新证据时可以再接着做。停下来交出可靠的当前状态,比把剩余时间都花在重复解释上更有用。\n\n## 交付卡怎样被复查\n\n四行分别回答四个问题:改了什么;检查覆盖了什么;为什么采用这个方案;还有什么没有验证。\n\n- **改动:**停止边界 `len(items) − 1 → len(items)`。\n\n- **检查:**示例、反例与列明的组合。\n\n- **采用:**A / C 均通过;本次取改动较小的 A。\n\n- **未验证:**线上此刻;检查范围外输入。\n\n这张卡的价值在于让别人能够复查,而不是只能相信一句“我认真检查过了”。\n\n## 研究范围与练习边界\n\n分页案例放在“本地修补、不部署”的委托里。它检验的是:在已经有通过方案、但没有线上核验材料时,会不会把“继续生成”误当成默认的下一步,会不会把“停止”误当成成功。\n\n下面两组练习把同一种判断迁移到分页反例和超时交付:下一步应选择能减少关键未知的行动,并留下可复核的依据。\n\n练习中的数字只在该构造内有效;它们是课堂构造,不是生产测量。真实服务、真实日志和线上配置不在这些练习的证明范围内。\n\n## 分层练习\n\n### N1 · 分页反例与覆盖\n\n先用小输入暴露边界,再扩大组合,最后写覆盖论证。每一步都要先预测,再运行或核对。\n\n| 层次 | 动作与变量 | 预测与核验 | 向自己的AI提问 | 可检查产出 |\n| --- | --- | --- | --- | --- |\n| 基础 | n=0–6,size=2;先列range起点,再跑原函数 | 逐个预测漏哪条,比较返回值 | 请分别列出n=4和5的起点,不要直接告诉我答案 | n/起点/返回值/契约违反项四列表 |\n| 进阶 | n=0–20,size=1–8,比较A/B/C/B1 | 先猜B与B1何时重复、何时越界;跑168组合 | B加非空守卫后,为什么四项输入仍可能错?给最小反例 | A/C=168、B=56、B1=64的复核结果及失败条件;这些数字只限该构造 |\n| 挑战 | 不增加样本,写A的覆盖论证 | 相邻切片首尾相接;处理空列表与size>0 | 我的论证在哪一步用到了正整数步长和输入不变假设? | 论证+假设清单+测试不能替代的部分 |\n\n保持明确契约:顺序不变、不漏不重、页大小不超size且仅尾页可不满、不改输入、空输入返回`[]`。课堂按用到的顺序展开,实验开头必须全部写明。\n\n### N4 · 超时迁移与证据交付\n\n先用虚拟钟看清重试起点与期限,再讨论边界约定,最后把“观察、机制、缺口”分开交付。\n\n| 层次 | 动作与变量 | 预测与核验 | 向自己的AI提问 | 可检查产出 |\n| --- | --- | --- | --- | --- |\n| 基础 | 名义响应300ms、每次期限200ms、退避50ms;重试开5次/关1次 | 预测全局起点和返回时刻,再跑虚拟钟 | 为什么五个200不能直接相加得到最终时刻? | 0/250/500/750/1000起点及200/450/700/950/1200期限图 |\n| 进阶 | 响应150/200/250ms;退避0/100ms | 先规定恰好等于期限时的事件顺序,再运行 | 边界200ms是模型规则还是自然规律?不同事件顺序会怎样? | 参数/请求数/结果表,明确等号约定 |\n| 挑战 | 整体期限1500ms,总尝试上限N包括首次 | 规则:只启动能在整体期限前完成的一轮;固定300/200/50且N≥6,可完成6次超时,第6次1250→1450,无成功响应 | 这只证明机制,真实服务还缺哪些日志和配置? | 观察/机制/缺口三段交付,不改线上 |\n\n该模型无网络、不复现真实服务。300ms是名义响应,不证明真实后端耗时;1500ms是教学设定,和1200ms最终返回不是同一概念。\n\n## 承转\n\n分页的材料相对齐全。现在换成一个材料不齐的问题,检验我们会不会选择下一步。\n\n\n\n[逐页目录](#page-index) · [返回 Q40 课堂](index.html#/Q40/b0) · 实验 [LAB04](labs.html#LAB04)\n\n# 下一步先增加什么信息?\n\n客户端只报告 R17 超时。本页不先问“原因是什么”,而问:四个候选动作分别会补上哪类信息?读日志给情境事实,本地模型给机制可能;重写解释不产生新条件,加线上服务器超出本次委托,也缺少容量证据。“先记录后模型”只针对当前材料,不是通用故障流程。\n\n## 本页要建立的判断\n\n“先增加什么信息”不是“先选一个最像原因的答案”。四个候选动作并不是四个互斥的原因;它们补充的证据类型不同,其中读日志和本地模型都可能有用。\n\n### 本页会区分\n\n- 情境事实:这个情境里实际记录了什么;\n\n- 机制可能:在设定条件下,某个机制能不能发生;\n\n- 没有新增材料,和超出委托、缺少依据;\n\n- 本案例的选择顺序,和通用故障流程。\n\n### 本页不主张\n\n- 不主张读日志就能直接证明根因;\n\n- 不主张本地模型复现了真实服务;\n\n- 不主张加服务器在任何情况下都无用;只主张它在本案例中越界且缺证据;\n\n- 不主张“先记录后模型”适用于所有故障。\n\n## 四个动作各补什么信息\n\n这张表不是说四个动作有四个“正确答案”,而是说它们补的证据类型不同。读日志和本地模型都可能有帮助,只是回答的问题不同;两种动作可以并存。\n\n| 动作 | 它回答的问题 | 证据类型 | 不能证明什么 |\n| --- | --- | --- | --- |\n| 把两种解释再写一遍 | 能不能把已有说法整理得更清楚 | 表达整理,不是新证据 | 不能产生线上事实,也没有引入新的条件 |\n| 读 R17 的尝试记录 | 这个情境里实际记录了几次尝试 | 情境事实 | 不能单独证明是单次慢还是重试放大;受日志字段与授权范围限制 |\n| 本地模型只改重试开关 | 在设定条件下,重试能否造成请求放大 | 机制可能 | 不能证明真实服务发生了同样的放大;参数是教学设定 |\n| 直接给线上加服务器 | 是否要改变线上容量 | 超出本次委托,且缺少容量证据 | 不能作为本案例的下一步;也不证明容量永远不是问题 |\n\n这里最容易混淆的是“情境事实”和“机制可能”。日志说的是这个情境里记录了什么;模型说的是在设定条件里能不能发生。两者都不能单独给出完整因果链,但它们回答的问题不同,所以不能互相替代。\n\n## 为什么先读记录,再做机制对照\n\n这次先读已有记录,因为它能决定哪一条线索值得优先查。记录里实际发生了几次尝试,会改变下一步先查什么。随后再用本地模型检查一个机制,是把“可能”与“已记录”分开:先看这个情境里有什么,再看设定条件下能不能发生。\n\n但这不是通用流程。若原本就有充分日志,下一步可能不同;若日志读取不在授权范围内,应先说明缺口,而不是自行取得。这个顺序只针对当前材料,不是一条所有故障都适用的流程。\n\n日志访问需要授权。本案例的委托只允许读指定日志、做本地机制检查,不允许直接改线上配置。授权范围之外的动作,即使技术上做得到,也不属于本次可选的下一步。\n\n## 两种解释可以同时成立\n\n单次操作本身慢,和重复尝试放大请求,不是互斥选项。一次请求可能本来就很慢,同时重试又让请求变多。把两者当成二选一,会迫使学生在没有证据时先宣布一个原因。\n\n所以本页不问“哪一个是唯一原因”,而问“这个动作会补哪类信息”。读日志回答“这个情境里实际记录了几次尝试”,本地模型回答“在设定条件下重试能不能放大请求”。这两种信息可以同时有用;它们不互相取消。\n\n## 研究范围与边界\n\n本页是教学构造,不是一次真实线上故障的复现;没有真实后端耗时或线上日志作为证据。N4 的本地模型无网络、不复现真实服务。300ms 是名义响应,200ms 是每次期限,50ms 是退避,1500ms 是教学设定的整体期限;这些数字不是真实后端测量。\n\n1500ms 的整体期限,和 1200ms 的最终返回,不是同一个概念:前者是模型规则,后者是设定条件下的一次计算结果。模型能证明某个机制在设定规则下可能发生,不能证明真实服务就是那样。\n\n日志访问需要授权;本页的委托只覆盖指定日志与本地机制检查。模型参数、退避和期限都是教学设定,不是生产配置,也不代表线上真实行为。\n\n## 分层练习\n\nN4 基础层先预测不同动作会提供什么证据,再读取文件;不要求先学完整分布式系统。下面三层来自本页的阅读补充材料,用于把“记录”和“机制”分开核对。\n\n| 层次 | 动作与变量 | 预测与核验 | 向自己的AI提问 | 可检查产出 |\n| --- | --- | --- | --- | --- |\n| 基础 | 名义响应300ms、每次期限200ms、退避50ms;重试开5次/关1次 | 预测全局起点和返回时刻,再跑虚拟钟 | 为什么五个200不能直接相加得到最终时刻? | 0/250/500/750/1000起点及200/450/700/950/1200期限图 |\n| 进阶 | 响应150/200/250ms;退避0/100ms | 先规定恰好等于期限时的事件顺序,再运行 | 边界200ms是模型规则还是自然规律?不同事件顺序会怎样? | 参数/请求数/结果表,明确等号约定 |\n| 挑战 | 整体期限1500ms,总尝试上限N包括首次 | 规则:只启动能在整体期限前完成的一轮;固定300/200/50且N≥6,可完成6次超时,第6次1250→1450,无成功响应 | 这只证明机制,真实服务还缺哪些日志和配置? | 观察/机制/缺口三段交付,不改线上 |\n\n### 基础层的本页核对\n\n先预测,再读取文件:读日志、本地模型、重写解释、加服务器,各会补上哪类信息?把判断写在读取之前,不要先看答案。\n\n- 先预测:读日志会补什么?本地模型会补什么?重写解释会补什么?加服务器会补什么?\n\n- 再读取:只读十行指定日志;用 `attempt_id` / `receiver` 核对五次 timeout 是否五次尝试。\n\n- 产物:一个带字段引用的判断,以及两个仍缺的事实。\n\n向自己的AI提问:“哪一列改变了你的判断?若移走它,结论还成立吗?”\n\n### 进阶与挑战\n\n进阶:在虚拟时钟模型中分别改响应时间、每次期限、退避与最大次数;一次只改一项,先画前两次的起点与期限,再运行核验。产物是预测表、实际表与差异解释;不用网络、不改线上。向自己的AI提问:“你的200是时长还是全局时刻?你的总时长有没有漏退避?”\n\n挑战:加入整体期限1500ms,明确总尝试次数包含首次,并规定只启动能在整体期限前完成的一轮;在固定300/200/50ms、N≥6时核验第6次1250→1450,仍无成功响应。产物是时间线,以及观察/机制/缺口三段交付。向自己的AI提问:“这条结论来自日志、来自你新设的规则,还是两者都不支持?”\n\n可选扩展才定义取消或迟到响应规则,比较相同客户端超时下的不同后端模型;它不是本轮必做或课堂新增内容。练习中的数字只在该构造内有效,不是生产测量。\n\n## 承转\n\n记录里出现五次timeout,是一次超时打印了五遍,还是五次不同尝试?靠字段判断。\n\n\n\n[逐页目录](#page-index) · [返回 Q41 课堂](index.html#/Q41/b0) · 实验 [LAB04](labs.html#LAB04)\n\n# 一条请求,几次尝试?\n\n这一页只做一件事:把一条超时记录读成“一个逻辑请求下的多次尝试”,再据此调整排查优先级。它不把 timeout 直接当根因,也不把客户端结束等待说成后端已经停止。\n\n## 这一页在教什么\n\n先读一对记录,再展开十行;先确认 `request_id` 把记录串成同一个逻辑请求,再用 `attempt_id` 把记录分成不同尝试。最后才更新排查优先级:重复尝试值得先查,单次操作慢仍不能排除;后端分段耗时、谁发起重试与配置仍是缺口。\n\n### 学生要能做出的判断\n\n- 同一 `request_id` 不等于同一次尝试。\n\n- `attempt_id` 为 a1–a5 时,记录支持“五次不同尝试”。\n\n- `receiver` 与 `event` 说明每条记录来自哪里、发生了什么。\n\n- 客户端 `timeout` 只说明客户端结束等待。\n\n### 本页不作出的判断\n\n- 不宣布根因,不给置信度百分比。\n\n- 不排除单次操作慢。\n\n- 不从客户端 timeout 推断后端取消。\n\n- 不补出记录里没有的后端分段耗时或重试配置。\n\n## 完整日志:10 行、6 列、同一相对毫秒\n\n这份日志是教学构造,不是真实生产日志。十行共用一条相对毫秒时间轴,不按每行归零;字段名同时给出中文含义与原字段名。\n\n| 相对毫秒t_ms | 逻辑请求request_id | 尝试attempt_id | 记录位置receiver | 事件event | 结果outcome |\n| --- | --- | --- | --- | --- | --- |\n| 0 | R17 | a1 | gateway | received | — |\n| 200 | R17 | a1 | client | finished | timeout |\n| 250 | R17 | a2 | gateway | received | — |\n| 450 | R17 | a2 | client | finished | timeout |\n| 500 | R17 | a3 | gateway | received | — |\n| 700 | R17 | a3 | client | finished | timeout |\n| 750 | R17 | a4 | gateway | received | — |\n| 950 | R17 | a4 | client | finished | timeout |\n| 1000 | R17 | a5 | gateway | received | — |\n| 1200 | R17 | a5 | client | finished | timeout |\n\n读法:每一对是同一个尝试的 `gateway received` 与 `client finished timeout`。五对共享一个 `request_id`,但 `attempt_id` 不同。记录没有说明后端是否在客户端结束等待后继续执行,也没有说明每一次尝试的实际总耗时。\n\n## 这份记录支持什么,不支持什么\n\n### 支持\n\n- 同一 `request_id` 下出现五个不同 `attempt_id`:a1–a5。\n\n- 每个尝试都有一条 `gateway received` 与一条 `client finished timeout`。\n\n- 重复尝试值得优先检查,因为记录直接显示同一逻辑请求被多次发起。\n\n- 单次操作慢仍可能与重复尝试同时存在。\n\n### 不支持\n\n- 不能证明后端没有继续执行,也不能证明后端已经取消。\n\n- 不能给出后端、数据库各段的耗时,因为记录没有分段。\n\n- 不能说明重试由哪一层发起、最多几次、退避如何配置。\n\n- 不能据此宣布根因,也不应编一个置信度百分比。\n\n## N4 分层练习\n\n以下练习只使用本页记录或本地虚拟钟,不联网、不改线上。基础层先交出支持结论的字段;进阶层再加入缺失或重复日志,说明结论何时不能成立;挑战层检查整体期限下的尝试次数。\n\n| 层次 | 动作与变量 | 预测与核验 | 向自己的 AI 提问 | 可检查产出 |\n| --- | --- | --- | --- | --- |\n| 基础 | 名义响应 300ms、每次期限 200ms、退避 50ms;重试开 5 次/关 1 次 | 预测全局起点和返回时刻,再跑虚拟钟 | 为什么五个 200 不能直接相加得到最终时刻? | 0/250/500/750/1000 起点及 200/450/700/950/1200 期限图 |\n| 进阶 | 响应 150/200/250ms;退避 0/100ms;再加入缺失行与重复打印行 | 先规定恰好等于期限时的事件顺序,再运行;分别判断结论是否仍成立 | 边界 200ms 是模型规则还是自然规律?不同事件顺序会怎样? | 参数/请求数/结果表,明确等号约定;缺失或重复日志下的判断 |\n| 挑战 | 整体期限 1500ms,总尝试上限 N 包括首次 | 规则:只启动能在整体期限前完成的一轮;固定 300/200/50 且 N≥6,可完成 6 次超时,第 6 次 1250→1450,无成功响应 | 这只证明机制,真实服务还缺哪些日志和配置? | 观察/机制/缺口三段交付,不改线上 |\n\n### 基础:先交出字段\n\n只读十行日志,先预测“五次 timeout 是否足以证明五次尝试”,再用 `attempt_id` 与 `receiver` 核对。产物是一个带字段引用的判断,以及两个仍缺的事实。向 AI 提问:“哪一列改变了你的判断?若移走它,结论还成立吗?”\n\n### 进阶:缺失与重复日志\n\n在十行记录上加入缺失行或重复打印行:例如删掉一条 `gateway received`,或把同一条 `client finished timeout` 打印两次。分别判断“五次不同尝试”的结论是否仍成立,并说明缺哪一列、重复哪一行时结论不能成立。再在虚拟钟模型中一次只改响应时间、每次期限、退避或最大次数中的一项,先画前两次的起点与期限,再运行核验。产物是预测表、实际表、差异解释,以及一句明确的失效条件。向 AI 提问:“你的 200 是时长还是全局时刻?你的总时长有没有漏退避?”\n\n### 挑战:整体期限与尝试上限\n\n加入整体期限 1500ms,明确总尝试次数包含首次,并规定只启动能在整体期限前完成的一轮。在固定 300/200/50ms、N≥6 时核验第 6 次 1250→1450,仍无成功响应。产物是时间线与观察/机制/缺口三卡交付。可选的扩展才定义取消或迟到响应规则,比较相同客户端超时下的不同后端模型;它不是本轮必做或课堂新增内容。向 AI 提问:“这条结论来自日志、来自你新设的规则,还是两者都不支持?”\n\n## 研究与时点边界\n\n- 300ms 是名义响应,不证明真实后端耗时;1500ms 是教学设定,和 1200ms 最终返回不是同一概念。\n\n- 虚拟钟模型无网络、不复现真实服务;十行日志是教学构造,不是真实生产日志。\n\n- 客户端 `timeout` 只说明客户端结束等待;记录没有后端取消或停止的证据。\n\n- 本页只调整排查优先级,不宣布根因,不编置信度百分比。\n\n\n\n[逐页目录](#page-index) · [返回 Q42 课堂](index.html#/Q42/b0) · 实验 [LAB04](labs.html#LAB04)\n\n# 只改重试开关,会怎样?\n\n这一页把问题收进一个规则已知的虚拟时钟:没有网络,也不发真实请求。只改重试开关,其余条件不动,看看请求次数和单次超时分别会怎样。300 毫秒是名义响应,不是线上实测;1200 与 1500 也不是同一个概念。\n\n## 这页在检查什么\n\n它检查的是一件很窄的事:在固定条件下,重试怎样改变请求数量,以及关闭重试是否会自动让单次超时消失。它不检查线上服务的真实耗时,不定位根因,也不提供修改线上配置的依据。\n\n## 四个固定条件\n\n- **名义响应 300 ms**:一次请求名义上需要的时间。它是模型里的名义值,不是观测到的真实后端耗时。\n\n- **每次等待期限 200 ms**:每一次尝试从自己的起点开始等待 200 毫秒,到了就以客户端超时结束。200 是时长,不是所有尝试共同的截止时刻。\n\n- **失败后退避 50 ms**:一次超时之后先等 50 毫秒,下一次尝试才启动。\n\n- **重试开关**:开时最多 5 次总尝试,包含第一次;关时只有 1 次。5 不是“5 次重试再加第一次”。\n\n另有整体交付期限 1500 毫秒。它是另给的教学设定,只作为共同轴的末端和后续挑战的条件,不是第五次尝试的期限,也不是客户端最终返回的时刻。\n\n## 时间轴怎样算出来\n\n页面里的表不是手画的坐标,而是从 300/200/50 和 ON 5 / OFF 1 推导出来的。规则只有三条:\n\n- 每次期限 = 该次起点 + 200。\n\n- 每次名义响应 = 该次起点 + 300。\n\n- 下一次起点 = 上一次期限 + 退避 50。\n\n从 0 开始代入,开着重试得到五行:\n\n- a1:起点 0,期限 200,名义响应 300。\n\n- a2:起点 250,期限 450,名义响应 550。\n\n- a3:起点 500,期限 700,名义响应 800。\n\n- a4:起点 750,期限 950,名义响应 1050。\n\n- a5:起点 1000,期限 1200,名义响应 1300。\n\n关闭重试只保留 a1:起点 0,期限 200,名义响应 300。ON 的最终返回是 1200,OFF 是 200;两者都早于整体期限 1500。模型用固定期望值核对这些行,并检查每次期限与名义响应的差值、相邻起点之间的退避,以及 5 次总尝试包含第一次。\n\n还要分清两件事:五次 200 不能直接相加得到 1200,因为每次 200 都从该次自己的起点算;1200 之所以出现,是因为前四次超时后各插入 50 毫秒退避,起点被推到 1000,再加 200。名义响应是虚线终点,不是已经发生的真实响应。\n\n## 这页的边界\n\n- 模型不发真实请求、不调用模型、不联网;它是确定性虚拟时钟。\n\n- 名义响应 300 是规则给定的值,不证明真实后端耗时。虚线只表示名义时刻,不是观察到的晚到响应。\n\n- 模型没有定义取消与迟到响应。客户端 200 毫秒返回超时,不等于后端已经停止、取消或没有完成。\n\n- 1200 是第五次超时的时刻;1500 是另给的整体期限,两者不是同一个概念。\n\n- 这张机制对照没有定位线上根因,也不是修改线上重试配置的依据。\n\n## N4 进阶:超时迁移与证据交付\n\n这页的练习分三层。基础层读记录,进阶层改虚拟模型,挑战层加入整体期限。三层都不联网、不改线上。\n\n### 基础:先预测,再核对\n\n- 动作:只读十行日志,先预测五次 timeout 是否足以证明五次尝试,再用 attempt_id 与 receiver 核对。\n\n- 产物:一个带字段引用的判断,以及两个仍缺的事实。\n\n- 向自己的 AI 提问:“哪一列改变了你的判断?若移走它,结论还成立吗?”\n\n### 进阶:一次只改一项\n\n- 动作:在虚拟时钟模型里分别改响应时间(150/200/250 ms)、每次期限、退避(0/100 ms)与最大尝试次数。一次只改一项。\n\n- 预测与核验:先画前两次的起点与期限,再运行虚拟钟核对;特别先规定“恰好等于期限”时的事件顺序。\n\n- 产物:预测表、实际表、差异解释。不用网络,不改线上。\n\n- 向自己的 AI 提问:“你的 200 是时长还是全局时刻?你的总时长有没有漏退避?等号那一刻,是先超时还是先收到响应?”\n\n### 挑战:整体期限与第 6 次尝试\n\n- 动作:加入整体期限 1500 ms,明确总尝试次数包含第一次,并规定“只启动能在整体期限前完成的一轮”。\n\n- 核验:固定 300/200/50,令总尝试上限 N ≥ 6。第 6 次起点为 1250,期限为 1450;它仍以超时结束,没有成功响应。1450 早于 1500,所以这一轮可以启动。\n\n- 产物:时间线,以及“观察/机制/缺口”三卡交付。不改线上。\n\n- 向自己的 AI 提问:“这条结论来自日志、来自你新设的规则,还是两者都不支持?”\n\n- 可选扩展:先定义取消或迟到响应规则,再比较相同客户端超时下的不同后端模型。没有定义之前,不把未定义行为当成事实;这不是本轮必做内容。\n\n1500 毫秒沿用既有教学约束。版本变化与旧参数只留在备课记录,不回写成当前页的新事实。\n\n## 承转\n\n把刚才的日志、机制对照和仍缺的材料,分开写进交付。\n\n## 来源\n\n- 完整原稿:https://app.notion.com/p/40a298d59b078163bf05f117a86a2a12\n\n- 阅读补充(N4 分层与历史时点):https://app.notion.com/p/40a298d59b0781f0bd0ef313cdee5188\n\n机制解释与练习需要同时核对:用了什么假设、实际观察到什么、还有什么结论不能推出。\n\n\n\n[逐页目录](#page-index) · [返回 Q43 课堂](index.html#/Q43/b0) · 实验 [LAB04](labs.html#LAB04)\n\n# 三张卡,怎样交付?\n\n本页的 R17 日志与规则模型均为课堂构造,并非真实生产观测。这一页只做一件交付:把一条超时记录、一次本地机制对照和仍未补齐的事实,分成三张可核对的卡。三张卡不是三种语气,而是三种来源。判断时要分别核对:什么来自指定记录,什么只在规则模型中成立,还有什么尚未知道。\n\n## 这一页在教什么\n\n问题不是“哪句话听起来最像结论”,而是“这句话是从哪里来的,它能支持到哪一步”。观察来自记录,机制来自一个规则已知的本地模型,缺口说明还缺什么、没有做什么。把三者分开,下一次换一个人接手时,才知道哪些事实可以继续用,哪些仍需补。\n\n### 学生要能做出的判断\n\n- 第一张是观察:指定日志里有五个不同的 `attempt_id`,每次客户端都报告超时。\n\n- 第二张是机制:本地模型只改重试开关,请求从五次变一次,超时仍在。\n\n- 第三张是缺口:还缺后端分段耗时和实际重试配置,而且没有改线上。\n\n- 三张卡按来源分开,不按语气强弱排序。\n\n### 本页不作出的判断\n\n- 不把本地机制成立当成线上根因已经找到。\n\n- 不把五次 `timeout` 直接当成后端已经停止或取消。\n\n- 不补出记录和模型都没有提供的分段耗时、重试层或实际配置。\n\n- 不宣称线上已经修复,也不把三张卡揉成一个已经证实的故事。\n\n## 三张卡:来源不同,结论强度不同\n\n同一句“请求重复了”可能来自日志观察,也可能只是模型推演。把来源写清楚,才能决定结论能支持到哪里,下一步还应该取得什么证据。\n\n- 第一张 · 观察 来源:指定日志\n\nR17 有五个不同 `attempt_id`,每次客户端都报告超时。记录支持“同一个逻辑请求被多次发起,重复尝试值得优先检查”,但没有给出后端各段耗时,所以还不能说明时间花在哪里。\n\n- 第二张 · 机制 来源:本地规则模型\n\n本地模型固定 300 毫秒名义响应、200 毫秒每次期限、50 毫秒退避;只改重试开关,请求数从五变一,超时仍在。它说明“重复尝试会放大请求,但关掉重试不自动让响应变快”这个机制可以同时成立,不证明真实服务就是这个根因。\n\n- 第三张 · 缺口 来源:还缺什么/没有做什么\n\n下一步要取同一请求各段耗时和实际重试配置。在已允许的读取范围内就继续读,超出范围就说明缺口。本次没有改线上,也不宣称线上已修复。\n\n## 这页的边界\n\n### 三张卡支持的\n\n- 指定日志里同一个 R17 有五个不同 `attempt_id`,每次客户端都报告超时;重复尝试值得优先检查。\n\n- 本地模型里只改重试开关,请求从五变一,超时仍在;重复尝试与响应慢可以同时成立。\n\n- 下一步需要同一请求各段耗时和实际重试配置;没有改线上。\n\n### 三张卡不支持的\n\n- 不证明真实服务就是本地模型里的那个根因。\n\n- 不证明后端已经停止、取消或没有继续执行。\n\n- 不提供日志里没有的分段耗时、重试发起层或实际配置。\n\n- 不构成修改线上配置的依据,也不宣称线上已修复。\n\n本地模型无网络、不调用真实服务。300 毫秒是名义响应,不证明真实后端耗时;200 毫秒是每次等待期限,50 毫秒是失败后的退避;1500 毫秒是另给的整体教学期限。ON 的第五次尝试在 1200 毫秒返回 timeout,这是客户端最终返回时刻;1500 毫秒是另给的整体期限,两者不是同一个概念。\n\n## N4 挑战:三卡就是产物\n\n挑战的产物不是更长的报告,而是这三类交付:观察、机制、缺口。每张卡要附证据文件定位:观察卡指向日志文件与 `attempt_id` 所在行;机制卡指向模型参数与运行输出;缺口卡指向还没有拿到的配置项、文件或读取入口。找不到对应文件时,就把它写成缺口,不补一个看起来完整的故事。\n\n挑战的规则:整体期限 1500 毫秒;总尝试上限 N 包括首次;只启动能在整体期限前完成的一轮。固定 300/200/50,令 N≥6,可以完成六次超时:第六次从 1250 启动,期限 1450,仍没有成功响应。1450 早于 1500,所以这一轮可以启动。这个结果只证明机制,不证明真实服务的事实。\n\n“不要求写更长来显得深入”:三张卡各自把来源、支持和边界说清楚,就已经是挑战产物。加长文字不能替代证据文件定位。\n\n## 分层练习\n\n三层都只使用本页记录或本地虚拟钟,不联网、不改线上。基础层先分清观察与推断;进阶层在虚拟钟里一次只改一项;挑战层加入整体期限,交付三张卡。\n\n| 层次 | 动作与变量 | 预测与核验 | 向自己的 AI 提问 | 可检查产出 |\n| --- | --- | --- | --- | --- |\n| 基础 | 只读十行日志,不改模型 | 先预测“五次 timeout 是否足以证明五次尝试”,再用 `attempt_id` 与 `receiver` 核对 | 哪一列改变了你的判断?若移走它,结论还成立吗? | 一个带字段引用的判断,以及两个仍缺的事实 |\n| 进阶 | 名义响应 300ms、每次期限 200ms、退避 50ms;响应改 150/200/250ms,退避改 0/100ms,重试开 5 次/关 1 次 | 先规定“恰好等于期限”时的事件顺序,再跑虚拟钟;先画前两次的起点与期限 | 200 是时长还是全局时刻?总时长有没有漏退避?等号那一刻先超时还是先收到响应? | 预测表、实际表、差异解释;0/250/500/750/1000 起点与 200/450/700/950/1200 期限图 |\n| 挑战 | 整体期限 1500ms,总尝试上限 N 包括首次;固定 300/200/50,N≥6 | 只启动能在整体期限前完成的一轮;核验第六次 1250→1450,无成功响应 | 这条结论来自日志、来自你新设的规则,还是两者都不支持? | 时间线,以及观察/机制/缺口三卡交付;不改线上 |\n\n### 基础:先分清观察与推断\n\n十行日志就是 Q41 读过的 R17 构造记录;本页不重复展开。只读这十行,先预测“五次 `timeout` 是否足以证明五次尝试”,再用 `attempt_id` 与 `receiver` 核对。产物是一个带字段引用的判断,以及两个仍缺的事实。向自己的 AI 提问:“哪一列改变了你的判断?若移走它,结论还成立吗?”\n\n这一层要留下的不是“五次超时”这个数量,而是“同一个 R17 下出现了五个不同 `attempt_id`”这个字段事实。记录只说明客户端结束等待,不说明后端是否继续执行;后端分段耗时和重试配置仍是缺口。\n\n### 进阶:在虚拟钟里一次只改一项\n\n在虚拟钟模型中分别改响应时间(150/200/250ms)、每次期限、退避(0/100ms)与最大尝试次数;一次只改一项。先画前两次的起点与期限,再运行核验。特别先规定“恰好等于期限”时的事件顺序,再讨论不同事件顺序会怎样。产物是预测表、实际表、差异解释,不用网络、不改线上。\n\n固定 300/200/50 时,开着重试的五个起点是 0/250/500/750/1000,各次期限是 200/450/700/950/1200。为什么五个 200 不能直接相加得到最终时刻?因为每个 200 都从该次自己的起点算,前一次超时后还插入了 50 毫秒退避。向自己的 AI 提问:“你的 200 是时长还是全局时刻?你的总时长有没有漏退避?等号那一刻,是先超时还是先收到响应?”\n\n### 挑战:整体期限与三卡交付\n\n加入整体期限 1500ms,明确总尝试次数包含首次,并规定只启动能在整体期限前完成的一轮。在固定 300/200/50ms、N≥6 时核验第六次 1250→1450,仍无成功响应。产物是时间线与观察/机制/缺口三卡交付,不改线上。向自己的 AI 提问:“这条结论来自日志、来自你新设的规则,还是两者都不支持?”\n\n可选的扩展才定义取消或迟到响应规则,比较相同客户端超时下的不同后端模型;它不是本轮必做或课堂新增内容。没有定义之前,不把未定义行为当成事实。\n\n## 来源与动手入口\n\nR17 日志与固定时间规则均为教学构造,不能当作生产系统的实测报告。[LAB04:运行记录与超时机制](labs.html#LAB04)保留日志辨认、虚拟钟对照和整体期限练习;先写预测,再运行,再记录哪些结论仍不成立。相关解释见 [工具观测与可核验交付](handbook.html#R7)。\n\n\n\n[逐页目录](#page-index) · [返回 Q44 课堂](index.html#/Q44/c0) · 实验 [CLS00](labs.html#CLS00) · [CLS02](labs.html#CLS02) · [LAB04](labs.html#LAB04)\n\n# 下一份计算,减少哪项未知?\n\n先在新任务里作一次选择,再看到一条真正的新证据。原任务规则不变:证据会使我们重新判断哪些候选可用、哪里还缺检查。合理的初选不必被说成错误,但下一步必须回应新事实。随后回到分页与超时的两个缺口,把理由和证据范围留给下一次。\n\n\n\n## 新任务:修CSV导入,下一份预算怎么用?\n\n**教学构造,不是模型实测。** 原任务从一开始就要求:订单编号“0012”保留前导零;空金额保留为空;CSV引号内的逗号是字段内容,不应切开;不修改原文件。这四项要求在初选之前全部给出。\n\n现有检查只用了普通、不含引号逗号的字段,验证了前导零、空值和原文件未改。八个候选中三个通过这些检查,但排名器首选了一个连现有检查都未通过者。这里的“通过”只限定于列明检查,不能改写为“三个候选已正确”或“三个可交付答案”。\n\n先记录初选:增加候选、改善选择、补充检查、取得外部观测,还是研究训练?改善选择有直接依据,因为排序器错过了已通过者;补测原契约未覆盖的条件也有依据,因为通过范围有限。需要说明自己选择要区分什么未知,而不是猜教师心里的唯一答案。\n\n\n\n## 新证据:同一契约内,三个旧通过者全失败\n\n下一态揭晓未参加筛选的行:`0012,\"book, pen\",`。正确解析是三列:订单编号`0012`、备注`book, pen`、空金额。引号内逗号的规则不是揭晓时新加的,它已经在原契约内。\n\n课堂给定的新检查结果:原来三个通过者都把这一行拆成四列,因此三个均违反同一项原契约。这组结果是为练习证据更新而明确构造的,不能当成真实模型性能数据。共同失败条件已确定,但仅凭相同输出还不能断言三份代码的根因相同;需要检查实现或设计能区分机制的输入。\n\n回看自己的初选。修选择器仍能纠正原来的排序错误,但仅在八个候选里重新排一次,已经不足以支持交付。可以先把反例加入检查、定位共同失败条件,再修订或扩展候选;也可以把改选择保留为整体方案的一步。新输入若显示旧通过者失败,支持调整工作重点,并不强迫唯一行动或否定初选时的理由。\n\n请完成:“我原来选择__,因为__;新证据__使我保留/修改__;下一项实验__可以区分__。”一个反例不证明必须做模型训练。训练是否值得研究,还需要跨题重复出现的问题、可靠的反馈和独立评估。\n\n有限检查仍不等于对全部输入的证明。[LAB02](labs.html#LAB02)可固定候选/树,改变选择规则;[LAB03](labs.html#LAB03)比较同一检查信号的不同用途。CSV不是新增的正式Notebook,而是把已有判断方法迁移到未见任务的课堂练习。\n\n\n\n## 为什么接着学记忆、工具与Coding Agent\n\n参数不会自动记下每一次工作。若下一次仍要利用这次的契约、排除的方案和检查范围,就需要保存、检索并核对中间状态,这使“记忆”成为一个实际问题。已有材料推不出当前线上事实时,需要工具取得新观测;要让代码变成可复现反馈,又需要一个有明确边界的运行环境。Coding Agent 把这些能力接成求解—执行—反馈的工作闭环,但每一轮仍需判断何时继续、何时补信息、何时停止。\n\n一个课后小实验:把本页交接卡交给一个新AI会话,让它只依据卡片说出“已知、未知、下一项检查”;再去掉检查范围,比较它是否误把局部通过当成全域结论。它验证交接材料的充分性,不证明某种记忆系统已训练完成。\n\n## 两个缺口,各自补什么\n\n第一个缺口是“三个候选只过一个例子”。一个例子只能说明某个候选在这个输入上没有出错,不能把候选区分开。下一步要补的是能区分候选的反例:换一个输入,让不同候选给出不同结果,或者让某个候选暴露出违反契约的行为。它不是把同一个通过例子再跑十遍,也不是把原解释写得更长。\n\n第二个缺口是“线上此刻仍不知道”。已有日志、旧记录或本地模型都不能代替当前观测。下一步要补的是获准的当前观测:在允许的读取范围内,取同一请求此刻的分段耗时、实际重试配置或其他能缩小未知的材料;如果超出范围,就准确说明缺口,而不是用旧材料冒充今天的状态。\n\n两类补法不同,但判断方式是同一个:先问现在缺的是哪一种证据,再问哪一份计算或哪一次读取能让这项未知变少。课堂不要求背一套固定动作顺序,而要知道为什么此刻该选这一项。\n\n## 三行交接卡\n\nb1 的第二段把答案收束成一张短卡。它的用途不是总结今天所有名词,而是让下一次接手的人能复核:上次约定了什么、为什么这样选、哪些检查已经做过、还有什么仍然不知道。\n\n- 01\n\n### 契约与输入范围\n\n顺序不变、不漏不重、每页不超过 size 且只有尾页可以不满、不改输入、空输入返回 [];同时写清这次检查适用到哪些输入,避免下一次把局部结论当成全域结论。\n\n- 02\n\n### 采用 A;B 在四项/空输入上的反例\n\nA、C 都通过列明检查,本次取改动较小的 A。B 的反例是四项输入重复 D、空输入报错。理由和反例要一起留下,接手者才能复核,而不是只信一句“选 A”。\n\n- 03\n\n### 做过哪些检查;线上状态仍未知\n\n记下检查的时间与范围。旧日志不能自动证明明天的线上状态;接手时仍要重新核对材料的时间和范围,需要时再取获准的当前观测。\n\n这张卡可以迁移到分页和超时两个任务。下面两张卡把字段填成可重现的样子;详细字段属于阅读与课后练习。\n\n\n\n## N1:分页反例与覆盖\n\nN1 研究的是分页函数的契约与候选差异。课堂已经用过五项输入、四项反例和空输入;阅读层保留更完整的范围:不增加样本,写清覆盖论证;或者在更大的构造里复核候选差异。所有实验开头都要先写明契约。\n\nN1 交接卡\n\n可重现:下一次接手按字段复核,不只看结论\n\n对象分页函数 A、B、C、B1(课堂构造)\n\n契约顺序不变、不漏不重、每页不超过 size 且仅尾页可不满、不改输入、空输入返回 []。\n\n已查五项 size=2 为 [AB][CD][E];A、C 通过列明检查;B 在四项重复 D,在空输入报错。\n\n反例四项:D 已经在 [CD] 里,循环后又补一次;空输入:B 取 items[-1] 时没有对象可取。\n\n未知A、C通过三个输入本身不等于证明所有合法输入。Q19已给出A的覆盖论证:对有限列表、正整数size和稳定数据等前提成立;契约或运行环境改变后,仍需核对前提。\n\n下一步复述Q19的A覆盖论证:相邻切片首尾相接,处理空列表与size>0边界;再改变一个前提(如列表会在分页中变化),指出哪一步不能直接沿用、需要补哪项观测。\n\n时间与范围记下本轮检查的输入与时间。168/56/64 只限该大构造,不是普遍性能或正确性结论。\n\nB1 是给 B 加非空守卫的变体:空输入不再越界,但四项输入仍可能重复;守卫只补上一个缺口,不能替代新的反例。\n\n### N1 分层练习\n\n| 层次 | 动作与变量 | 预测与核验 | 向自己的 AI 提问 | 可检查产出 |\n| --- | --- | --- | --- | --- |\n| 基础 | n=0–6,size=2;先列出 range 起点,再跑原函数。 | 逐个预测漏哪一条,再比较返回值。 | 请分别列出 n=4 和 n=5 的起点,不要直接告诉我答案。 | n/起点/返回值/契约违反项四列表。 |\n| 进阶 | n=0–20,size=1–8,比较 A/B/C/B1。 | 先猜 B 与 B1 何时重复、何时越界;再跑 168 组组合。 | B 加非空守卫后,为什么四项输入仍可能错?给最小反例。 | A/C=168、B=56、B1=64 的复核结果及失败条件;这些数字只限该构造。 |\n| 挑战 | 不增加样本,写 A 的覆盖论证。 | 相邻切片首尾相接;处理空列表与 size>0。 | 我的论证在哪一步用到了正整数步长和输入不变假设? | 论证+假设清单+测试不能替代的部分。 |\n\n课堂按实际用到的顺序展开;实验开头必须把契约全部写明。阅读层的更大构造可在课后展开,不要求课堂全部演算。\n\n\n\n## N4:超时迁移与证据交付\n\nN4 把同一种判断迁移到超时。本地规则模型固定名义响应、每次期限和退避,只改重试开关或参数;它没有网络,也不复现真实服务。它的用途是让“哪一项未知会变少”变成可核对的预测,而不是替线上下结论。\n\nN4 交接卡\n\n可重现:区分日志观察、机制规则与仍缺的线上事实\n\n对象超时重试的本地规则模型(课堂构造)。\n\n设定名义响应 300ms、每次期限 200ms、退避 50ms;重试开 5 次/关 1 次。\n\n已查起点 0/250/500/750/1000;期限 200/450/700/950/1200;开=5 次超时,关=1 次超时。\n\n机制五个 200 不能直接相加;每次新一轮从退避之后重新计时,最终返回时刻是最后一轮的期限。\n\n未知真实后端各段耗时、实际重试配置;线上未读、未改。\n\n下一步在允许范围取同一请求的分段耗时与实际配置;超出范围就说明缺口,不用本地模型冒充线上观测。\n\n时间与范围旧日志和本地模型都不证明明天或线上的当前状态;接手时重新核对时间与范围。\n\n### N4 分层练习\n\n| 层次 | 动作与变量 | 预测与核验 | 向自己的 AI 提问 | 可检查产出 |\n| --- | --- | --- | --- | --- |\n| 基础 | 只读十行日志;先预测五次 timeout 是否足以证明五次尝试,再用 attempt_id/receiver 核对。 | 哪一列改变了判断;移走它,结论是否仍成立。 | 哪一列改变了你的判断?若移走它,结论还成立吗? | 一个带字段引用的判断,以及两个仍缺的事实。 |\n| 进阶 | 响应 150/200/250ms;退避 0/100ms;在虚拟时钟中分别改响应时间、每次期限、退避与最大次数,一次只改一项,先画前两次的起点/期限,再运行核验。 | 先规定恰好等于期限时的事件顺序,再运行;检查 200ms 是时长还是全局时刻、总时长有没有漏退避。 | 你的 200 是时长还是全局时刻?你的总时长有没有漏退避? | 预测表、实际表、差异解释;不用网络,不改线上。 |\n| 挑战 | 加入整体期限 1500ms;明确总尝试次数包含首次,只启动能在整体期限前完成的一轮;固定 300/200/50ms、N≥6,可完成 6 次超时。 | 核验第 6 次 1250→1450,仍无成功响应;说明这只证明机制,不代表真实服务。 | 这条结论来自日志、来自你新设的规则,还是两者都不支持? | 时间线,以及观察/机制/缺口三卡交付。 |\n\n可选扩展才定义取消或迟到响应规则,用于比较相同客户端超时下的不同后端模型,不是本轮必做或课堂新增内容。300ms 是名义响应,不证明真实后端耗时;1500ms 是教学设定,和 1200ms 的最终返回不是同一个概念。\n\n\n\n## 从问题进入研究与实验\n\n| 想继续追问的问题 | 正文 | 动手入口 |\n| --- | --- | --- |\n| 中间内容和先后顺序为什么重要? | [R1 · Scratchpad与CoT](handbook.html#R1) | [LAB01 · 分页反例](labs.html#LAB01) |\n| 如何分配搜索与选择预算? | [R2 · 搜索与保留规则](handbook.html#R2) | [LAB02 · 搜索取舍](labs.html#LAB02) |\n| 通过检查到底支持了什么? | [R3 · 验证与覆盖](handbook.html#R3) | [LAB01 · 契约与覆盖](labs.html#LAB01) |\n| 同一信号怎样改变以后? | [R4 · 反馈与学习](handbook.html#R4) | [LAB03 · 检查信号](labs.html#LAB03) |\n| R1-Zero提供了什么研究信号? | [R5 · 结果反馈与策略变化](handbook.html#R5) | [讲解本与四个实验导航](labs.html) |\n| 监控、授权与真实完成怎样区分? | [R6 · 过程与证据](handbook.html#R6) · [R7 · 超时与未知](handbook.html#R7) | [LAB04 · 超时与证据交付](labs.html#LAB04) |\n| 下一份计算应该减少哪项未知? | [R8 · 预算与下一次选择](handbook.html#R8) | [LAB02](labs.html#LAB02) · [LAB04](labs.html#LAB04) |\n\n## 科学与时点限制\n\n- CSV任务、N1/N4都是教学构造;不把它们误当真实线上服务、真实模型性能或正式系统验收。\n\n- 300ms 是名义响应,不证明真实后端耗时;1500ms 是教学设定,1200ms 是同一构造里重试开五次时的最终返回,两者不是同一个概念。\n\n- 168/56/64 只限 N1 的大构造;A、C 通过列明检查,不等于证明所有合法输入。\n\n- 旧日志与本地模型都不能自动证明明天或线上的当前状态;接手时要核对材料的时间和范围。\n\n## 继续学习\n\n先完成本页的初始选择、新证据揭晓和实际改判,再沿[现行完整学习正文](handbook.html)追溯依据,或把[完整AI阅读入口](ai.html)交给自己的AI。不要只给一张投影截图就要求它替你补齐全部研究背景。\n\n"}